
python爬取豆瓣小组700+话题加回复啦啦啦python open file with a variable name
需求:爬取豆瓣小组所有话题(话题title,内容,作者,发布时间),及回复(最佳回复,普通回复,回复_回复,翻页回复,0回复)
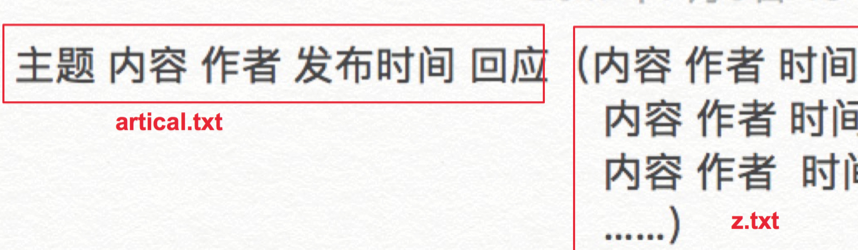
解决:1. 先爬取小组下,所有的主题链接,通过定位nextpage翻页获取总过700+条话题;
2. 访问700+ 链接,在内页+start=0中,获取话题相关的四部分(话题title,内容,作者,发布时间),及最佳回复、回复;
3. 在2的基础上,判断是否有回复,如果有回复才进一步判断是否有回复翻页,回复翻页通过nextpage 获取start=100、start=200的页;
4. 进入下一个爬取函数,将抓取的回复 续写 到2 中的文件;
解决思路:
Before:一开始建立2个文件,article.txt 用来存储所有话题相关的内容(700+话题、作者信息);
同时,建立以title命名的回复文件;
After: 统一建立以话题title命名的文章,先写入文章相关内容,再续写回复;这样方便读取;
遇到的坑:
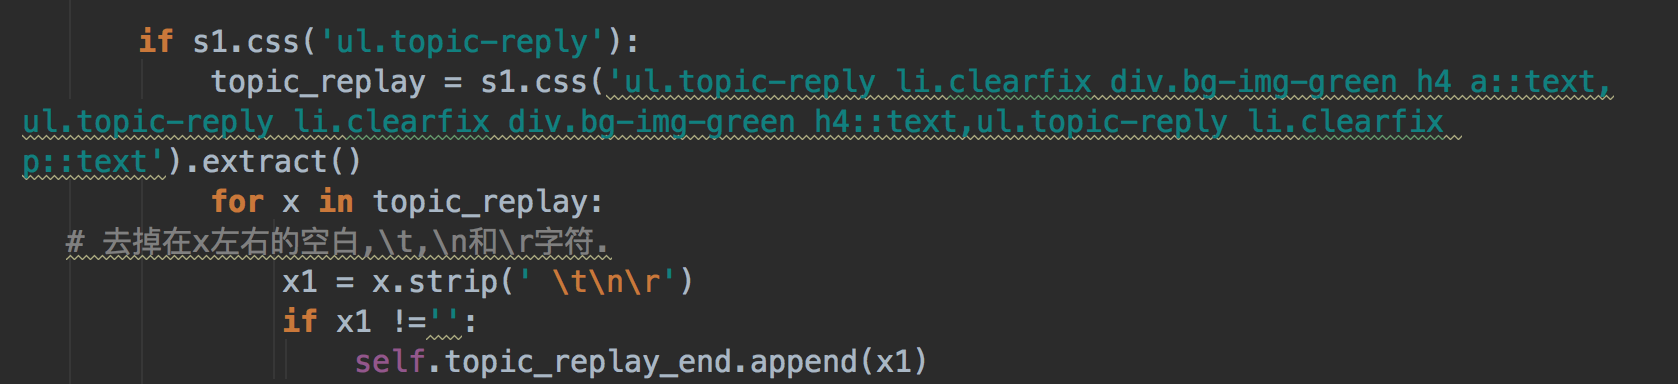
1. 要获取某个div下直接的text,div.span下的text,div.h下的text:
——有2个解决方法:
A. 通过xpath //text,意思是获取div 下的所有text文件;
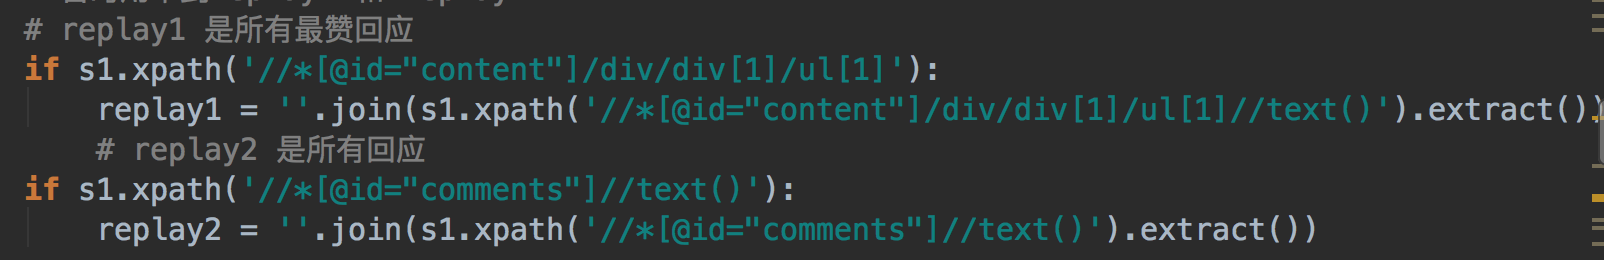
B. 通过css 拼接,逗号隔开即可:
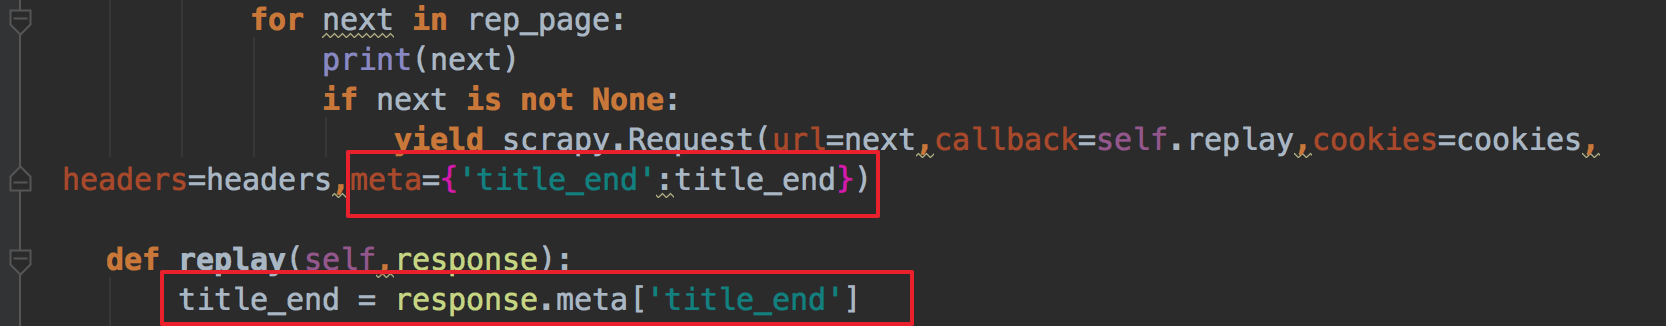
2. 巩固了不同函数之间通过meta传递参数的方法:
3. python open file with a variable name
f = open('%s.txt' % title_end,'a')
a: 续写
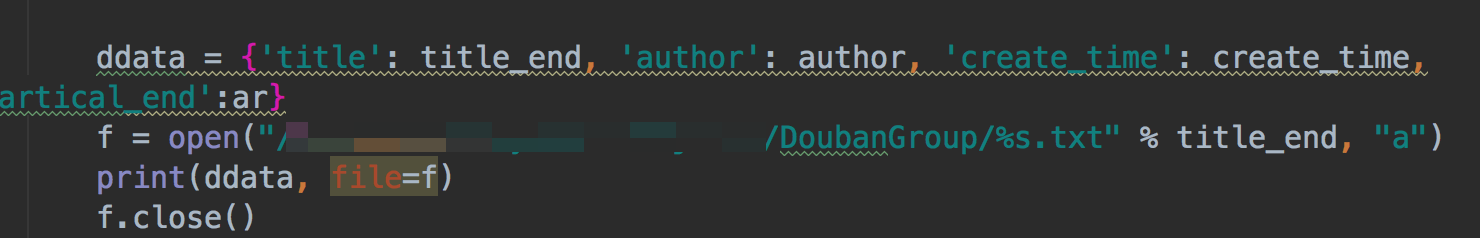
4.去掉 str 中的空格,换行等符号
# 去掉在x左右的空白,\t,\n和\r字符.
 x1 = x.strip(' \t\n\r')
5 . strip 去掉数据中的\r,''.join 将列表转回字符串;
# 先将文章中的\r 都去掉,有些单独的'\r' 就变成了空的列表元素:'',再用if 来判断下就好了
        artical_end = []
        for x in  article:
            x1 = x.replace('\r','')
            if x1 != '':
                artical_end.append(x1)
# 将artical_end 列表 转为字符串
        ar =''.join(artical_end)
python爬取豆瓣小组700+话题加回复啦啦啦python open file with a variable name的更多相关文章
- Python爬取豆瓣指定书籍的短评
Python爬取豆瓣指定书籍的短评 #!/usr/bin/python # coding=utf-8 import re import sys import time import random im ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- Python爬取豆瓣电影top
Python爬取豆瓣电影top250 下面以四种方法去解析数据,前面三种以插件库来解析,第四种以正则表达式去解析. xpath pyquery beaufifulsoup re 爬取信息:名称 评分 ...
- Python爬取豆瓣《复仇者联盟3》评论并生成乖萌的格鲁特
代码地址如下:http://www.demodashi.com/demo/13257.html 1. 需求说明 本项目基于Python爬虫,爬取豆瓣电影上关于复仇者联盟3的所有影评,并保存至本地文件. ...
- Python 爬取单个网页所需要加载的地址和CSS、JS文件地址
Python 爬取单个网页所需要加载的URL地址和CSS.JS文件地址 通过学习Python爬虫,知道根据正式表达式匹配查找到所需要的内容(标题.图片.文章等等).而我从测试的角度去使用Python爬 ...
- python爬取豆瓣视频信息代码
目录 一:代码 二:结果如下(部分例子) 这里是爬取豆瓣视频信息,用pyquery库(jquery的python库). 一:代码 from urllib.request import quote ...
- 零基础爬虫----python爬取豆瓣电影top250的信息(转)
今天利用xpath写了一个小爬虫,比较适合一些爬虫新手来学习.话不多说,开始今天的正题,我会利用一个案例来介绍下xpath如何对网页进行解析的,以及如何对信息进行提取的. python环境:pytho ...
- python 爬取豆瓣书籍信息
继爬取 猫眼电影TOP100榜单 之后,再来爬一下豆瓣的书籍信息(主要是书的信息,评分及占比,评论并未爬取).原创,转载请联系我. 需求:爬取豆瓣某类型标签下的所有书籍的详细信息及评分 语言:pyth ...
- python爬取豆瓣电影信息数据
题外话+ 大家好啊,最近自己在做一个属于自己的博客网站(准备辞职回家养老了,明年再战)在家里 琐事也很多, 加上自己 一回到家就懒了(主要是家里冷啊! 广东十几度,老家几度,躲在被窝瑟瑟发抖,) 由于 ...
随机推荐
- 【OI新闻】2016.10.06
今天有人说好多OJ都狗记邓了- 翻了一下,恭喜以下OJ赢得大奖,获得狗记邓徽章一枚 一等奖Codevs 二等奖Bzoj 三等奖洛谷 后记-感悟 如果正在为OJ发愁的朋友,不要悲伤,不要心急,换一换OJ ...
- 8 Range 对象
8.1 引用Range 引用Range的主要方法: Application.ActiveCell Application.Range Application.Selection Worksheet.C ...
- bzoj3670 [Noi2014]动物园——KMP
题目:https://www.lydsy.com/JudgeOnline/problem.php?id=3670 第一次写KMP算法...又T又WA了半天... 1. num 数组表示包括其本身的前缀 ...
- 使用inet_ntoa() 时编译提示错误:
char*inet_ntoa(struct in_addr in)将一个IP转换成一个互联网标准点分格式的字符串. 我把 inet_ntoa 需要的头文件加上去: #include <sy ...
- G41
https://downloadcenter.intel.com/zh-cn/product/81517/-G41-
- bzoj 1034: [ZJOI2008]泡泡堂BNB【贪心】
是贪心 先把两个数组排序,然后贪心的选让a数组占优的(如果没有就算输),这是最大值,最小值是2n-贪心选b数组占优 #include<iostream> #include<cstdi ...
- codeforces 402E - Strictly Positive Matrix【tarjan】
首先认识一下01邻接矩阵k次幂的意义:经过k条边(x,y)之间的路径条数 所以可以把矩阵当成邻接矩阵,全是>0的话意味着两两之间都能相连,也就是整个都要在一个强连通分量里,所以直接tarjan染 ...
- 线段树+树状数组+贪心 HDOJ 5338 ZZX and Permutations
题目传送门 /* 题意:不懂... 线段树+树状数组+贪心:贪心从第一位开始枚举,一个数可以是循环节的末尾或者在循环节中,循环节(循环节内部是后面的换到前面,最前面的换到最后面).线段树维护最大值,树 ...
- Using 10053 Trace Events and get outline
When it comes to performance tuning, we can spend time on one or both ends of the problem. On the &q ...
- LR接口测试---webservices
//================================================================================== /* //事务开始 lr_st ...