
Hive集成HBase详解

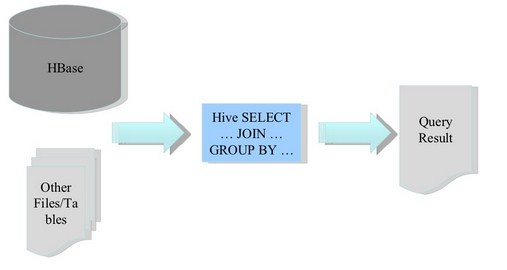
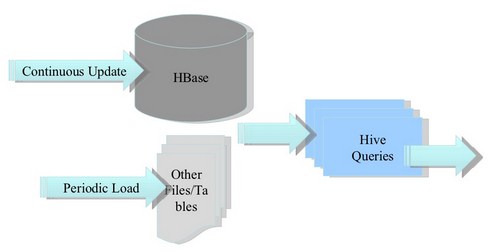
- 使用HQL语句创建一个指向HBase的Hive表
CREATE TABLE hbase_table_1(key int, value string) //Hive中的表名hbase_table_1

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'  //指定存储处理器

WITH SERDEPROPERTIES ("hbase.columns.mapping" = ":key,cf1:val") //声明列族,列名

TBLPROPERTIES ("hbase.table.name" = "xyz", "hbase.mapred.output.outputtable" = "xyz");

//hbase.table.name声明HBase表名,为可选属性默认与Hive的表名相同,

//hbase.mapred.output.outputtable指定插入数据时写入的表,如果以后需要往该表插入数据就需要指定该值
- 通过HBase shell可以查看刚刚创建的HBase表的属性
$ hbase shell

HBase Shell; enter 'help<RETURN>' for list of supported commands.

Version: 0.20.3, r902334, Mon Jan 25 13:13:08 PST 2010

hbase(main):001:0> list

xyz

1 row(s) in 0.0530 seconds

hbase(main):002:0> describe "xyz"

DESCRIPTION                                                           ENABLED

  {NAME => 'xyz', FAMILIES => [{NAME => 'cf1', COMPRESSION => 'NONE', VE true

  RSIONS => '3', TTL => '2147483647', BLOCKSIZE => '65536', IN_MEMORY =>

  'false', BLOCKCACHE => 'true'}]}

1 row(s) in 0.0220 seconds

hbase(main):003:0> scan "xyz"

ROW                          COLUMN+CELL

0 row(s) in 0.0060 seconds
- 使用HQL向HBase表中插入数据
INSERT OVERWRITE TABLE hbase_table_1 SELECT * FROM pokes WHERE foo=98;
- 在HBase端查看插入的数据
hbase(main):009:0> scan "xyz"

ROW                          COLUMN+CELL

 98                          column=cf1:val, timestamp=1267737987733, value=val_98

1 row(s) in 0.0110 seconds
- 创建一个指向已经存在的HBase表的Hive表
CREATE EXTERNAL TABLE hbase_table_2(key int, value string)

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'

WITH SERDEPROPERTIES ("hbase.columns.mapping" = "cf1:val")

TBLPROPERTIES("hbase.table.name" = "some_existing_table", "hbase.mapred.output.outputtable" = "some_existing_table");
- 建表或映射表的时候如果没有指定:key则第一个列默认就是行键
- HBase对应的Hive表中没有时间戳概念,默认返回的就是最新版本的值
- 由于HBase中没有数据类型信息,所以在存储数据的时候都转化为String类型
CREATE TABLE hbase_table_1(key int, value1 string, value2 int, value3 int)

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'

WITH SERDEPROPERTIES (

"hbase.columns.mapping" = ":key,a:b,a:c,d:e"

);

INSERT OVERWRITE TABLE hbase_table_1 SELECT foo, bar, foo+1, foo+2

FROM pokes WHERE foo=98 OR foo=100;
CREATE TABLE hbase_table_1(value map<string,int>, row_key int)

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'

WITH SERDEPROPERTIES (

"hbase.columns.mapping" = "cf:,:key"

);

INSERT OVERWRITE TABLE hbase_table_1 SELECT map(bar, foo), foo FROM pokes

WHERE foo=98 OR foo=100;
- 在HBase下查看数据
hbase(main):012:0> scan "hbase_table_1"

ROW                          COLUMN+CELL

 100                         column=cf:val_100, timestamp=1267739509194, value=100

 98                          column=cf:val_98, timestamp=1267739509194, value=98

2 row(s) in 0.0080 seconds
- 在Hive下查看数据
hive> select * from hbase_table_1;

Total MapReduce jobs = 1

Launching Job 1 out of 1

...

OK

{"val_100":100}    100

{"val_98":98}    98

Time taken: 3.808 seconds
CREATE TABLE hbase_table_1(key int, value map<int,int>)

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'

WITH SERDEPROPERTIES (

"hbase.columns.mapping" = ":key,cf:"

);
CREATE TABLE hbase_table_1(key int, value string)

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'

WITH SERDEPROPERTIES (

"hbase.columns.mapping" = ":key,cf:"

);
CREATE EXTERNAL TABLE delimited_example(key struct<f1:string, f2:string>, value string)

ROW FORMAT DELIMITED

COLLECTION ITEMS TERMINATED BY '~'

STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'

WITH SERDEPROPERTIES (

  'hbase.columns.mapping'=':key,f:c1');
- 对HBase表进行预分区,增大其MapReduce作业的并行度
- 合理的设计rowkey使其尽可能的分布在预先分区好的Region上
- 通过set hbase.client.scanner.caching设置合理的扫描缓存
参考资料:
Hive集成HBase详解的更多相关文章
- 图解大数据 | 海量数据库查询-Hive与HBase详解
作者:韩信子@ShowMeAI 教程地址:http://www.showmeai.tech/tutorials/84 本文地址:http://www.showmeai.tech/article-det ...
- 大数据Hadoop核心架构HDFS+MapReduce+Hbase+Hive内部机理详解
微信公众号[程序员江湖] 作者黄小斜,斜杠青年,某985硕士,阿里 Java 研发工程师,于 2018 年秋招拿到 BAT 头条.网易.滴滴等 8 个大厂 offer,目前致力于分享这几年的学习经验. ...
- Hadoop核心架构HDFS+MapReduce+Hbase+Hive内部机理详解
转自:http://blog.csdn.net/iamdll/article/details/20998035 分类: 分布式 2014-03-11 10:31 156人阅读 评论(0) 收藏 举报 ...
- Hive集成HBase;安装pig
Hive集成HBase 配置 将hive的lib/中的HBase.jar包用实际安装的Hbase的jar包替换掉 cd /opt/hive/lib/ ls hbase-0.94.2* rm -rf ...
- [转帖]HBase详解(很全面)
HBase详解(很全面) very long story 简单看了一遍 很多不明白的地方.. 2018-06-08 16:12:32 卢子墨 阅读数 34857更多 分类专栏: HBase [转自 ...
- 安卓集成发布详解(二)gradle
转自:http://frank-zhu.github.io/android/2015/06/15/android-release_app_build_gradle/ 安卓集成发布详解(二) 15 Ju ...
- Hadoop Hive sql语法详解
Hadoop Hive sql语法详解 Hive 是基于Hadoop 构建的一套数据仓库分析系统,它提供了丰富的SQL查询方式来分析存储在Hadoop 分布式文件系统中的数据,可以将结构 化的数据文件 ...
- 最佳实战Docker持续集成图文详解
最佳实战Docker持续集成图文详解 这是一种真正的容器级的实现,这个带来的好处,不仅仅是效率的提升,更是一种变革:开发人员第一次真正为自己的代码负责——终于可以跳过运维和测试部门,自主维护运行环境( ...
- Hive的配置详解和日常维护
Hive的配置详解和日常维护 一.Hive的参数配置详解 1>.mapred.reduce.tasks 默认为-1.指定Hive作业的reduce task个数,如果保留默认值,则Hive 自 ...
随机推荐
- HBase总结(十二)Java API 与HBase交互实例
HBase提供了Java Api的訪问接口,掌握这个就跟Java应用使用RDBMS时须要JDBC一样重要 import java.io.IOException; import org.apache.h ...
- 应用按home键无最近应用
在应用的AndroidManifest里面添加加载模式
- [React] React Router: Router, Route, and Link
In this lesson we'll take our first look at the most common components available to us in react-rout ...
- 基本SQL语句练习之SELECT
一.SQL Plus连接sqlplus:以命令行方式连接数据库sqlplusw:以窗口登录方式连接数据库conn sys/password as sysdba;show userselect * fr ...
- Spring简单的小例子SpringDemo,用于初略理解什么是Spring以及JavaBean的一些概念
一.开发前的准备 两个开发包spring-framework-3.1.1.RELEASE-with-docs.zip和commons-logging-1.2-bin.zip,将它们解压,然后把Spri ...
- jquery之杂记
//选中事件,放在初始化方法里面,toolbar下面 onSelect : function(rowIndex, rowData) { queryChannelFloor(rowIndex, rowD ...
- python 下的数据结构与算法---1:让一切从无关开始
这段时间把<Data Structure and Algorithms with python>以及<Problem Solving with Algorithms and Dat ...
- 在 sys.servers 中找不到服务器的解决办法,自己解决的
一开始提示,在服务器中找不到在 sys.servers 中找不到服务器 'QPAccountsDBLink',先用select * from sys.servers ,发现只能查到一个服务器名称,后 ...
- scala学习笔记——特质
一个类扩展自一个或多个特质,以便使用这些特质提供的服务.特质可能会要求使用它的类支持某个特定的特性.不过和java不同,Scala特质可以给出这些特性的缺省实现. 特质的特性: 类可以实现任意数量的特 ...
- iOS基础框架的搭建 / 及国际化操作
1.基础框架的搭建 1.1 pod引入常用的第三方类库 1.2 创建基础文件夹结构/目录结构 Resource———存放声音/图片/xib/storyboard 等资源文件 Define——宏定义, ...