
sqoop1.4.6数据迁移
sqoop介绍
sqoop是apache旗下一款“Hadoop和关系数据库服务器之间传送数据”的工具。
导入数据:MySQL,Oracle导入数据到Hadoop的HDFS、HIVE、HBASE等数据存储系统;
导出数据:从Hadoop的文件系统中导出数据到关系数据库

sqoop工作机制
将导入或导出命令翻译成mapreduce程序来实现
在翻译出的mapreduce中主要是对inputformat和outputformat进行定制
sqoop安装
安装sqoop的前提是已经具备Java和hadoop的环境
1、下载,解压到/usr/local/目录下,重命名为sqoop
2、修改配置文件$SQOOP_HOME/conf
mv sqoop-env-template.sh sqoop-env.sh
打开sqoop-env.sh并编辑下面几行:
export HADOOP_COMMON_HOME=/usr/local/hadoop/
export HADOOP_MAPRED_HOME=/usr/local/hadoop/
export HIVE_HOME=/usr/local/hive
3、将MySQL的jdbc驱动包添加到sqoop/lib/目录下
注意:
后面在sqoop中进行数据导入导出的时候,会出现很多错误:
java.sql.SQLException: Streaming result set com.mysql.jdbc.RowDataDynamic@1d5a7f6 is still active. No statements may be issued when any streaming result sets are open and in use on a given connection. Ensure that you have called .close() on any active streaming result sets before attempting more queries.
ERROR tool.ImportTool: Encountered IOException running import job: java.io.IOException: No columns to generate for ClassWriter
这些错误都是$SQOOP_HOME/lib/中导入的jdbc驱动包版本低造成的,换个高版本的就OK了。
4、验证启动
$SQOOP_HOME/bin
$sqoop-version

三个警告,不用管。到这里,整个sqoop安装就完成了。
Sqoop的数据导入
1、导入表数据到HDFS
在mysql中有一个库userdb中三个表:emp, emp_add和emp_conn
|
id |
name |
deg |
salary |
dept |
|
1201 |
gopal |
manager |
50,000 |
TP |
|
1202 |
manisha |
Proof reader |
50,000 |
TP |
|
1203 |
khalil |
php dev |
30,000 |
AC |
|
1204 |
prasanth |
php dev |
30,000 |
AC |
|
1205 |
kranthi |
admin |
20,000 |
TP |
|
id |
hno |
street |
city |
|
1201 |
288A |
vgiri |
jublee |
|
1202 |
108I |
aoc |
sec-bad |
|
1203 |
144Z |
pgutta |
hyd |
|
1204 |
78B |
old city |
sec-bad |
|
1205 |
720X |
hitec |
sec-bad |
|
id |
phno |
|
|
1201 |
2356742 |
gopal@tp.com |
|
1202 |
1661663 |
manisha@tp.com |
|
1203 |
8887776 |
khalil@ac.com |
|
1204 |
9988774 |
prasanth@ac.com |
|
1205 |
1231231 |
kranthi@tp.com |
|
$bin/sqoop import \ --connect jdbc:mysql://hadoop1:3306/userdb \mysql中数据库的名字 --username root \ --password admin \ --table emp \userdb下的emp表,可以通过第三方工具创建 --m 1 运行MapReduce的数量 |


2、导入关系表到hive
|
bin/sqoop import --connect jdbc:mysql://hadoop1:3306/userdb --username root --password admin --table emp --hive-import --m 1 |


3、导入到HDFS指定目录
|
bin/sqoop import \ --connect jdbc:mysql://hadoop1:3306/userdb \ --username root \ --password admin \ --target-dir /queryresult \ --table emp_add --m 1 |

4、导入表数据子集
|
bin/sqoop import \ --connect jdbc:mysql://hadoop1:3306/userdb \ --username root \ --password admin \ --where "city ='sec-bad'" \ --target-dir /wherequery \ --table emp_add --m 1 |

5、增量导入
增量导入是仅导入新添加的表中的行的技术。
它需要添加‘incremental’, ‘check-column’, 和 ‘last-value’选项来执行增量导入。
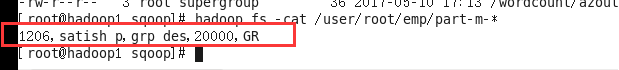
假设新添加的数据转换成emp表如下:
1206, satish p, grp des, 20000, GR
|
bin/sqoop import \ --connect jdbc:mysql://hadoop1:3306/userdb \ --username root \ --password admin \ --table emp --m 1 \ --incremental append \ --check-column id \ --last-value 1205 上次表中最后一行的id,这个id以后的就是新增的! |
sqoop的数据导出
首先确保hdfs中有所要导出的数据存在!!!
1、首先需要手动创建mysql中的目标表
|
$ mysql mysql> USE userdb; mysql> CREATE TABLE employee ( id INT NOT NULL PRIMARY KEY, name VARCHAR(20), deg VARCHAR(20), salary INT, dept VARCHAR(10)); |
2、然后执行导出命令
|
bin/sqoop export \ --connect jdbc:mysql://hadoop1:3306/userdb \ --username root \ --password admin \ --table employee \ --export-dir /user/root/emp/ 位于hdfs中的要导出的数据路径 |
3、验证表mysql命令行。

sqoop1.4.6数据迁移的更多相关文章
- sqoop 数据迁移
sqoop 数据迁移 1 概述 sqoop是apache旗下一款“Hadoop和关系数据库服务器之间传送数据”的工具. 导入数据:MySQL,Oracle导入数据到Hadoop的HDFS.HIVE.H ...
- 【SQLServer】记一次数据迁移-标识重复的简单处理
汇总篇:http://www.cnblogs.com/dunitian/p/4822808.html#tsql 今天在数据迁移的时候因为手贱遇到一个坑爹问题,发来大家乐乐,也传授新手点经验 迁移惯用就 ...
- Entity Framework Code First Migrations--EF 的数据迁移
1. 为了演示方便,首先新建一个控制台项目,然后添加对entityframework的引用 使用nuget控制台执行: Install-Package EntityFramework 2.新建一个实体 ...
- mssql与mysql 数据迁移
概要: mssql向mysql迁移的实例,所要用到的工具bcp和load data local infile. 由于订单记录的数据是存放在mssql服务器上的,而项目需求把数据迁移到mysql ser ...
- 重置EntityFramework数据迁移到洁净状态
前言 翻译一篇有关EF数据迁移的文章,以备日后所用,文章若有翻译不当的地方请指出,将就点看,废话少说,看话题.[注意]:文章非一字一句的翻译,就重要的问题进行解释并解决. 话题引入 无法确定这种场景是 ...
- MySQL数据迁移到SQL Server
数据迁移的工具有很多,基本SSMA团队已经考虑到其他数据库到SQL Server迁移的需求了,所以已经开发了相关的迁移工具来支持. 此博客主要介绍MySQL到SQL Server数据迁移的工具:SQL ...
- MySQL数据迁移到MSSQL-以小米数据库为例-测试828W最快可达到2分11秒
这里采用.NET Framework 4.0以上版本中新出现的 ConcurrentQueue<T> 类 MSDN是这样描述的: ConcurrentQueue<T> 类是一个 ...
- 从零自学Hadoop(16):Hive数据导入导出,集群数据迁移上
阅读目录 序 导入文件到Hive 将其他表的查询结果导入表 动态分区插入 将SQL语句的值插入到表中 模拟数据文件下载 系列索引 本文版权归mephisto和博客园共有,欢迎转载,但须保留此段声明,并 ...
- 从零自学Hadoop(17):Hive数据导入导出,集群数据迁移下
阅读目录 序 将查询的结果写入文件系统 集群数据迁移一 集群数据迁移二 系列索引 本文版权归mephisto和博客园共有,欢迎转载,但须保留此段声明,并给出原文链接,谢谢合作. 文章是哥(mephis ...
随机推荐
- 洛谷 P4284 [SHOI2014]概率充电器 解题报告
P4284 [SHOI2014]概率充电器 题目描述 著名的电子产品品牌SHOI 刚刚发布了引领世界潮流的下一代电子产品-- 概率充电器: "采用全新纳米级加工技术,实现元件与导线能否通电完 ...
- 前端学习 -- Css -- 字体分类
在网页中将字体分成5大类: serif(衬线字体) sans-serif(非衬线字体) monospace (等宽字体) cursive (草书字体) fantasy (虚幻字体) 可以将字体设置为这 ...
- 【HDU5687】Trie
题目大意:需要维护一个支持以下操作的数据结构:(1)支持插入一个字符串(2)支持删除所有前缀等于给定字符串的单词(3)查询该数据结构中是否存在一个以给定字符串为前缀的字符串 题解:由题目可知,需要维护 ...
- linux command ------ unlink 和 rm 的区别
unlink 不能用于删除文件夹,rm 可以删除文件和文件夹 当删除文件时,rm 和 unlink 是完全一样的.
- 变量&常量
变量:variables 存储数据,以被后面的程序调用,可以看作是:装信息的容器: 变量的作用:(1)标记数据(2)存储数据 变量定义规范1.声明变量:定义变量 name = "Mr H ...
- JVM总结(一):概述--JVM对象探秘
这一节我们来讨论一下JVM对象建立过程. JVM对象探秘 对象的建立 对象的内存布局 对象的访问定位 JVM对象探秘 对象的建立 对象的建立过程 图一:对象建立过程 1.类加载检查. 当JVM检测 ...
- Spark记录-Scala数组
Scala提供了一种数据结构叫作数组,数组是一种存储了相同类型元素的固定大小顺序集合.数组用于存储数据集合,但将数组视为相同类型变量的集合通常更为有用. 可以声明一个数组变量,例如:numbers,使 ...
- SQL记录-PLSQL异常
PL/SQL异常 程序执行过程中出现错误情况被称为在PL/SQL异常. PL/SQL支持程序员在程序中使用异常块捕获这样的条件并采取适当的动作应对错误情况.有两种类型的异常: 系统定义的异常 用户 ...
- eclipse 关闭控制台 自动弹出
Eclipse的控制台console有时候经常的跳出来,非常的烦人! 尤其是在调试期间跳出,以下是分享一下设置操作: 让它不经常的调出来,可以按下面的操作去掉它: windows -> p ...
- 自定义泛型_无多态_通配符无泛型数组_jdk7泛型使用
通配符 T, K, V, E 等泛型字母为有类型, 类型参数赋予具体的值 ? 未知类型 类型参数赋予不确定值, 任意类型 只能用在 声明类型上,方法参数上, 不能用在定义泛型类上 上限 extends ...