
scrapy架构简介
一.scrapy架构介绍
1.结构简图:
主要组成部分:Spider(产出request,处理response),Pipeline,Downloader,Scheduler,Scrapy Engine
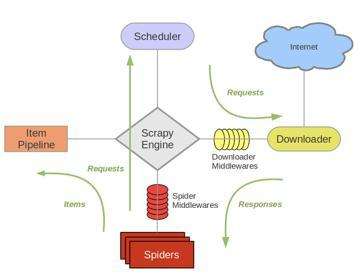
2.结构详细图:
主要步骤(往复循环):
1.Spiders(自己书写的爬虫逻辑,处理url及网页等【spider genspider -t 指定模板 爬虫文件名 域名】),返回Requests给engine——>
2.engine拿到requests返回给scheduler(什么也没做)——>
3.然后scheduler会生成一个requests交给engine(url调度器)——>
4.engine通过downloader的middleware一层一层过滤然后将requests交给downloader——>
5.downloader下载完成后又通过middleware过滤将response返回给engine——>
6.engine拿到response之后将response通过spiders的middleware过滤后返回给spider,然后spider做一些处理(如返回items或requests)——>
7.spiders将处理后得到的一些items和requests通过中间件过滤返回给engine——>
8.engine判断返回的是items或requests,如果是items就直接返回给item pipelines,如果是requests就将requests返回给scheduler(和第二步一样)

源码简介:
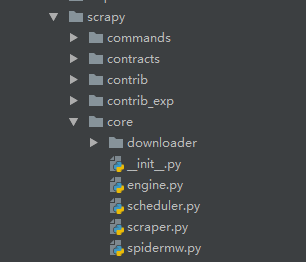
源码核心的东西
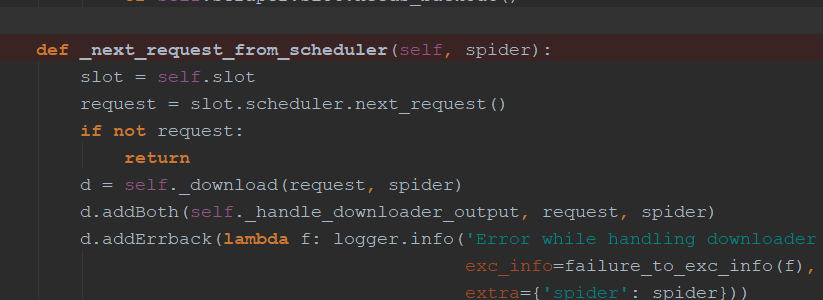
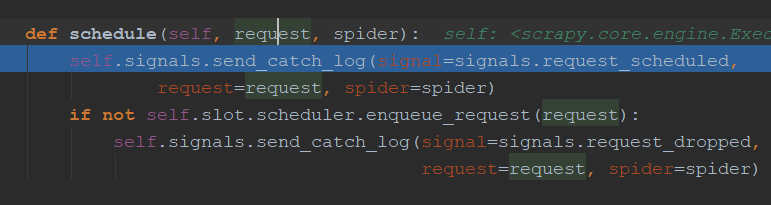
engine.py中介绍:通过_next_request_from_scheduler判断是否有requests(request返回给engine直接返回给scheduler【第一步】),request会首先调用schedule()函数发送给schedule(第二步),然后返回给engine
downloader简介:

可以处理很多类型的下载
Request和Response简介:
class Request(object_ref):

    def __init__(self, url, callback=None, method='GET', headers=None, body=None,

                 cookies=None, meta=None, encoding='utf-8', priority=0,

                 dont_filter=False, errback=None, flags=None):

......
官网介绍(具体官网网址:https://doc.scrapy.org/en/latest/topics/request-response.html):
| 参 数: |
|
|---|
class Response(object_ref):

    def __init__(self, url, status=200, headers=None, body=b'', flags=None, request=None):

        self.headers = Headers(headers or {})

        self.status = int(status)

        self._set_body(body)

        self._set_url(url)

        self.request = request

        self.flags = [] if flags is None else list(flags)

......
| 参数: |
|
|---|
scrapy架构简介的更多相关文章
- 爬虫基础(五)-----scrapy框架简介
---------------------------------------------------摆脱穷人思维 <五> :拓展自己的视野,适当做一些眼前''无用''的事情,防止进入只关 ...
- LoadRunner系统架构简介
1.LoadRunner系统架构简介 LoadRunner是通过创建虚拟用户来代替真实实际用户来操作客户端软件比如Internet Explorer,来向IIS.Apache等Web服务器发送HTTP ...
- crtmpserver的架构简介
crtmpserver的架构简介 一.层 Layers . 机器层 Machine layer . 操作系统层 Operating System Layer This layer is compo ...
- Extjs6官方文档译文——应用架构简介(MVC,MVVM)
应用架构简介 Extjs 同时提供对于MVC和MVVM应用架构的支持.这两个架构方式共享某些概念,而且都旨在沿着逻辑层面划分应用程序代码.每种方法在选择如何划分应用组件上都有其各自的优势. 本指南的目 ...
- scrapy架构初探
scrapy架构初探 引言 Python即时网络爬虫启动的目标是一起把互联网变成大数据库.单纯的开放源代码并不是开源的全部,开源的核心是"开放的思想",聚合最好的想法.技术.人员, ...
- Scrapy架构概述
Scrapy架构概述 1, 从最初自己编写的spiders,获取到start_url,并且封装成Request对象. 2,通过engine(引擎)调度给SCHEDULER(Requests管理调度器) ...
- Kafka:架构简介【转】
转:http://www.cnblogs.com/f1194361820/p/6026313.html Kafka 架构简介 Kafka是一个开源的.分布式的.可分区的.可复制的基于日志提交的发布订阅 ...
- 第三百四十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图
第三百四十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图 1.基本概念 2.反爬虫的目的 3.爬虫和反爬的对抗过程以及策略 scra ...
- Python -- Scrapy 架构概览
架构概览 本文档介绍了Scrapy架构及其组件之间的交互. 概述 接下来的图表展现了Scrapy的架构,包括组件及在系统中发生的数据流的概览(绿色箭头所示). 下面对每个组件都做了简单介绍,并给出了详 ...
随机推荐
- 如何利用pip自动生成和安装requirements.txt依赖
在查看别人的Python项目时,经常会看到一个requirements.txt文件,里面记录了当前程序的所有依赖包及其精确版本号.这个文件有点类似与Rails的Gemfile.其作用是用来在另一台PC ...
- 新手PHP连接MySQL数据库出问题(Warning: mysqli_connect(): (HY000/1045): Access denied for user 'root'@'localhost' (using password: YES))
我用的环境是wampServer集成的软件包 在php连接MySQL数据库的时候老是出现这个问题Warning: mysqli_connect(): (HY000/1045): Access deni ...
- ELMO模型(Deep contextualized word representation)
1 概述 word embedding 是现在自然语言处理中最常用的 word representation 的方法,常用的word embedding 是word2vec的方法,然而word2vec ...
- Python实现机器人聊天
今天午休的时候,无意之中看了一篇博客,名字叫Python实现机器人,感觉挺有的意思的.于是用其写了一个简单的Python聊天,源码如下所示: # -*- coding: utf- -*- import ...
- 从String.valueOf(null)说起
同学在群问String.valueOf(null)返回啥,我看了下源码,返回"null"啊, public static String valueOf(Object obj) ...
- 论文笔记(一)---翻译 Rich feature hierarchies for accurate object detection and semantic segmentation
论文网址: https://arxiv.org/abs/1311.2524 RCNN利用深度学习进行目标检测. 摘要 可以将ImageNet上的进全图像分类而训练好的大型卷积神经网络用到PASCAL的 ...
- Recurrent Neural Network[survey]
0.引言 我们发现传统的(如前向网络等)非循环的NN都是假设样本之间无依赖关系(至少时间和顺序上是无依赖关系),而许多学习任务却都涉及到处理序列数据,如image captioning,speech ...
- HBase篇(3)-架构详解
[每日五分钟搞定大数据]系列,HBase第三篇 聊完场景和数据模型我们来说下HBase的架构,在网上找了张比较清晰的图,我觉得这张图能说明很多问题,那这一篇我们就重点来解析下这张图 角色与职责 先介绍 ...
- Sql 调优总结
1前言 Sql 语句调优对应用性能非常重要,看了几篇文章,总结了一下数据库优化的方法. 2 数据库 Sql 优化 1 对查询进行优化,要尽量避免全表扫描,首先应考虑在 where 及 order by ...
- 第一次在新西兰组织技术社区活动:Monkeyfest2018
从3月份登陆到现在,转眼间已经8个月了.在6个月的时候我就想写篇文总结下近期的一些状况,一直拖到现在.因为近期一直在筹备我第一次社区活动——Monkeyfest 2018,占用了比较多的时间.这是一个 ...