
Python -- Scrapy 架构概览
架构概览
本文档介绍了Scrapy架构及其组件之间的交互。
概述
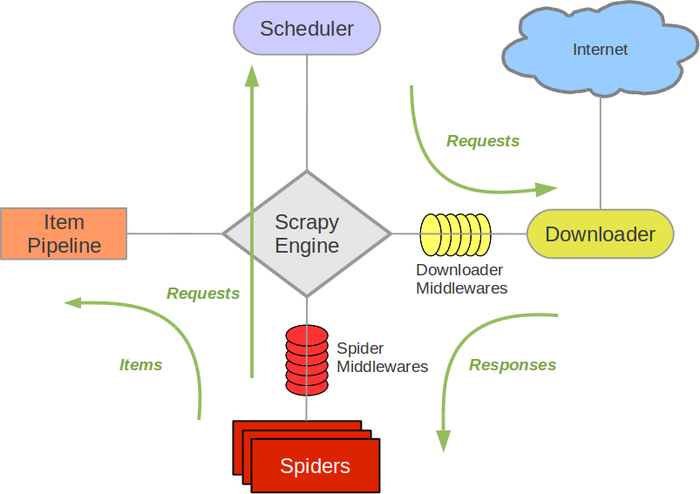
接下来的图表展现了Scrapy的架构,包括组件及在系统中发生的数据流的概览(绿色箭头所示)。 下面对每个组件都做了简单介绍,并给出了详细内容的链接。数据流如下所描述。
组件
引擎(Scrapy Engine)
引擎负责控制数据流在系统中所有组件中流动,并在相应动作发生时触发事件。 详细内容查看下面的数据流(Data Flow)部分。
调度器(Scheduler)
调度器从引擎接受request并将他们入队,以便之后引擎请求他们时提供给引擎。
下载器(Downloader)
下载器负责获取页面数据并提供给引擎,而后提供给spider。
爬虫(Spiders)
Spider是Scrapy用户编写用于分析response并提取item(即获取到的item)或额外跟进的URL的类。 每个spider负责处理一个特定(或一些)网站。 更多内容请看 Spiders 。
项目管道(Item Pipeline)
Item Pipeline负责处理被spider提取出来的item。典型的处理有清理、 验证及持久化(例如存取到数据库中)。 更多内容查看 Item Pipeline 。
下载器中间件(Downloader middlewares)
下载器中间件是在引擎及下载器之间的特定钩子(specific hook),处理Downloader传递给引擎的response。 其提供了一个简便的机制,通过插入自定义代码来扩展Scrapy功能。更多内容请看 下载器中间件(Downloader Middleware) 。
Spider中间件(Spider middlewares)
Spider中间件是在引擎及Spider之间的特定钩子(specific hook),处理spider的输入(response)和输出(items及requests)。 其提供了一个简便的机制,通过插入自定义代码来扩展Scrapy功能。更多内容请看 Spider中间件(Middleware) 。
数据流(Data flow)
Scrapy中的数据流由执行引擎控制,其过程如下:
- 引擎打开一个网站(open a domain),找到处理该网站的Spider并向该spider请求第一个要爬取的URL(s)。
- 引擎从Spider中获取到第一个要爬取的URL并在调度器(Scheduler)以Request调度。
- 引擎向调度器请求下一个要爬取的URL。
- 调度器返回下一个要爬取的URL给引擎,引擎将URL通过下载中间件(请求(request)方向)转发给下载器(Downloader)。
- 一旦页面下载完毕,下载器生成一个该页面的Response,并将其通过下载中间件(返回(response)方向)发送给引擎。
- 引擎从下载器中接收到Response并通过Spider中间件(输入方向)发送给Spider处理。
- Spider处理Response并返回爬取到的Item及(跟进的)新的Request给引擎。
- 引擎将(Spider返回的)爬取到的Item给Item Pipeline,将(Spider返回的)Request给调度器。
- (从第二步)重复直到调度器中没有更多地request,引擎关闭该网站。
事件驱动网络(Event-driven networking)
Scrapy基于事件驱动网络框架 Twisted 编写。因此,Scrapy基于并发性考虑由非阻塞(即异步)的实现。
关于异步编程及Twisted更多的内容请查看下列链接:
Python -- Scrapy 架构概览的更多相关文章
- 第三百四十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图
第三百四十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图 1.基本概念 2.反爬虫的目的 3.爬虫和反爬的对抗过程以及策略 scra ...
- 二十四 Python分布式爬虫打造搜索引擎Scrapy精讲—爬虫和反爬的对抗过程以及策略—scrapy架构源码分析图
1.基本概念 2.反爬虫的目的 3.爬虫和反爬的对抗过程以及策略 scrapy架构源码分析图
- python Scrapy安装和介绍
python Scrapy安装和介绍 Windows7下安装1.执行easy_install Scrapy Centos6.5下安装 1.库文件安装yum install libxslt-devel ...
- scrapy架构初探
scrapy架构初探 引言 Python即时网络爬虫启动的目标是一起把互联网变成大数据库.单纯的开放源代码并不是开源的全部,开源的核心是"开放的思想",聚合最好的想法.技术.人员, ...
- Python——Scrapy初学
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架.可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中.Scrapy最初是为了页面抓取(更确切来说, 网络抓取)所设计的,也 ...
- scrapy架构简介
一.scrapy架构介绍 1.结构简图: 主要组成部分:Spider(产出request,处理response),Pipeline,Downloader,Scheduler,Scrapy Engine ...
- python Scrapy 从零开始学习笔记(一)
在之前我做了一个系列的关于 python 爬虫的文章,传送门:https://www.cnblogs.com/weijiutao/p/10735455.html,并写了几个爬取相关网站并提取有效信息的 ...
- python scrapy版 极客学院爬虫V2
python scrapy版 极客学院爬虫V2 1 基本技术 使用scrapy 2 这个爬虫的难点是 Request中的headers和cookies 尝试过好多次才成功(模拟登录),否则只能抓免费课 ...
- Python.Scrapy.14-scrapy-source-code-analysis-part-4
Scrapy 源代码分析系列-4 scrapy.commands 子包 子包scrapy.commands定义了在命令scrapy中使用的子命令(subcommand): bench, check, ...
随机推荐
- 剑指offer4
中序遍历(LDR)是二叉树遍历的一种,也叫做中根遍历.中序周游.在二叉树中,先左后根再右.巧记:左根右. 现在有一个问题,已知二叉树的前序遍历和中序遍历:PreOrder: GDAFE ...
- SQL中SELECT INTO和INSERT INTO SELECT语句介绍
表复制是经常要用到的操作,下面就将为您介绍SQL中SELECT INTO和INSERT INTO SELECT语句,供您参考. Insert是T-sql中常用语句,Insert INTO table( ...
- #C++初学记录(ACM试题2)
Max Sum Given a sequence a[1],a[2],a[3]......a[n], your job is to calculate the max sum of a sub-seq ...
- vb6.0的安装
vb6.0古老的编程软件
- 教你如何用Nginx搭建一个安全的、快速的微服务架构
今天我们要谈论微服务以及如何使用Nginx构建一个快速的.安全的网络系统.最后,我们将向您展示一个使用Fabric模式如何非常快速和轻松地构建一个微服务的demo. 在我们探讨Fabric模式之前,我 ...
- bzoj1643 / P2666 [Usaco2007 Oct]Bessie's Secret Pasture 贝茜的秘密草坪
[Usaco2007 Oct]Bessie's Secret Pasture 贝茜的秘密草坪 简单的dfs题 枚举前3个完全平方数,判断最后一个是不是完全平方数,统计合法方案数即可. (zz选手竟把数 ...
- P2512 [HAOI2008]糖果传递&&P3156 [CQOI2011]分金币&&P4016 负载平衡问题
P2512 [HAOI2008]糖果传递 第一步,当然是把数据减去平均数,然后我们可以得出一串正负不等的数列 我们用sum数组存该数列的前缀和.注意sum[ n ]=0 假设为链,那么可以得出答案为a ...
- python3 清除过滤emoji表情
python3 清除过滤emoji表情 方法一: emoji处理库,emoji官网:https://pypi.org/project/emoji/ #安装 pip install emoji 官方例子 ...
- 01: 企业微信API开发前准备
目录:企业微信API其他篇 01: 企业微信API开发前准备 02:消息推送 03: 通讯录管理 04:应用管理 目录: 1.1 术语介绍 1.2 开发步骤 1.1 术语介绍返回顶部 参考文档:htt ...
- linux学习笔记《一.烧写篇_android》
一.菜鸟入门.烧写篇 (1).A8板子烧写程序 (NANDFlash烧写) ①烧写软件: 安装原件 安装后: 应用软件图标 ② 我们首先选中English/中文,切换到中文,然后关掉重启(也可以用英文 ...