
实践详细篇-Windows下使用VS2015编译的Caffe训练mnist数据集
上一篇记录的是学习caffe前的环境准备以及如何创建好自己需要的caffe版本。这一篇记录的是如何使用编译好的caffe做训练mnist数据集,步骤编号延用上一篇 《实践详细篇-Windows下使用VS2015编译安装Caffe环境(CPU ONLY) 》的顺序。
二:使用caffe做图像分类识别训练测试mnist数据集
1、下载MNIST数据集,MNIST数据集包含四个文件信息,见表格:
|
文件 |
内容 |
|
训练集图片 - 55000 张 训练图片, 5000 张 验证图片 |
|
|
训练集图片对应的数字标签 |
|
|
测试集图片 - 10000 张 图片 |
|
|
测试集图片对应的数字标签 |
下载完MNIST数据集包后打开\caffe根目录\examples\mnist并在其中创建一个文件夹mnist_data。并将其四个数据包进行解压到这个目录中。
注意:这四个文件不能直接用于caffe的训练和测试。需要使用编译好的caffe项目中的convert_mnist_data-d.exe文件来把四个文件转换为caffe所支持的leveldb或lmdb文件。convert_mnist_data-d.exe文件存在于caffe根目录\scripts\build\examples\mnist\Debug或Release目录下。选择区分取决于编译时是选择的Debug还是Release。
2、创建命令脚本来调用convert_mnist_data.exe数据转换工具
2.1 在caffe根目录下,新建一个convert-mnist-data-train.bat文件用于做转换训练数据,并在文件中添加如下代码:
scripts\build\examples\mnist\Debug\convert_mnist_data-d.exe --backend=lmdb examples\mnist\mnist_data\train-images.idx3-ubyte examples\mnist\mnist_data\train-labels.idx1-ubyte examples\mnist\mnist_data\mnist_train_lmdb

pause
注意:scripts\build\examples\mnist\Debug\convert_mnist_data-d.exe 这个文件就是数据转换的工具,如果是使用Debug编译的 那文件将是convert_mnist_data-d.exe 如是Release编译的将是convert_mnist_data.exe 这个文件 。其中--backend=lmdb 表示转换为lmdb格式,这里设置的转换数据格式决定了后期使用时修改配置文件对应的格式。若要转换为leveldb将其改写为--backend=leveldb 即可。backend=leveldb后面的参数就是解压出来的数据集的文件路径。
leveldb和lmdb格式区别:
它们都是键/值对(Key/Value Pair)嵌入式数据库管理系统编程库。
虽然lmdb的内存消耗是leveldb的1.1倍,但是lmdb的速度比leveldb快10%至15%,更重要的是lmdb允许多种训练模型同时读取同一组数据集。
因此lmdb取代了leveldb成为Caffe默认的数据集生成格式。
2.2 再新建一个convert-mnist-data-test.bat转换测试数据,并在文件中添加如下代码:
scripts\build\examples\mnist\Debug\convert_mnist_data-d.exe --backend=lmdb examples\mnist\mnist_data\t10k-images.idx3-ubyte examples\mnist\mnist_data\t10k-labels.idx1-ubyte examples\mnist\mnist_data\mnist_test_lmdb

Pause
2.3 运行两个脚本文件进行调用转换测试/训练数据
2.3.1 运行转换测试数据-convert-mnist-data-test.bat
切入到caffe根目录并Shift+鼠标右键选择“在此处打开命令窗口” 然后输入
start convert-mnist-data-test.bat
调用异常:
如出现以上情况,多数是因为文件夹的编码格式导致的,因为UTF-8的原因导致自动在文本最开始添加了一个空格内容导致的,解决方法很简单,重新编辑该文件并保存的时候将格式修改为 ANSI格式即可。
D:\DeepLearning\caffe\caffe>锘縮cripts\build\examples\mnist\Debug\convert_mnist_

data-d.exe --backend=lmdb examples\mnist\mnist_data\t10k-images.idx3-ubyte examp

les\mnist\mnist_data\t10k-labels.idx1-ubyte examples\mnist\mnist_data\mnist_test

_lmdb

系统找不到指定的路径。

D:\DeepLearning\caffe\caffe>Pause
调用成功:
以下代码就是命令反馈的转换成功示例
D:\DeepLearning\caffe\caffe>scripts\build\examples\mnist\Debug\convert_mnist_dat

a-d.exe --backend=lmdb examples\mnist\mnist_data\t10k-images.idx3-ubyte examples

\mnist\mnist_data\t10k-labels.idx1-ubyte examples\mnist\mnist_data\mnist_test_lm

db

I0427 09:47:11.591769  8508 db_lmdb.cpp:40] Opened lmdb examples\mnist\mnist_dat

a\mnist_test_lmdb

I0427 09:47:11.593770  8508 convert_mnist_data.cpp:93] A total of 10000 items.

I0427 09:47:11.593770  8508 convert_mnist_data.cpp:94] Rows: 28 Cols: 28

I0427 09:47:11.983791  8508 db_lmdb.cpp:112] Doubling LMDB map size to 2MB ...

I0427 09:47:12.180804  8508 db_lmdb.cpp:112] Doubling LMDB map size to 4MB ...

I0427 09:47:12.514822  8508 db_lmdb.cpp:112] Doubling LMDB map size to 8MB ...

I0427 09:47:13.059854  8508 db_lmdb.cpp:112] Doubling LMDB map size to 16MB ...

I0427 09:47:13.225862  8508 convert_mnist_data.cpp:113] Processed 10000 files.

D:\DeepLearning\caffe\caffe>Pause
2.3.2 运行转换训练数据
start convert-mnist-data-train.bat
调用成功:
D:\DeepLearning\caffe\caffe>scripts\build\examples\mnist\Debug\convert_mnist_dat

a-d.exe --backend=lmdb examples\mnist\mnist_data\train-images.idx3-ubyte example

s\mnist\mnist_data\train-labels.idx1-ubyte examples\mnist\mnist_data\mnist_train

_lmdb

I0427 09:50:03.852622  8384 db_lmdb.cpp:40] Opened lmdb examples\mnist\mnist_dat

a\mnist_train_lmdb

I0427 09:50:03.854622  8384 convert_mnist_data.cpp:93] A total of 60000 items.

I0427 09:50:03.854622  8384 convert_mnist_data.cpp:94] Rows: 28 Cols: 28

I0427 09:50:03.942627  8384 db_lmdb.cpp:112] Doubling LMDB map size to 2MB ...

I0427 09:50:04.006631  8384 db_lmdb.cpp:112] Doubling LMDB map size to 4MB ...

I0427 09:50:04.131639  8384 db_lmdb.cpp:112] Doubling LMDB map size to 8MB ...

I0427 09:50:04.398653  8384 db_lmdb.cpp:112] Doubling LMDB map size to 16MB ...

I0427 09:50:05.002688  8384 db_lmdb.cpp:112] Doubling LMDB map size to 32MB ...

I0427 09:50:06.283761  8384 db_lmdb.cpp:112] Doubling LMDB map size to 64MB ...

I0427 09:50:08.547890  8384 convert_mnist_data.cpp:113] Processed 60000 files.

D:\DeepLearning\caffe\caffe>pause
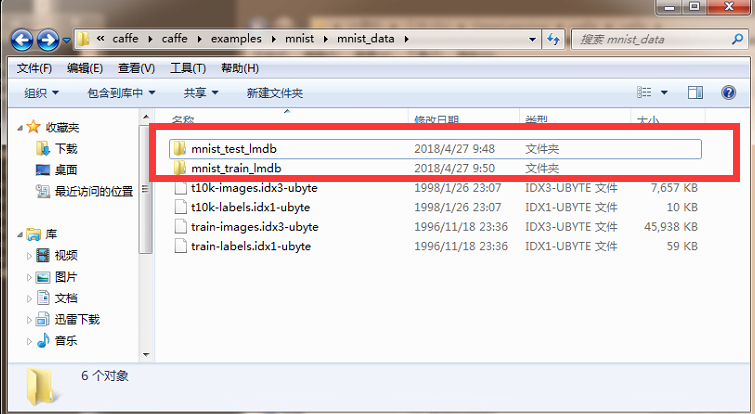
所有数据转换完成后可以在存放数据集文件目录下发现多出来了两个文件夹,并文件夹中都各有两个文件 分别lock.mdb和data.mdb
3、运行测试
3.1 拷贝转换好的测试文件以及训练文件到 caffe根目录\examples\mnist文件夹中 如图:

3.2 编写调用脚本
在caffe根目录下新建一个run.bat文件,文件中代码:
D:\DeepLearning\caffe\caffe\scripts\build\tools\Debug\caffe-d.exe train --solver=examples\mnist\lenet_solver.prototxt

pause
注意:D:\DeepLearning\caffe\caffe\scripts\build\tools\Debug\caffe-d.exe 最好填写的是使用绝对路径。使用caffe-d.exe还是caffe.exe取决与你编译时选择的方式。caffe-d.exe存放于Debug下,caffe.exe存放Release目录下。
3.3 运行文件
确保万一,之前有提到过,在2.1步骤的时候说过,设置的转换数据格式决定后期调用文件的格式,所以我们需要先确认lenet_train_test.prototxt文件中的格式是否一致。
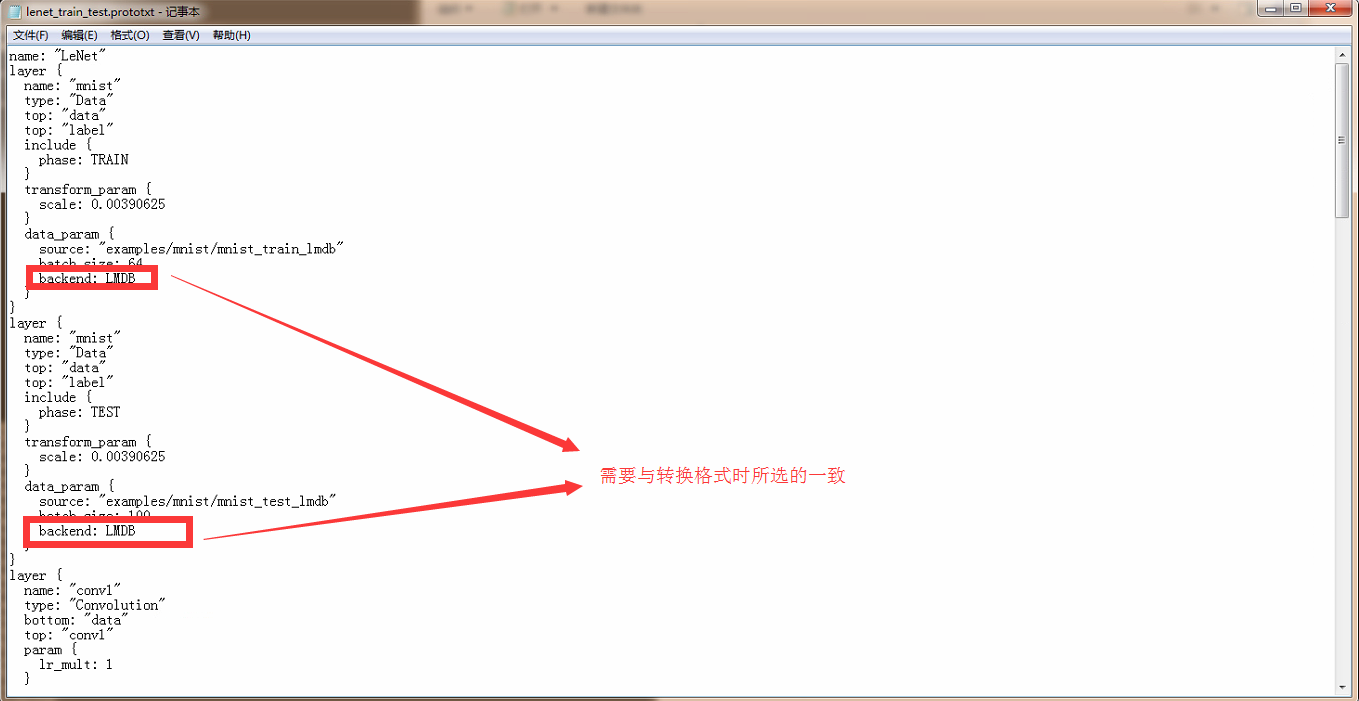
如这里的格式和在转换数据集的时候不一致 将需要修改为一致,简单的就是直接修改这里的配置文件格式改为leveldb或lmdb。不然就是在转换的时候修改为和这里一致。没问题的话我们直接运行:
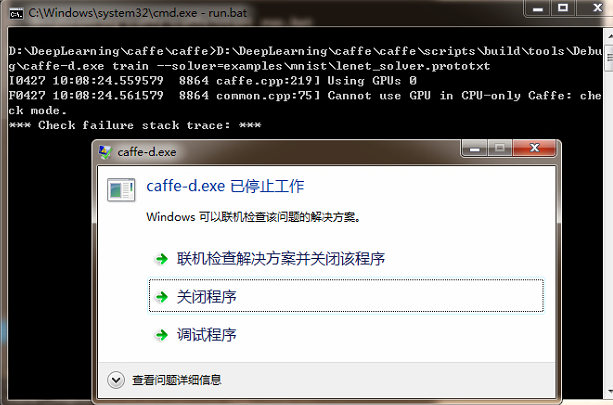
发现运行出现错误了,看错误反馈大致是因为选择的训练方式有问题,不能使用GPU。我们安装caffe时就说过,我们使用的是CPU训练。所以这里出现异常肯定是因为配置出问题了。我们打开 lenet_solver.prototxt文件看看:
# The train/test net protocol buffer definition

net: "examples/mnist/lenet_train_test.prototxt"

# test_iter specifies how many forward passes the test should carry out.

# In the case of MNIST, we have test batch size 100 and 100 test iterations,

# covering the full 10,000 testing images.

test_iter: 100

# Carry out testing every 500 training iterations.

test_interval: 500

# The base learning rate, momentum and the weight decay of the network.

base_lr: 0.01

momentum: 0.9

weight_decay: 0.0005

# The learning rate policy

lr_policy: "inv"

gamma: 0.0001

power: 0.75

# Display every 100 iterations

display: 100

# The maximum number of iterations

max_iter: 10000 --指定了最大迭代次数 默认为10000次

# snapshot intermediate results

snapshot: 5000 是输出中间结果,默认为迭代到5000次时输出中间结果。

snapshot_prefix: "examples/mnist/lenet"

# solver mode: CPU or GPU

solver_mode: GPU  --此处应该应该为CPU 因为我们使用的是CPU训练
可以通过代码注释发现文本显示 “# solver mode: CPU or GPU” 意思是可以选择CPU或GPU,但是由于我们前期配置的是CPU,所以我们这里应该修改为CPU来训练。修改完成后我们继续执行run.bat
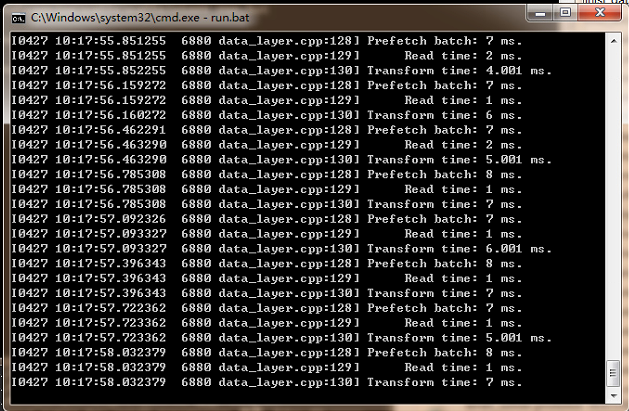
通过运行后的命令窗口反馈是已经正在训练提取特征了了,没报错表示成功了。
总结:
历经几天的学习和尝试,一路磕磕碰碰也总算是将caffe给弄起来了,虽然只是表面使用,并没有真正的达到“深度学习”,但是也是值的欣慰的。两篇博客下来会发现我完全没有提及任何枯燥乏味的理论知识,因为我深知有些牛逼的东西对于我们这种初学者而言不是要记住长篇大论的理论,而是在于自己能动手实践从中先获取到成就感,这样才会有兴趣学下去。我在某课堂也看了一点课程,发现整节课下来都是讲的理论知识,讲的卷积神经网络和循环神经网络等等,这些过于专业的理论知识有些时候反而会让我们这种新人无法理解,导致在一定程度上打压了兴趣。所以可见caffe可以让一个完全不懂卷及神经网络原理的人通过阅读相关编译、搭建知识来实现caffe图像分类识别等效果。当然这种效果只是适合初学者来提高兴趣爱好,真正的大牛还是需要不断的学习,更深入的了解深度学习的理论知识看来提升自我达到取得实质性的突破。
实践详细篇-Windows下使用VS2015编译的Caffe训练mnist数据集的更多相关文章
- 实践详细篇-Windows下使用VS2015编译安装Caffe环境(CPU ONLY)
学习深度学习背景 最近在做一款抢票软件,由于12306经常检测账号状态,抢票抢着抢着就需要重新登录了,然后登录是需要验证码的.所以我最开始是想到了使用java基于感知哈希算法pHash做相似度匹配识别 ...
- 实践详细篇-Windows下使用Caffe训练自己的Caffemodel数据集并进行图像分类
三:使用Caffe训练Caffemodel并进行图像分类 上一篇记录的是如何使用别人训练好的MNIST数据做训练测试.上手操作一边后大致了解了配置文件属性.这一篇记录如何使用自己准备的图片素材做图像分 ...
- [转]Windows下使用VS2015编译openssl库
转自:http://blog.csdn.net/alger_magic/article/details/52584171 目标:编译vs环境下openssl库 工具: 1. 编译环境win10+vs2 ...
- windows下使用VS2015编译V8 JavaScript引擎(v5.5 - 2016/09)
今天心血来潮, 下载了 v8,,然后就想着用vs编译 但是大家都苦恼的是 v8并不直接提供 vs用的项目文件和解决方案(.sln) 于是,在网上搜来搜去, 折腾来折腾去的; 终于一点一点的尝试, 可以 ...
- windows下用vs2010编译ffmpeg
转载自;http://q1q2q3q4q5q6ln.blog.163.com/blog/static/500794332014666536283/ (注意:请务必先阅读:七,后记补充:) ffmpeg ...
- Win7 下用 VS2015 编译最新 openssl(1.0.2j)包含32、64位debug和release版本的dll、lib(8个版本)
Win7 64位系统下通过VS2015编译好的最新的OpenSSL(1.0.2j)所有八个版本的链接库, 包含以下八个版本: 1.32位.debug版LIB: 2.32位.release版LIB: 3 ...
- 手把手教你在Windows下使用MinGW编译libav(参考libx264的编入)
转自:http://www.th7.cn/Program/cp/201407/242762.shtml 手把手教你在Windows下使用MinGW编译libav libav是在Linux下使用纯c语言 ...
- 【转】Windows下使用VS2008编译OpenCV 2.1 添加Intel TBB和Python支持
Windows下使用VS2008编译OpenCV2.1 添加Intel TBB和Python支持 步骤: 1.仔细阅读OpenCV官网上的InstallGuide:http://opencv.will ...
- Windows下从源代码编译Skia
在PPAPI里面画图,能够结合第三方的图形库.比方Cairo.Skia. Google Chrome.Chromium和Android都使用Skia作为画图引擎.我也来试试Skia,先过编译关. fo ...
随机推荐
- Docker学习笔记 - Docker容器的网络基础
一.虚拟网桥 docker0 docker0 是 linux的虚拟网桥,守护进程通过docker0给容器提供网络连接的各种服务. 网桥是数据链路层设备,通常ip地址是网络层的设置.linux的虚拟网桥 ...
- Extensions in UWP Community Toolkit - SurfaceDialTextbox
概述 UWP Community Toolkit Extensions 中有一个为TextBox 提供的 SurfaceDial 扩展 - SurfaceDialTextbox,本篇我们结合代码详细讲 ...
- java 中文乱码问题,请注意response.getWriter的顺序
反例: 正例:
- Python入门之PyCharm的快捷键与常用设置和扩展(Mac系统)
1. 快捷键 2 . PyCharm的常用设置和扩展 ------------------------------------------------------------------------- ...
- "共振式”项目管理
"共振式”项目管理--是我第一个提出的吗?:) 脑子里突然想到项目管理的一些事情,然后想到项目其实是有节奏的,项目中的人员其实如果找到了这个节奏,踏准了节奏,一切将是顺风顺水. 刚准备动笔时 ...
- Vue框架
Vue框架 环境: windows python3.6.2 Vue的cdn: <script src="https://cdn.jsdelivr.net/npm/vue"&g ...
- Python REST
Django REST framework 1. 什么是REST REST与技术无关,代表的是一种软件架构风格,REST是Representational State Transfer的简称,中文翻译 ...
- ZOJ-2913 Bus Pass---BFS进阶版
题目链接: https://vjudge.net/problem/ZOJ-2913 题目大意: 问哪个区域到公交路线上所有区域的最大距离最小 思路: 这里要求出到底是哪个区域到某些指定区域的最大距离最 ...
- MIT许可证
MIT许可证(The MIT License)是许多软件授权条款中,被广泛使用的其中一种.与其他常见的软件授权条款(如GPL.LGPL.BSD)相比,MIT是相对宽松的软件授权条款. MIT 许可证几 ...
- Django REST framework+Vue 打造生鲜超市(六)
七.用户登录与手机注册 7.1.drf的token (1)INSTALL_APP中添加 INSTALLED_APPS = ( ... 'rest_framework.authtoken' ) toke ...