
pytorch: 准备、训练和测试自己的图片数据
大部分的pytorch入门教程,都是使用torchvision里面的数据进行训练和测试。如果我们是自己的图片数据,又该怎么做呢?
一、我的数据
我在学习的时候,使用的是fashion-mnist。这个数据比较小,我的电脑没有GPU,还能吃得消。关于fashion-mnist数据,可以百度,也可以 点此 了解一下,数据就像这个样子:
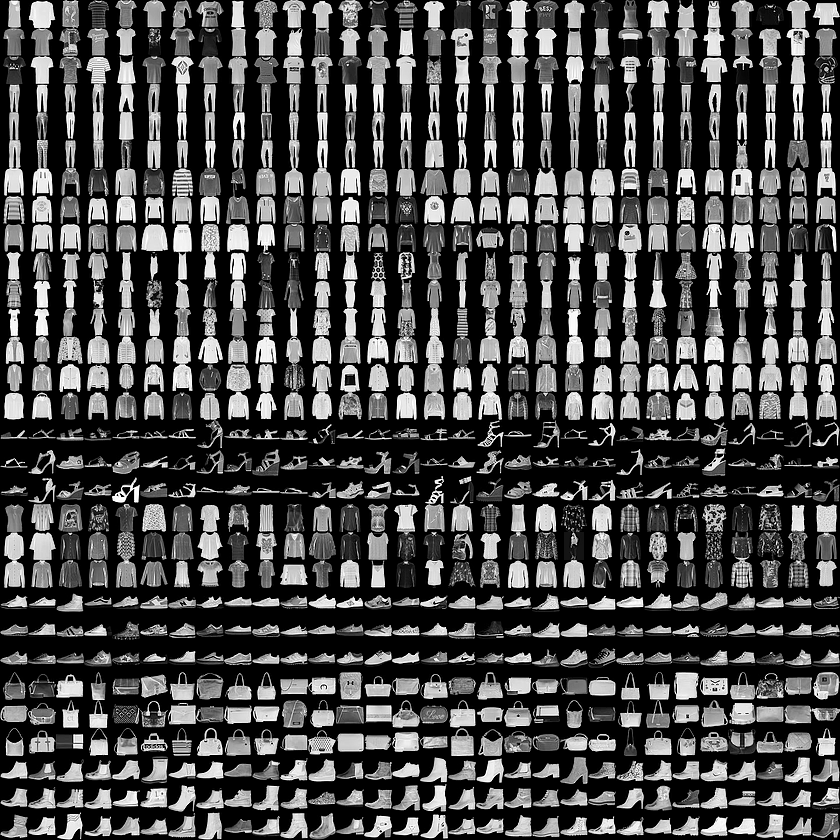
下载地址:https://github.com/zalandoresearch/fashion-mnist
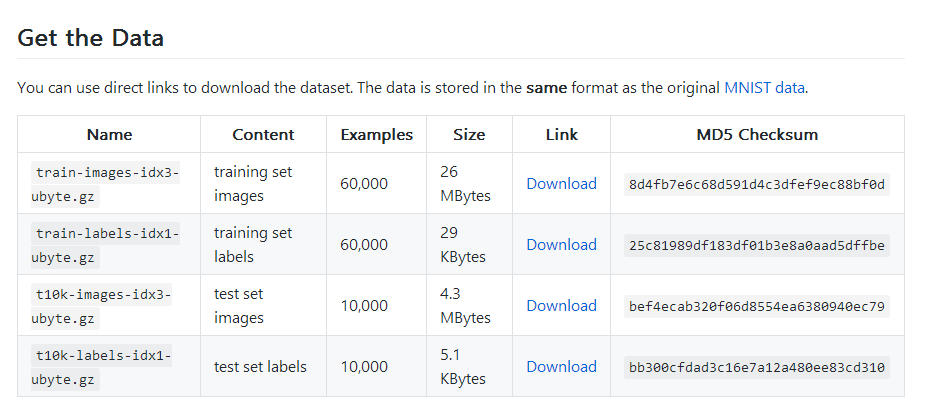
但是下载下来是一种二进制文件,并不是图片,因此我先转换成了图片。
我先解压gz文件到e:/fashion_mnist/文件夹
然后运行代码:
import os

from skimage import io

import torchvision.datasets.mnist as mnist

root="E:/fashion_mnist/"

train_set = (

    mnist.read_image_file(os.path.join(root, 'train-images-idx3-ubyte')),

    mnist.read_label_file(os.path.join(root, 'train-labels-idx1-ubyte'))

        )

test_set = (

    mnist.read_image_file(os.path.join(root, 't10k-images-idx3-ubyte')),

    mnist.read_label_file(os.path.join(root, 't10k-labels-idx1-ubyte'))

        )

print("training set :",train_set[0].size())

print("test set :",test_set[0].size())

def convert_to_img(train=True):

    if(train):

        f=open(root+'train.txt','w')

        data_path=root+'/train/'

        if(not os.path.exists(data_path)):

            os.makedirs(data_path)

        for i, (img,label) in enumerate(zip(train_set[0],train_set[1])):

            img_path=data_path+str(i)+'.jpg'

            io.imsave(img_path,img.numpy())

            f.write(img_path+' '+str(label)+'\n')

        f.close()

    else:

        f = open(root + 'test.txt', 'w')

        data_path = root + '/test/'

        if (not os.path.exists(data_path)):

            os.makedirs(data_path)

        for i, (img,label) in enumerate(zip(test_set[0],test_set[1])):

            img_path = data_path+ str(i) + '.jpg'

            io.imsave(img_path, img.numpy())

            f.write(img_path + ' ' + str(label) + '\n')

        f.close()

convert_to_img(True)

convert_to_img(False)
这样就会在e:/fashion_mnist/目录下分别生成train和test文件夹,用于存放图片。还在该目录下生成了标签文件train.txt和test.txt.
二、进行CNN分类训练和测试
先要将图片读取出来,准备成torch专用的dataset格式,再通过Dataloader进行分批次训练。
代码如下:
import torch

from torch.autograd import Variable

from torchvision import transforms

from torch.utils.data import Dataset, DataLoader

from PIL import Image

root="E:/fashion_mnist/"

# -----------------ready the dataset--------------------------

def default_loader(path):

    return Image.open(path).convert('RGB')

class MyDataset(Dataset):

    def __init__(self, txt, transform=None, target_transform=None, loader=default_loader):

        fh = open(txt, 'r')

        imgs = []

        for line in fh:

            line = line.strip('\n')

            line = line.rstrip()

            words = line.split()

            imgs.append((words[0],int(words[1])))

        self.imgs = imgs

        self.transform = transform

        self.target_transform = target_transform

        self.loader = loader

    def __getitem__(self, index):

        fn, label = self.imgs[index]

        img = self.loader(fn)

        if self.transform is not None:

            img = self.transform(img)

        return img,label

    def __len__(self):

        return len(self.imgs)

train_data=MyDataset(txt=root+'train.txt', transform=transforms.ToTensor())

test_data=MyDataset(txt=root+'test.txt', transform=transforms.ToTensor())

train_loader = DataLoader(dataset=train_data, batch_size=64, shuffle=True)

test_loader = DataLoader(dataset=test_data, batch_size=64)

#-----------------create the Net and training------------------------

class Net(torch.nn.Module):

    def __init__(self):

        super(Net, self).__init__()

        self.conv1 = torch.nn.Sequential(

            torch.nn.Conv2d(3, 32, 3, 1, 1),

            torch.nn.ReLU(),

            torch.nn.MaxPool2d(2))

        self.conv2 = torch.nn.Sequential(

            torch.nn.Conv2d(32, 64, 3, 1, 1),

            torch.nn.ReLU(),

            torch.nn.MaxPool2d(2)

        )

        self.conv3 = torch.nn.Sequential(

            torch.nn.Conv2d(64, 64, 3, 1, 1),

            torch.nn.ReLU(),

            torch.nn.MaxPool2d(2)

        )

        self.dense = torch.nn.Sequential(

            torch.nn.Linear(64 * 3 * 3, 128),

            torch.nn.ReLU(),

            torch.nn.Linear(128, 10)

        )

    def forward(self, x):

        conv1_out = self.conv1(x)

        conv2_out = self.conv2(conv1_out)

        conv3_out = self.conv3(conv2_out)

        res = conv3_out.view(conv3_out.size(0), -1)

        out = self.dense(res)

        return out

model = Net()

print(model)

optimizer = torch.optim.Adam(model.parameters())

loss_func = torch.nn.CrossEntropyLoss()

for epoch in range(10):

    print('epoch {}'.format(epoch + 1))

    # training-----------------------------

    train_loss = 0.

    train_acc = 0.

    for batch_x, batch_y in train_loader:

        batch_x, batch_y = Variable(batch_x), Variable(batch_y)

        out = model(batch_x)

        loss = loss_func(out, batch_y)

        train_loss += loss.data[0]

        pred = torch.max(out, 1)[1]

        train_correct = (pred == batch_y).sum()

        train_acc += train_correct.data[0]

        optimizer.zero_grad()

        loss.backward()

        optimizer.step()

    print('Train Loss: {:.6f}, Acc: {:.6f}'.format(train_loss / (len(

        train_data)), train_acc / (len(train_data))))

    # evaluation--------------------------------

    model.eval()

    eval_loss = 0.

    eval_acc = 0.

    for batch_x, batch_y in test_loader:

        batch_x, batch_y = Variable(batch_x, volatile=True), Variable(batch_y, volatile=True)

        out = model(batch_x)

        loss = loss_func(out, batch_y)

        eval_loss += loss.data[0]

        pred = torch.max(out, 1)[1]

        num_correct = (pred == batch_y).sum()

        eval_acc += num_correct.data[0]

    print('Test Loss: {:.6f}, Acc: {:.6f}'.format(eval_loss / (len(

        test_data)), eval_acc / (len(test_data))))
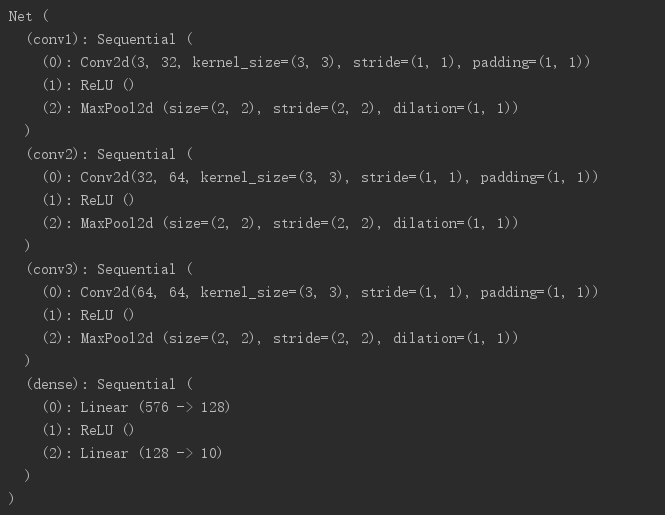
打印出来的网络模型:
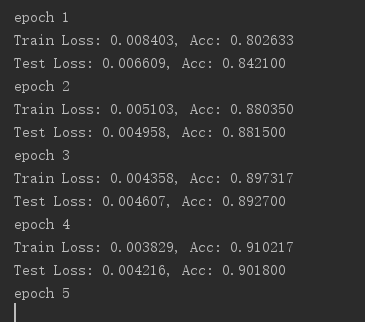
训练和测试结果:
pytorch: 准备、训练和测试自己的图片数据的更多相关文章
- Caffe学习系列(12):训练和测试自己的图片--linux平台
Caffe学习系列(12):训练和测试自己的图片 学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测 ...
- caffe学习系列(2):训练和测试自己的图片
参考:http://www.cnblogs.com/denny402/p/5083300.html 上述主要介绍的是从自己的原始图片转为lmdb数据,再到训练.测试的整个流程(另外可参考薛开宇的笔记) ...
- Caffe学习系列(12):训练和测试自己的图片
学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测试模型的整个流程. 一.准备数据 有条件的同学,可以去 ...
- 转 Caffe学习系列(12):训练和测试自己的图片
学习caffe的目的,不是简单的做几个练习,最终还是要用到自己的实际项目或科研中.因此,本文介绍一下,从自己的原始图片到lmdb数据,再到训练和测试模型的整个流程. 一.准备数据 有条件的同学,可以去 ...
- 使用LeNet训练自己的手写图片数据
一.前言 本文主要尝试将自己的数据集制作成lmdb格式,送进lenet作训练和测试,参考了http://blog.csdn.net/liuweizj12/article/details/5214974 ...
- 用python制作训练集和测试集的图片名列表文本
# -*- coding: utf-8 -*- from pathlib import Path #从pathlib中导入Path import os import fileinput import ...
- Ubuntu16.04下caffe CPU版的图片训练和测试
一 数据准备 二.转换为lmdb格式 1.首先,在examples下面创建一个myfile的文件夹,来用存放配置文件和脚本文件.然后编写一个脚本create_filelist.sh,用来生成train ...
- 随机切分csv训练集和测试集
使用numpy切分训练集和测试集 觉得有用的话,欢迎一起讨论相互学习~Follow Me 序言 在机器学习的任务中,时常需要将一个完整的数据集切分为训练集和测试集.此处我们使用numpy完成这个任务. ...
- Windows下mnist数据集caffemodel分类模型训练及测试
1. MNIST数据集介绍 MNIST是一个手写数字数据库,样本收集的是美国中学生手写样本,比较符合实际情况,大体上样本是这样的: MNIST数据库有以下特性: 包含了60000个训练样本集和1000 ...
随机推荐
- 把我坑惨的一个update语句
最近好几次有开发同学在问我,比如下图: 问题归纳起来就是:在MySQL里面update一条记录,语法都正确的,但记录并没有被更新... 刚遇到这个问题的时候,我拿到这条语句直接在测试库里面执行了一把, ...
- Linux-网络综合实验
题目要求:财务部门有俩台机器acc-1和acc-2,it部门有俩台机器it-2和it-2,要求acc机器互通,it机器互通,财务部和it部机器通过路由器互通
- Alpha冲刺(2/10)——2019.4.24
作业描述 课程 软件工程1916|W(福州大学) 团队名称 修!咻咻! 作业要求 项目Alpha冲刺(团队) 团队目标 切实可行的计算机协会维修预约平台 开发工具 Eclipse 团队信息 队员学号 ...
- 对象关系映射 ORM
1.1 作用 MTV框架中包括一个重要的部分,它实现了数据模型与数据库的解耦,即数据模型的设计不需要依赖于特定的数据库,通过简单的配置就可以轻松更换数据库,这极大的减轻了开发人员的工作量,不需要面对因 ...
- C\C++ 内存对齐现象
前几天一个在自学C语言的小伙伴问了我个问题,C语言结构体储存所占空间为啥和自己预测的不一样.看一下下面这一段代码: struct node{ int num; char ch; }a; printf( ...
- Pycharm安装+python安装+环境配置
Pycharm 工具: 1.安装jdk(64位):jdk-8u65-windows-x64.exe 路径:C:\Program Files\Java(默认路径) 2.配置环境 步骤一: 系统变量→新建 ...
- Java equals()方法和hashCode()方法
equals()方法 如果满足了以下任何一个条件,就不需要覆盖equals()方法: 1 类的每个实例本质上都是唯一的. 2 不关心类是否提供了“逻辑相等”的测试功能. 3 父类已经覆盖了equals ...
- jdk12+tomcat9 配置
jdk12 没有了jre的配置 直接配置path就可以了 tomcat常规配置,只是启动的时候麻烦一点 需要重新写入jdk jre jvm 到server.bat文件 参考文章: https: ...
- 3、java面向对象编程
1.面向对象内存分析 栈的特点 (1)JVM为每个线程创建一个栈,用于存放该线程执行方法的信息(实际参数.局部变量等) (2)栈属于线程私有,不能实现线程间的共享! (3)栈的存储特性是:先进后出,后 ...
- php获取当前时间的毫秒数
floor(microtime()*1000); 用microtime能输出当前的秒的后面8位小数 乘以1000取整数就行了