
Spark Streaming之六:Transformations 普通的转换操作
与RDD类似,DStream也提供了自己的一系列操作方法,这些操作可以分成四类:
- Transformations 普通的转换操作
- Window Operations 窗口转换操作
- Join Operations 合并操作
- Output Operations 输出操作
2.2.3.1 普通的转换操作
普通的转换操作如下表所示:
|
转换 |
描述 |
|
map(func) |
源 DStream的每个元素通过函数func返回一个新的DStream。 |
|
flatMap(func) |
类似与map操作,不同的是每个输入元素可以被映射出0或者更多的输出元素。 |
|
filter(func) |
在源DSTREAM上选择Func函数返回仅为true的元素,最终返回一个新的DSTREAM 。 |
|
repartition(numPartitions) |
通过输入的参数numPartitions的值来改变DStream的分区大小。 |
|
union(otherStream) |
返回一个包含源DStream与其他 DStream的元素合并后的新DSTREAM。 |
|
count() |
对源DStream内部的所含有的RDD的元素数量进行计数,返回一个内部的RDD只包含一个元素的DStreaam。 |
|
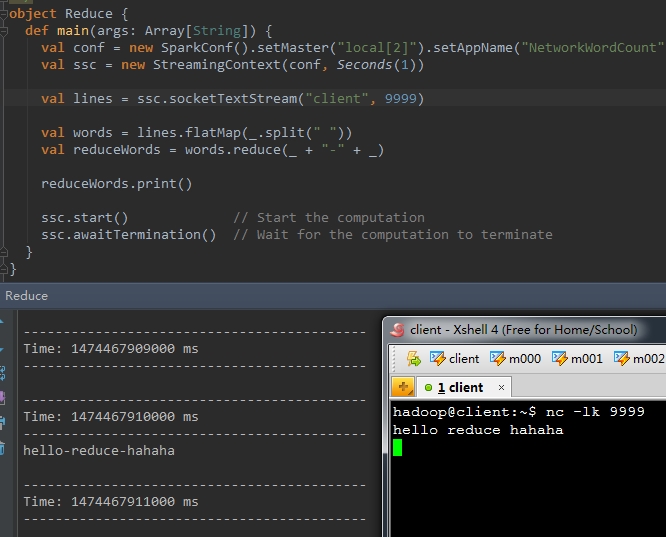
reduce(func) |
使用函数func(有两个参数并返回一个结果)将源DStream 中每个RDD的元素进行聚 合操作,返回一个内部所包含的RDD只有一个元素的新DStream。 |
|
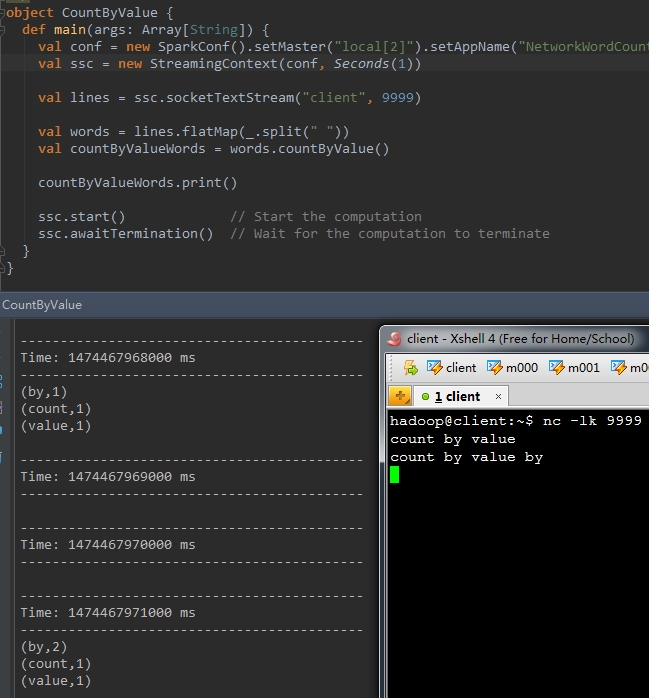
countByValue() |
计算DStream中每个RDD内的元素出现的频次并返回新的DStream[(K,Long)],其中K是RDD中元素的类型,Long是元素出现的频次。 |
|
reduceByKey(func, [numTasks]) |
当一个类型为(K,V)键值对的DStream被调用的时候,返回类型为类型为(K,V)键值对的新 DStream,其中每个键的值V都是使用聚合函数func汇总。注意:默认情况下,使用 Spark的默认并行度提交任务(本地模式下并行度为2,集群模式下位8),可以通过配置numTasks设置不同的并行任务数。 |
|
join(otherStream, [numTasks]) |
当被调用类型分别为(K,V)和(K,W)键值对的2个DStream 时,返回类型为(K,(V,W))键值对的一个新DSTREAM。 |
|
cogroup(otherStream, [numTasks]) |
当被调用的两个DStream分别含有(K, V) 和(K, W)键值对时,返回一个(K, Seq[V], Seq[W])类型的新的DStream。 |
|
transform(func) |
通过对源DStream的每RDD应用RDD-to-RDD函数返回一个新的DStream,这可以用来在DStream做任意RDD操作。 |
|
updateStateByKey(func) |
返回一个新状态的DStream,其中每个键的状态是根据键的前一个状态和键的新值应用给定函数func后的更新。这个方法可以被用来维持每个键的任何状态数据。 |
在上面列出的这些操作中,transform()方法和updateStateByKey()方法值得我们深入的探讨一下:
l transform(func)操作
该transform操作(转换操作)连同其其类似的 transformWith操作允许DStream 上应用任意RDD-to-RDD函数。它可以被应用于未在 DStream API 中暴露任何的RDD操作。例如,在每批次的数据流与另一数据集的连接功能不直接暴露在DStream API 中,但可以轻松地使用transform操作来做到这一点,这使得DStream的功能非常强大。例如,你可以通过连接预先计算的垃圾邮件信息的输入数据流(可能也有Spark生成的),然后基于此做实时数据清理的筛选,如下面官方提供的伪代码所示。事实上,也可以在transform方法中使用机器学习和图形计算的算法。
示例:
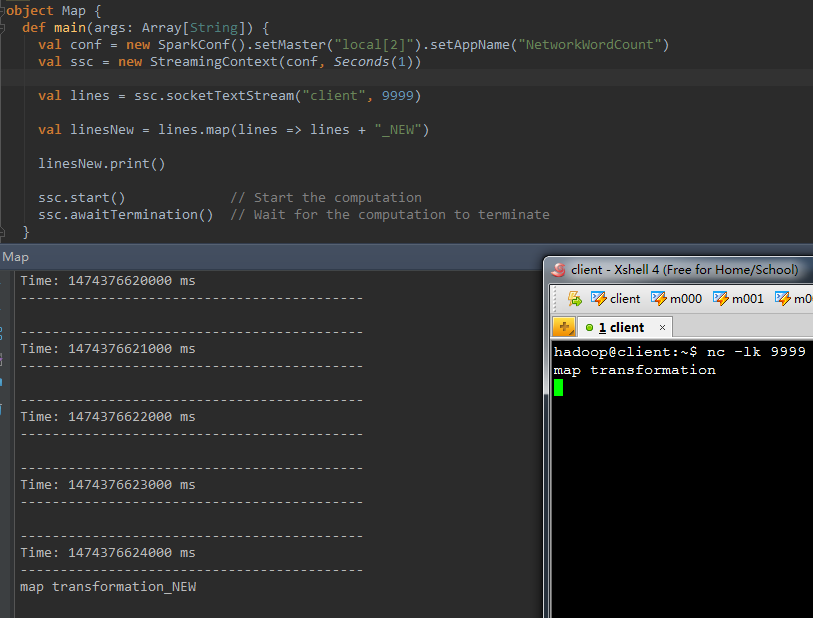
1、map(func)
val b = a.map(func)
val linesNew = lines.map(lines => lines + "_NEW" )
2、flatMap(func)
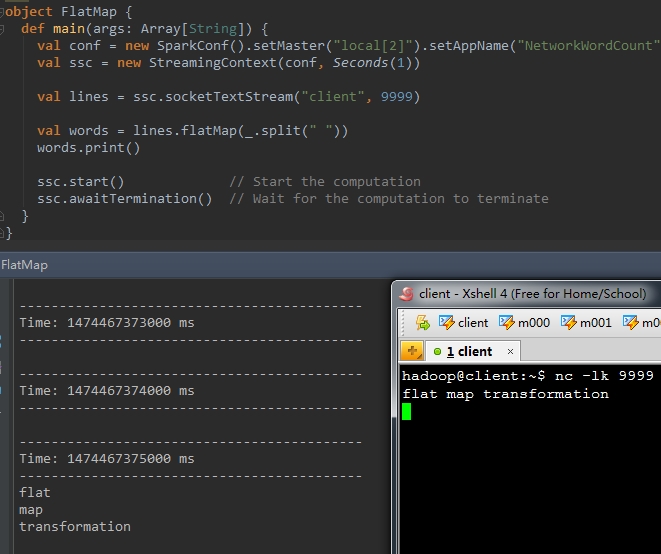
val b = a.flatMap(func)
val words = lines.flatMap(_.split( " " ))
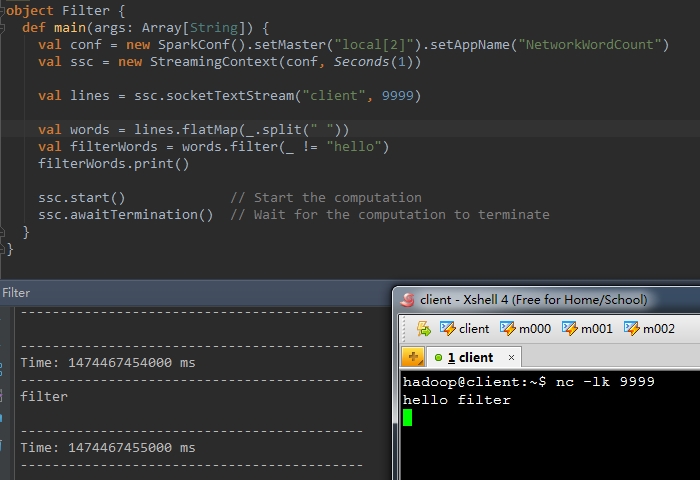
val b = a.filter(func)

val wordsOne = words.map(_ + "_one" )

val wordsTwo = words.map(_ + "_two" )

val unionWords = wordsOne.union(wordsTwo)

wordsOne.print()

wordsTwo.print()

unionWords.print()

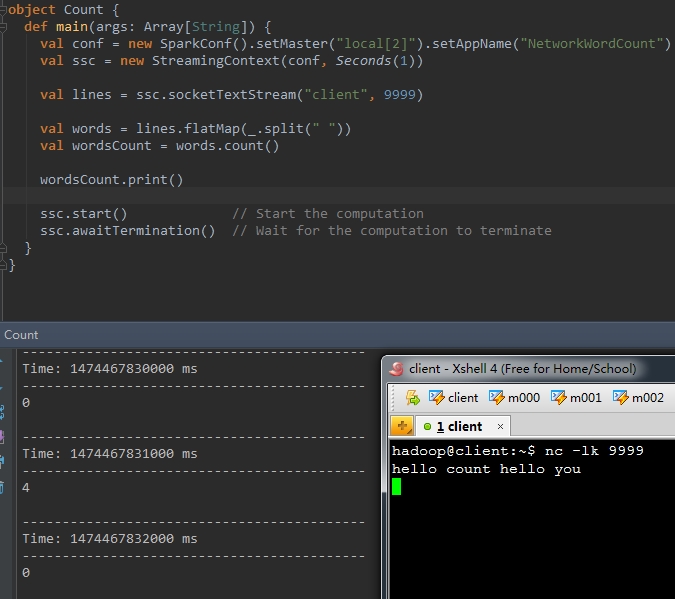
val wordsCount = words.count()
val reduceWords = words.reduce(_ + "-" + _)
val countByValueWords = words.countByValue()
val pairs = words.map(word => (word , 1))

val wordCounts = pairs.reduceByKey(_ + _)

val wordsOne = words.map(word => (word , word + "_one" ))

val wordsTwo = words.map(word => (word , word + "_two" ))

val joinWords = wordsOne.join(wordsTwo)


l updateStateByKey操作
该 updateStateByKey 操作可以让你保持任意状态,同时不断有新的信息进行更新。要使用此功能,必须进行两个步骤 :
(1) 定义状态 - 状态可以是任意的数据类型。
(2) 定义状态更新函数 - 用一个函数指定如何使用先前的状态和从输入流中获取的新值 更新状态。
让我们用一个例子来说明,假设你要进行文本数据流中单词计数。在这里,正在运行的计数是状态而且它是一个整数。我们定义了更新功能如下:

此函数应用于含有键值对的DStream中(如前面的示例中,在DStream中含有(word,1)键值对)。它会针对里面的每个元素(如wordCount中的word)调用一下更新函数,newValues是最新的值,runningCount是之前的值。

Spark Streaming之六:Transformations 普通的转换操作的更多相关文章
- Spark Streaming之一:整体介绍
提到Spark Streaming,我们不得不说一下BDAS(Berkeley Data Analytics Stack),这个伯克利大学提出的关于数据分析的软件栈.从它的视角来看,目前的大数据处理可 ...
- 初步了解Spark生态系统及Spark Streaming
一. 场景 ◆ Spark[4]: Scope: a MapReduce-like cluster computing framework designed for low-laten ...
- spark第六篇:Spark Streaming Programming Guide
预览 Spark Streaming是Spark核心API的扩展,支持高扩展,高吞吐量,实时数据流的容错流处理.数据可以从Kafka,Flume或TCP socket等许多来源获取,并且可以使用复杂的 ...
- Spark Streaming的编程模型
Spark Streaming的编程和Spark的编程如出一辙,对于编程的理解也非常类似.对于Spark来说,编程就是对于RDD的操作:而对于Spark Streaming来说,就是对DStream的 ...
- Spark Streaming:大规模流式数据处理的新贵(转)
原文链接:Spark Streaming:大规模流式数据处理的新贵 摘要:Spark Streaming是大规模流式数据处理的新贵,将流式计算分解成一系列短小的批处理作业.本文阐释了Spark Str ...
- Spark Streaming:大规模流式数据处理的新贵
转自:http://www.csdn.net/article/2014-01-28/2818282-Spark-Streaming-big-data 提到Spark Streaming,我们不得不说一 ...
- Spark Streaming之五:Window窗体相关操作
SparkStreaming之window滑动窗口应用,Spark Streaming提供了滑动窗口操作的支持,从而让我们可以对一个滑动窗口内的数据执行计算操作.每次掉落在窗口内的RDD的数据,会被聚 ...
- spark系列-8、Spark Streaming
参考链接:http://spark.apache.org/docs/latest/streaming-programming-guide.html 一.Spark Streaming 介绍 Spark ...
- Spark入门实战系列--7.Spark Streaming(上)--实时流计算Spark Streaming原理介绍
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark Streaming简介 1.1 概述 Spark Streaming 是Spa ...
随机推荐
- Django 事务
Django事务 事务是通过将一组相关操作组合为一个,要么全部成功要么全部失败的单元,可以简化错误恢复并使应用程序更加可靠.事务具有4个特性:原子性.一致性.隔离性.持久性. 默认情况下,在Djang ...
- Spring注解式与配置文件式
http://tom-seed.iteye.com/blog/1584632 Spring注解方式bean容器管理 1.通过在配置文件中配置spring组件注入 <context:compone ...
- 移动端web常见问题解决方案
meta基础知识 H5页面窗口自动调整到设备宽度,并禁止用户缩放页面 忽略将页面中的数字识别为电话号码 忽略Android平台中对邮箱地址的识别 当网站添加到主屏幕快速启动方式,可隐藏地址栏,仅针对i ...
- python基础5 ---python文件处理
python文件处理 一.文件处理的流程 打开文件,得到文件句柄并赋值给一个变量 通过句柄对文件进行操作 关闭文件 二.文件的操作方法 1.文件打开模式格式: 文件句柄 = open('文件路径', ...
- J.U.C重入锁
ReentrantLock重入锁 ReentrantLock是Java并发包中互斥锁,它有公平锁和非公平锁两种实现方式, 重入的意思就是,如果已经获得了锁,如果执行期间还需要获得这个锁的话,会直接获得 ...
- 关于scrollLeft的获取在不同浏览器或相同浏览器的不同版本下的获取
chrome61向w3c规则靠拢,document.body.scrollLeft获取的值一直为0,需要使用document.documentElement.scrollLeft(或document. ...
- Data Structure Array: Program for array rotation
http://www.geeksforgeeks.org/array-rotation/ O(n), O(1) #include <iostream> #include <vecto ...
- form memory cache、form disk cache与304
200 from memory cache 不访问服务器,直接读缓存,从内存中读取缓存.此时的数据时缓存到内存中的,当kill进程后,数据将不存在200 from disk cache 不访问服务器, ...
- noVNC
noNVC基础用法: 1.下载noVNC git clone https://github.com/novnc/noVNC.git 2.编辑qemu.conf配置文件 Vim /etc/libvirt ...
- SpringCloud之服务提供和服务调用的搭建
pom文件: <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3 ...