
Python图片识别——人工智能篇
一、安装pytesseract和PIL
PIL全称:Python Imaging Library,python图像处理库,这个库支持多种文件格式,并提供了强大的图像处理和图形处理能力。
由于PIL仅支持到Python 2.7,所以在PIL的基础上创建了Pillow库,支持最新Python 3.x。
1、pip命令安装
pip install pytesseract
pip install Pillow
2、使用pycharm编辑器安装,如下操作步骤。
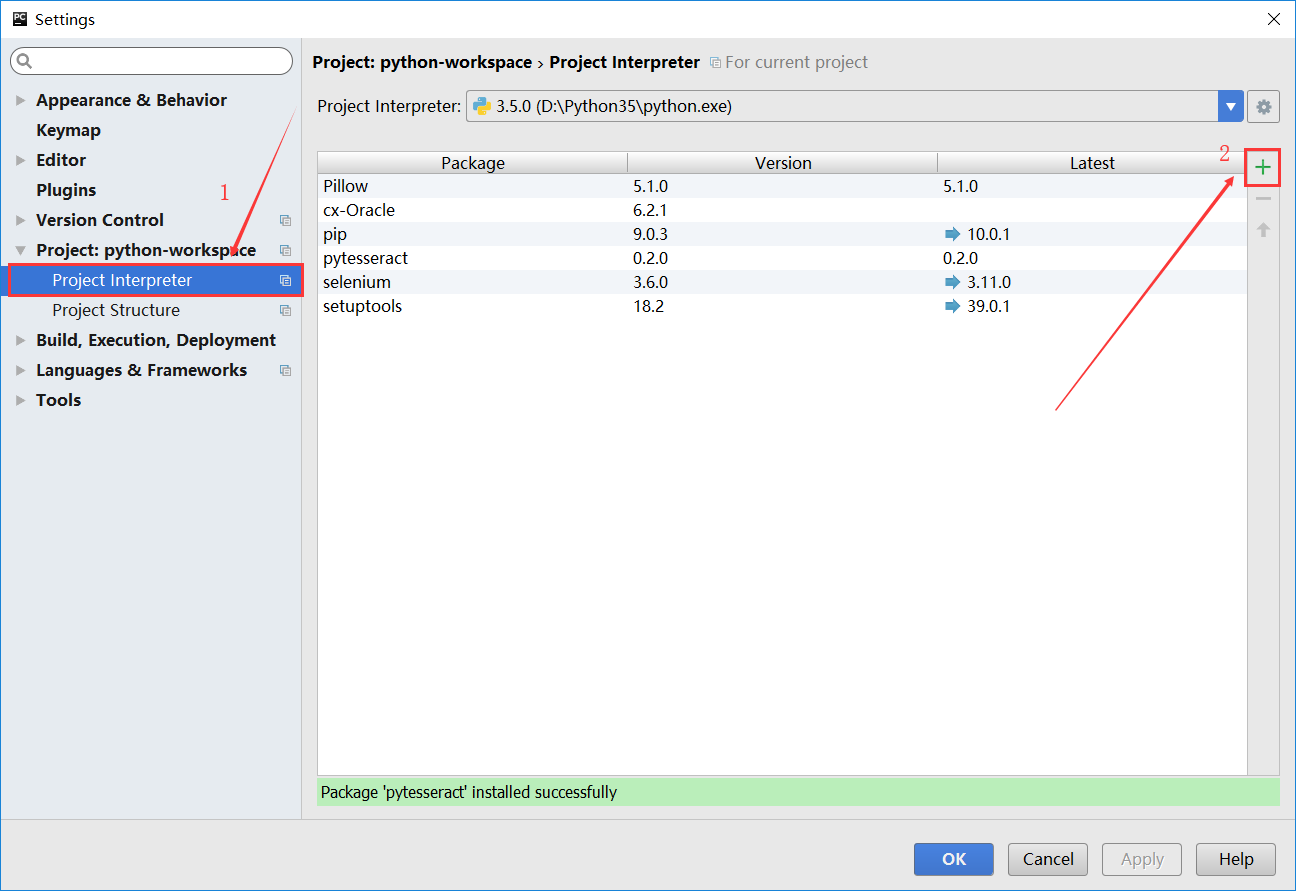

安装成功:
安装pytesseract时,同时安装pillow,所以我们只需安装pytesseract即可。
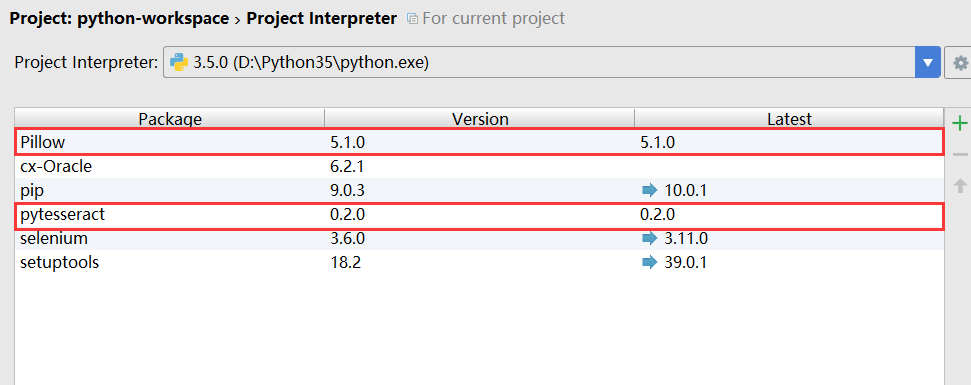
3.尝试运行,
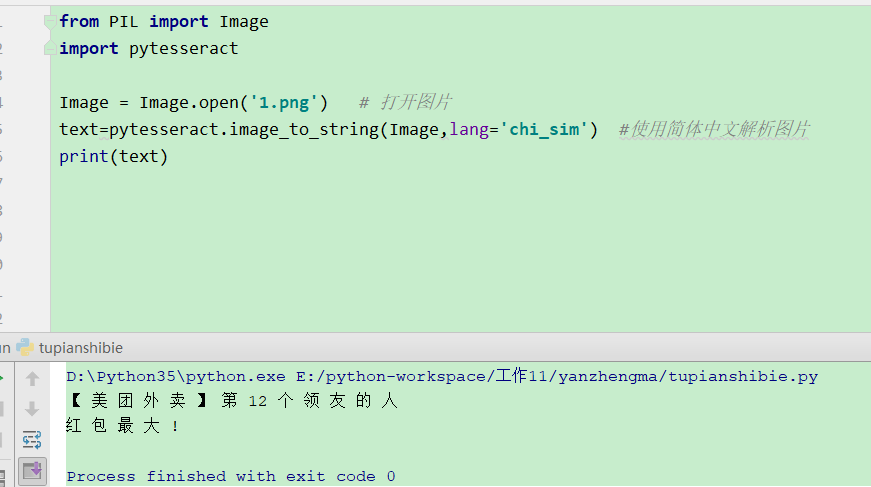
源码如下:
 from PIL import Image

 import pytesseract

 Image = Image.open('1.png')   # 打开图片

 text = pytesseract.image_to_string(Image,lang='chi_sim')  #使用简体中文解析图片

 print(text)
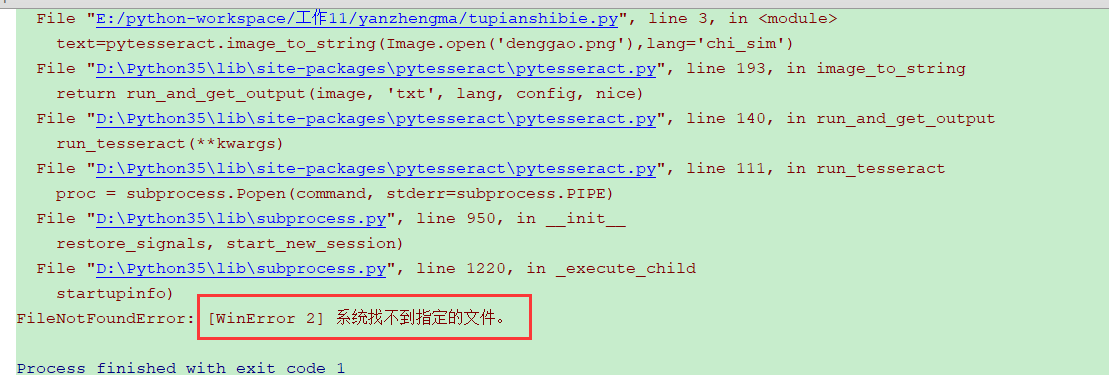
出现报错,如下图,
原因:没有安装识别引擎tesseract-ocr
二、安装识别引擎tesseract-ocr
1.Tesseract是开源的OCR引擎。Tesseract最初设计用于英文识别,经过改进引擎和训练系统,它能够处理其它语言和UTF-8字符。Tesseract 3.0能够处理任何Unicode字符,但并非在所有语言上都工作得很好。Tesseract在庞大字符集语言(比如中文)上较慢,但是工作良好。
下载链接: https://pan.baidu.com/s/1J0HNoVhX8WexS_5r0k2jDw 密码: ywc3

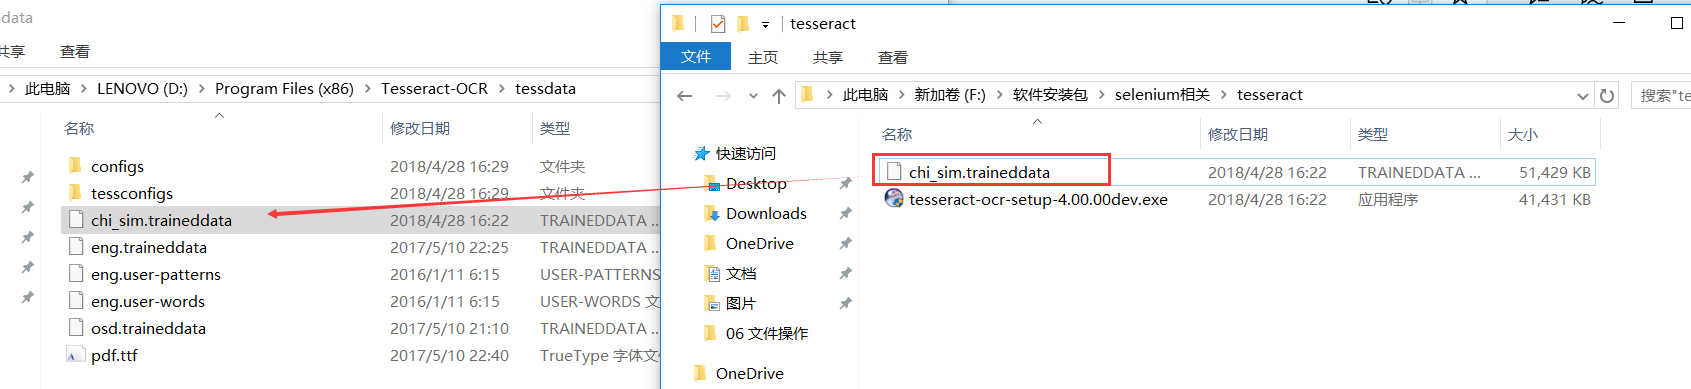
因为tesseract-ocr默认不支持中文识别。
将下载到的文件:chi_sim.traineddata 放到Tesseract-OCR安装目录 D:\Program Files (x86)\Tesseract-OCR\tessdata 下,如图:
2,安装完成tesseract-ocr后,需要做一下配置 。
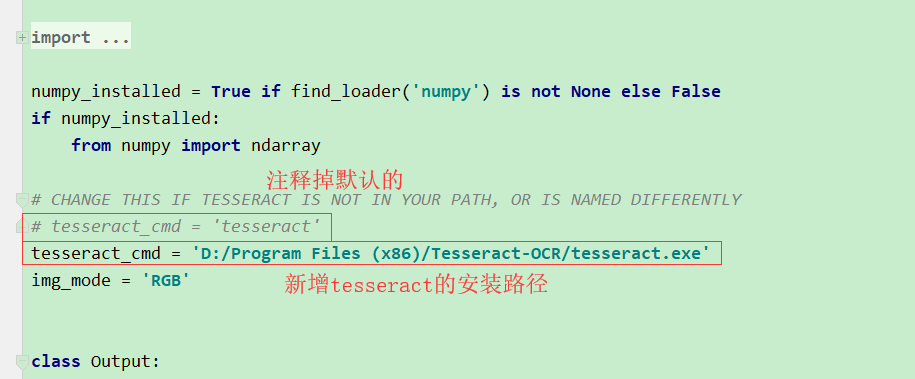
在Python安装目录(如:D:\Python35\Lib\site-packages\pytesseract) 中修改 pytesseract.py文件。
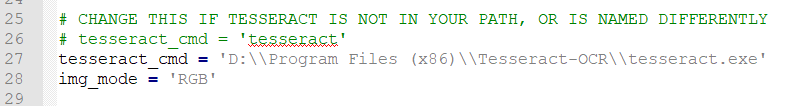
也可以通过pycharm,Ctrl+B 快速打开pytesseract源码文件:
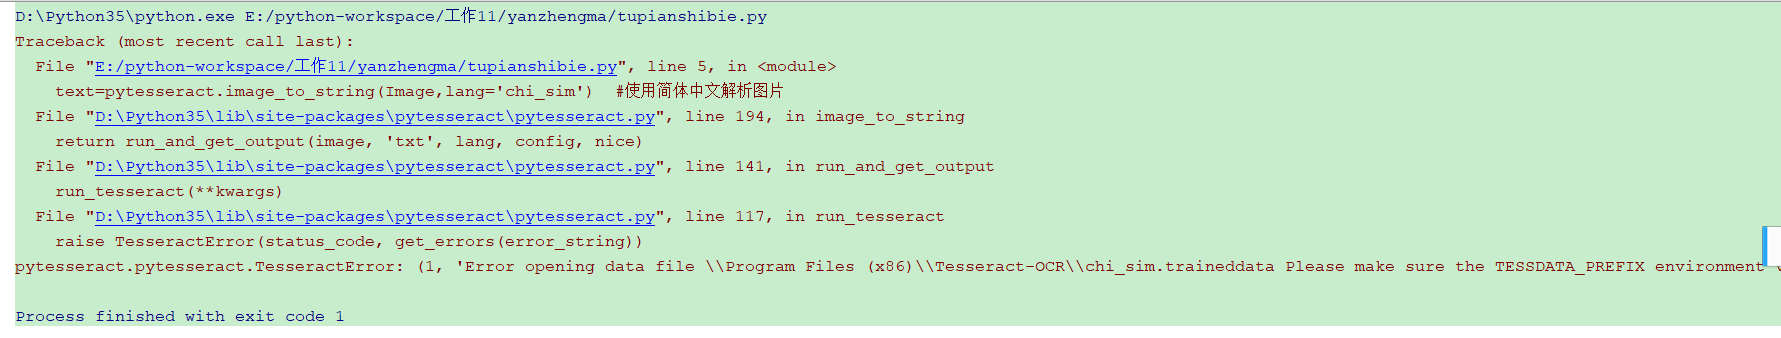
3.尝试运行,出现如下报错:
pytesseract.pytesseract.TesseractError: (1, 'Error opening data file \\Program Files (x86)\\Tesseract-OCR\\chi_sim.traineddata Please make sure the TESSDATA_PREFIX environment variable is set to your "tessdata" directory. Failed loading language \'chi_sim\' Tesseract couldn\'t load any languages! Could not initialize tesseract.')
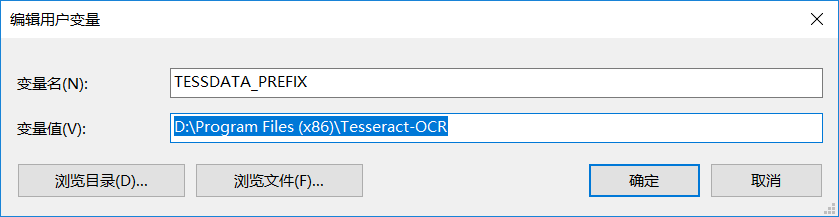
4.解决方法:将tessdata目录的上级目录所在路径:(默认为tesseract-ocr安装目录)添加至TESSDATA_PREFIX环境变量中,如下图:
注意:配置完环境变量需要重新打开pycharm编辑器(IDE)。
5.再次运行结果:图片识别成功!
但识别率不是很高,后期优化,持续更新。
Python图片识别——人工智能篇的更多相关文章
- python图片识别
python 图像处理模块1. 安装 pytesseract模块是会自动安装Pillow模块.pillow 为标准图像处理库 手册地址 http://pillow-cn.readthedocs.io/ ...
- Python图片识别找坐标(appium通过识别图片点击坐标)
***如果只想了解图片相似度识别,直接看第一步即可 ***如果想了解appium根据图片识别点击坐标,需要看第一.二.三步 背景|在做UI测试时,发现iOS自定义的UI控件,appium识别不到. ...
- 基于python图片识别工具(图片识别,车牌,PDF,验证码)
先上图 不多说. 对于一般的用户来说识别率还是能达到百分之90以上. 已经打包成exe文件.windows用户可以直接使用.要软件的加我QQ python代码: # -*- coding: UTF- ...
- python 图片识别灰度
# -*- coding: cp936 -*- from skimage import io,transform,color import numpy as np def convert_gray(f ...
- Python 图片识别
Tesseract是开源的OCR引擎. 需要安装tesserocr.opencv-python.tesseract-ocr pip install tesserocr pip install open ...
- Python人工智能之图片识别,Python3一行代码实现图片文字识别
1.Python人工智能之图片识别,Python3一行代码实现图片文字识别 2.tesseract-ocr安装包和中文语言包 注意:
- 用python实现数字图片识别神经网络--启动网络的自我训练流程,展示网络数字图片识别效果
上一节,我们完成了网络训练代码的实现,还有一些问题需要做进一步的确认.网络的最终目标是,输入一张手写数字图片后,网络输出该图片对应的数字.由于网络需要从0到9一共十个数字中挑选出一个,于是我们的网络最 ...
- 【基于WPF+OneNote+Oracle的中文图片识别系统阶段总结】之篇一:WPF常用知识以及本项目设计总结
篇一:WPF常用知识以及本项目设计总结:http://www.cnblogs.com/baiboy/p/wpf.html 篇二:基于OneNote难点突破和批量识别:http://www.cnblog ...
- 【基于WPF+OneNote+Oracle的中文图片识别系统阶段总结】之篇二:基于OneNote难点突破和批量识别
篇一:WPF常用知识以及本项目设计总结:http://www.cnblogs.com/baiboy/p/wpf.html 篇二:基于OneNote难点突破和批量识别:http://www.cnblog ...
随机推荐
- 洛谷 2216 [HAOI2007]理想的正方形
题目戳这里 一句话题意 给你一个a×b的矩形,求一个n×n的子矩阵,矩阵里面的最大值和最小值之差最小. Solution 这个题目许多大佬都是单调队列,但是我不是很会,只好用了比较傻逼的方法: 首先我 ...
- LOJ#10117. 「一本通 4.1 练习 2」简单题
LOJ#10117. 「一本通 4.1 练习 2」简单题 题目描述 题目来源:$CQOI 2006$ 有一个$n$个元素的数组,每个元素初始均为$0$.有$m$条指令,要么让其中一段连续序列数字反转— ...
- spring mvc 基本原理
在web.xml配置spring mvc入口servlet: <servlet> <servlet-name>mvc-dispatcher</servlet-name&g ...
- Js中的apply和call
1.call和apply都是为了改变某个函数运行时的上下文而存在的 2.也就是改变函数体内this的指向. 3.二者的作用完全一样,只是接受参数的方式不太一样. 4.call 需要把参数按顺序传递进去 ...
- Nvidia NVENC 硬编码预研总结
本篇博客记录NVENC硬编码的预研过程 github: https://github.com/MarkRepo/NvencEncoder 步骤如下: (1)环境搭建 (2)demo编译,测试,ARG ...
- Django模型系统——ORM
一.概论 1.ORM概念 对象关系映射(Object Relational Mapping,简称ORM)模式是一种为了解决面向对象与关系数据库存在的互不匹配的现象的技术. 简单的说,ORM是通过使用描 ...
- 改善程序与设计的55个具体做法 day3
条款07:为多态基类声明virtual析构函数 任何一本C++语法教材上都会讲这一点(如果没讲,扔掉它),这么做到原因是可以让delete pBase操作能够正确的执行子类的析构函数. 需要说明的是当 ...
- UVALive - 6257 K - Chemist's vows 【DFS】【BFS】【DP】
题目链接 https://icpcarchive.ecs.baylor.edu/index.php?option=com_onlinejudge&Itemid=8&page=show_ ...
- 利用Tkinter做的自动生成JSONSchema的小工具
前面讲到可以使用JSONSchema做json数据校验, 但是每个接口数据都手动写jsonschema太痛苦了, 就写了个小脚本,可以直接复制接口文档的mock数据然后生成一个简单的jsonschem ...
- Luogu-1381 单词背诵
先将n个单词插入哈希表,记录左右端点,每次右端点往后移动,读入一个新的单词并记录下它的哈希值,如果这个单词之前没出现过那么更新\(ans\)和\(minl\),如果左端点的单词出现了不止一次则可以往右 ...