
DataNode(面试开发重点)
1 DataNode工作机制
DataNode工作机制,如图所示。
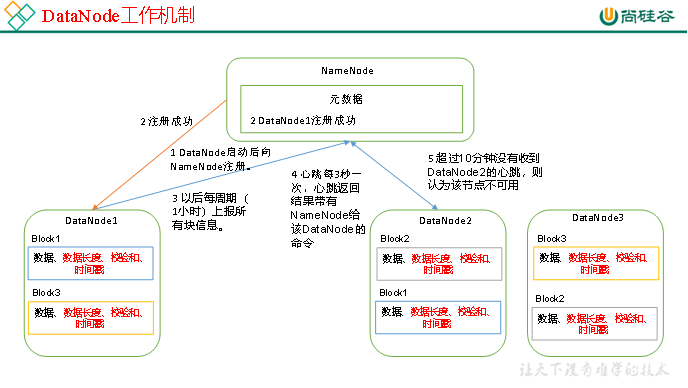
1)一个数据块在DataNode上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和,以及时间戳。
2)DataNode启动后向NameNode注册,通过后,周期性(1小时)的向NameNode上报所有的块信息。
3)心跳是每3秒一次,心跳返回结果带有NameNode给该DataNode的命令如复制块数据到另一台机器,或删除某个数据块。如果超过10分钟没有收到某个DataNode的心跳,则认为该节点不可用。
4)集群运行中可以安全加入和退出一些机器。
2 数据完整性
思考:如果电脑磁盘里面存储的数据是控制高铁信号灯的红灯信号(1)和绿灯信号(0),但是存储该数据的磁盘坏了,一直显示是绿灯,是否很危险?同理DataNode节点上的数据损坏了,却没有发现,是否也很危险,那么如何解决呢?
如下是DataNode节点保证数据完整性的方法。
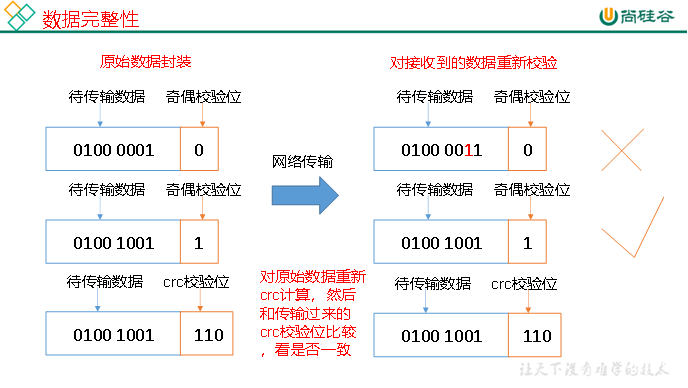
1)当DataNode读取Block的时候,它会计算CheckSum。
2)如果计算后的CheckSum,与Block创建时值不一样,说明Block已经损坏。
3)Client读取其他DataNode上的Block。
4)DataNode在其文件创建后周期验证CheckSum,如图所示。
3 掉线时限参数设置
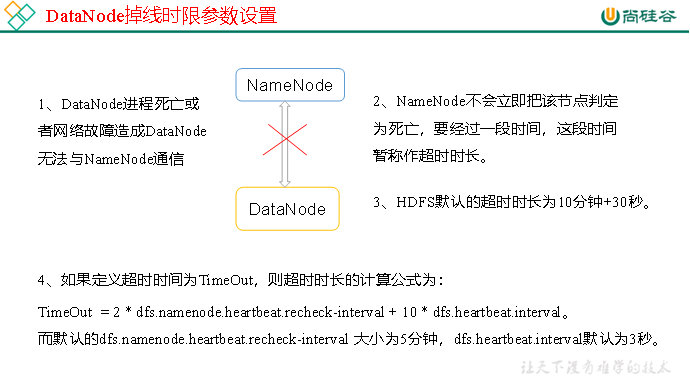
需要注意的是hdfs-site.xml 配置文件中的heartbeat.recheck.interval的单位为毫秒,dfs.heartbeat.interval的单位为秒。
<property>

    <name>dfs.namenode.heartbeat.recheck-interval</name>

    <value>300000</value>

</property>

<property>

    <name>dfs.heartbeat.interval</name>

    <value>3</value>

</property>
4 服役新数据节点
0. 需求
随着公司业务的增长,数据量越来越大,原有的数据节点的容量已经不能满足存储数据的需求,需要在原有集群基础上动态添加新的数据节点。
1. 环境准备
(1)在hadoop104主机上再克隆一台hadoop105主机
(2)修改IP地址和主机名称
(3)删除原来HDFS文件系统留存的文件(/opt/module/hadoop-2.7.2/data和log)
(4)source一下配置文件
[atguigu@hadoop105 hadoop-2.7.]$ source /etc/profile
2. 服役新节点具体步骤
(1)直接启动DataNode,即可关联到集群
[atguigu@hadoop105 hadoop-2.7.]$ sbin/hadoop-daemon.sh start datanode

[atguigu@hadoop105 hadoop-2.7.]$ sbin/yarn-daemon.sh start nodemanager
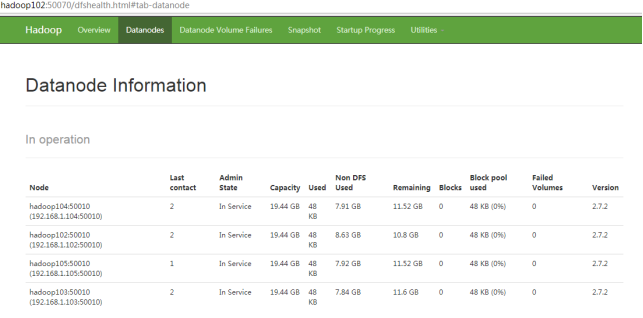
(2)在hadoop105上上传文件
[atguigu@hadoop105 hadoop-2.7.]$ hadoop fs -put /opt/module/hadoop-2.7./LICENSE.txt /
(3)如果数据不均衡,可以用命令实现集群的再平衡
[atguigu@hadoop102 sbin]$ ./start-balancer.sh

starting balancer, logging to /opt/module/hadoop-2.7./logs/hadoop-atguigu-balancer-hadoop102.out

Time Stamp               Iteration#  Bytes Already Moved  Bytes Left To Move  Bytes Being Moved
5 退役旧数据节点
5.1 添加白名单
添加到白名单的主机节点,都允许访问NameNode,不在白名单的主机节点,都会被退出。
配置白名单的具体步骤如下:
(1)在NameNode的/opt/module/hadoop-2.7.2/etc/hadoop目录下创建dfs.hosts文件
[atguigu@hadoop102 hadoop]$ pwd

/opt/module/hadoop-2.7./etc/hadoop

[atguigu@hadoop102 hadoop]$ touch dfs.hosts

[atguigu@hadoop102 hadoop]$ vi dfs.hosts
添加如下主机名称(不添加hadoop105)
hadoop102

hadoop103

hadoop104
(2)在NameNode的hdfs-site.xml配置文件中增加dfs.hosts属性
<property>

<name>dfs.hosts</name>

<value>/opt/module/hadoop-2.7.2/etc/hadoop/dfs.hosts</value>

</property>
(3)配置文件分发
[atguigu@hadoop102 hadoop]$ xsync hdfs-site.xml
(4)刷新NameNode
[atguigu@hadoop102 hadoop-2.7.2]$ hdfs dfsadmin -refreshNodes
Refresh nodes successful
(5)更新ResourceManager节点
[atguigu@hadoop102 hadoop-2.7.]$ yarn rmadmin -refreshNodes

// :: INFO client.RMProxy: Connecting to ResourceManager at hadoop103/192.168.1.103:
(6)在web浏览器上查看
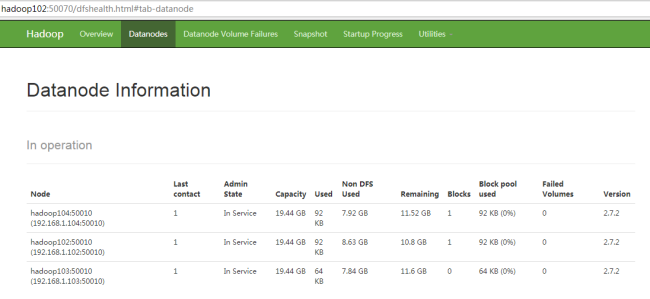
4. 如果数据不均衡,可以用命令实现集群的再平衡
[atguigu@hadoop102 sbin]$ ./start-balancer.sh

starting balancer, logging to /opt/module/hadoop-2.7./logs/hadoop-atguigu-balancer-hadoop102.out

Time Stamp               Iteration#  Bytes Already Moved  Bytes Left To Move  Bytes Being Moved
5.2 黑名单退役
在黑名单上面的主机都会被强制退出。
1.在NameNode的/opt/module/hadoop-2.7.2/etc/hadoop目录下创建dfs.hosts.exclude文件
[atguigu@hadoop102 hadoop]$ pwd

/opt/module/hadoop-2.7./etc/hadoop

[atguigu@hadoop102 hadoop]$ touch dfs.hosts.exclude

[atguigu@hadoop102 hadoop]$ vi dfs.hosts.exclude
添加如下主机名称(要退役的节点)
hadoop105
2.在NameNode的hdfs-site.xml配置文件中增加dfs.hosts.exclude属性
<property>

<name>dfs.hosts.exclude</name>

      <value>/opt/module/hadoop-2.7./etc/hadoop/dfs.hosts.exclude</value>

</property>
3.刷新NameNode、刷新ResourceManager
[atguigu@hadoop102 hadoop-2.7.]$ hdfs dfsadmin -refreshNodes

Refresh nodes successful

[atguigu@hadoop102 hadoop-2.7.]$ yarn rmadmin -refreshNodes

// :: INFO client.RMProxy: Connecting to ResourceManager at hadoop103/192.168.1.103:
4. 检查Web浏览器,退役节点的状态为decommission in progress(退役中),说明数据节点正在复制块到其他节点,如图所示

5.等待退役节点状态为decommissioned(所有块已经复制完成),停止该节点及节点资源管理器。注意:如果副本数是3,服役的节点小于等于3,是不能退役成功的,需要修改副本数后才能退役,如图所示

[atguigu@hadoop105 hadoop-2.7.]$ sbin/hadoop-daemon.sh stop datanode
stopping datanode
[atguigu@hadoop105 hadoop-2.7.]$ sbin/yarn-daemon.sh stop nodemanager
stopping nodemanager
6. 如果数据不均衡,可以用命令实现集群的再平衡
[atguigu@hadoop102 hadoop-2.7.]$ sbin/start-balancer.sh

starting balancer, logging to /opt/module/hadoop-2.7./logs/hadoop-atguigu-balancer-hadoop102.out

Time Stamp               Iteration#  Bytes Already Moved  Bytes Left To Move  Bytes Being Moved
注意:不允许白名单和黑名单中同时出现同一个主机名称。
6 Datanode多目录配置
1. DataNode也可以配置成多个目录,每个目录存储的数据不一样。即:数据不是副本
2.具体配置如下
hdfs-site.xml
<property>

        <name>dfs.datanode.data.dir</name>

<value>file:///${hadoop.tmp.dir}/dfs/data1,file:///${hadoop.tmp.dir}/dfs/data2</value>

</property>
DataNode(面试开发重点)的更多相关文章
- NameNode和SecondaryNameNode(面试开发重点)
NameNode和SecondaryNameNode(面试开发重点) 1 NN和2NN工作机制 思考:NameNode中的元数据是存储在哪里的? 首先,我们做个假设,如果存储在NameNode节点的磁 ...
- HDFS的数据流读写数据 (面试开发重点)
1 HDFS写数据流程 1.1 剖析文件写入 HDFS写数据流程,如图所示 1)客户端通过Distributed FileSystem模块向NameNode请求上传文件,NameNode检查目标文件是 ...
- Android开发重点难点1:RelativeLayout(相对布局)详解
前言 啦啦啦~博主又推出了一个新的系列啦~ 之前的Android开发系列主要以完成实验的过程为主,经常会综合许多知识来写,所以难免会有知识点的交杂,给人一种混乱的感觉. 所以博主推出“重点难点”系列, ...
- Android开发重点难点:RelativeLayout(相对布局)详解
https://i.cnblogs.com/EditPosts.aspx?opt=1 重点知识 和线性布局(LinearLayout)一样,RelaiveLayout相对布局也是我们用的比较多的一个布 ...
- scrum敏捷开发重点介绍
参考: http://www.scrumcn.com/agile/scrum-knowledge-library/scrum.html https://www.zhihu.com/question/3 ...
- MySql 面试开发技术点汇总
表结构设计 1.为什么一定要设一个主键? 答:因为你不设主键的情况下,innodb也会帮你生成一个隐藏列,作为自增主键.所以啦,反正都要生成一个主键,那你还不如自己指定一个主键,在有些情况下,就能显 ...
- Vue开发重点基础知识
1.Vuejs组件 vuejs构建组件使用 Vue.component('componentName',{ /*component*/ }): 这里注意一点,组件要先注册再使用,也就是说: Vue.c ...
- 史上最强vue总结~万字长文---面试开发全靠它了
vue框架篇 vue的优点 轻量级框架:只关注视图层,是一个构建数据的视图集合,大小只有几十kb: 简单易学:国人开发,中文文档,不存在语言障碍 ,易于理解和学习: 双向数据绑定:保留了angular ...
- MyBatis开发重点知识
1.1为什么需要ORM框架? 传统的JDBC编程存在的弊端: ü 工作量大,操作数据库至少要5步: ü 业务代码和技术代码耦合: ü 连接资源手动关闭,带来了隐患: MyBatis前身是iBatis, ...
随机推荐
- 微型计算机系统实验总结(学习性实验:IO地址译码,可编程并行接口8255,交通灯控制实验 + 自主设计实验:汽车信号灯控制系统,电风扇控制器,洗衣机控制系统,霓虹灯,电梯控制系统)
实验配套软件: https://download.csdn.net/download/qq_39932172/11221584 实验指导用书: 教师版: https://download.csdn.n ...
- ubuntu 12.04无盘工作站
注释:该篇博文是借鉴下列文章加上自己实践总结得来: a. http://forum.ubuntu.org.cn/viewtopic.php?f=77&t=117754 b. http://bl ...
- flask中的endpoint是什么
app.view_functions 是一个字典,里面是存储的是 endpoint 与 视图函数的键值对,如果没指名函数视图的endpoint,默认是函数名,而 url_map 是一个列表,里面是ur ...
- seaborn分类数据可视化:散点图|箱型图|小提琴图|lv图|柱状图|折线图
一.散点图stripplot( ) 与swarmplot() 1.分类散点图stripplot( ) 用法stripplot(x=None, y=None, hue=None, data=None, ...
- 花生壳内网穿透vue项目错误
原因:新版的webpack-dev-server出于安全考虑,默认检查hostname,如果hostname不是配置内的,将中断访问. 解决:webpack.dev.conf.js添加配置 disab ...
- PHP restore_exception_handler() 函数
定义和用法 restore_exception_handler() 函数恢复之前的异常处理程序. 该函数用于在通过 set_exception_handler() 函数改变后恢复之前的异常处理程序. ...
- PHP scandir() 函数
------------恢复内容开始------------ 实例 列出 images 目录中的文件和目录: <?php$dir = "/images/"; // Sort ...
- P6222 「简单题」加强版 莫比乌斯反演 线性筛积性函数
LINK:简单题 以前写过弱化版的 不过那个实现过于垃圾 少预处理了一个东西. 这里写一个实现比较精细了. 最后可推出式子:\(\sum_{T=1}^nsum(\frac{n}{T})\sum_{x| ...
- EC R 87 div2 D. Multiset 线段树 树状数组 二分
LINK:Multiset 主要点一下 二分和树状数组找第k大的做法. 线段树的做法是平凡的 开一个数组实现就能卡过. 考虑如树状数组何找第k大 二分+查询来判定是不优秀的. 考虑树状数组上倍增来做. ...
- 海华大赛第一名团队聊比赛经验和心得:AI在垃圾分类中的应用
摘要:为了探究垃圾的智能分类等问题,由中关村海华信息研究院.清华大学交叉信息研究院以及Biendata举办的2020海华AI垃圾分类大赛吸引了大量工程师以及高校学生的参与 01赛题介绍 随着我国经济的 ...