
【Spark】快来学习RDD的创建以及操作方式吧!
目录
RDD的创建
三种方式
从一个集合中创建
val rdd1 = sc.parallelize(Array(1,2,3,4,5,6,7,8))
从文件中创建
val rdd2 = sc.textFile("/words.txt")
从其他的RDD转化而来
val rdd3=rdd2.flatMap(_.split(" "))
RDD编程常用API
算子分类
Transformation
概述
Transformation —— 根据数据集创建一个新的数据集,计算后返回一个新的RDD,但不会直接返回计算结果,二是记住这些应用到数据集(例如一个文件)上的转换动作,只有当发生一个要求返回结果给Driver的动作是,这些转换才会真正运行。
帮助文档
http://spark.apache.org/docs/2.2.0/rdd-programming-guide.html#transformations
常用Transformation表
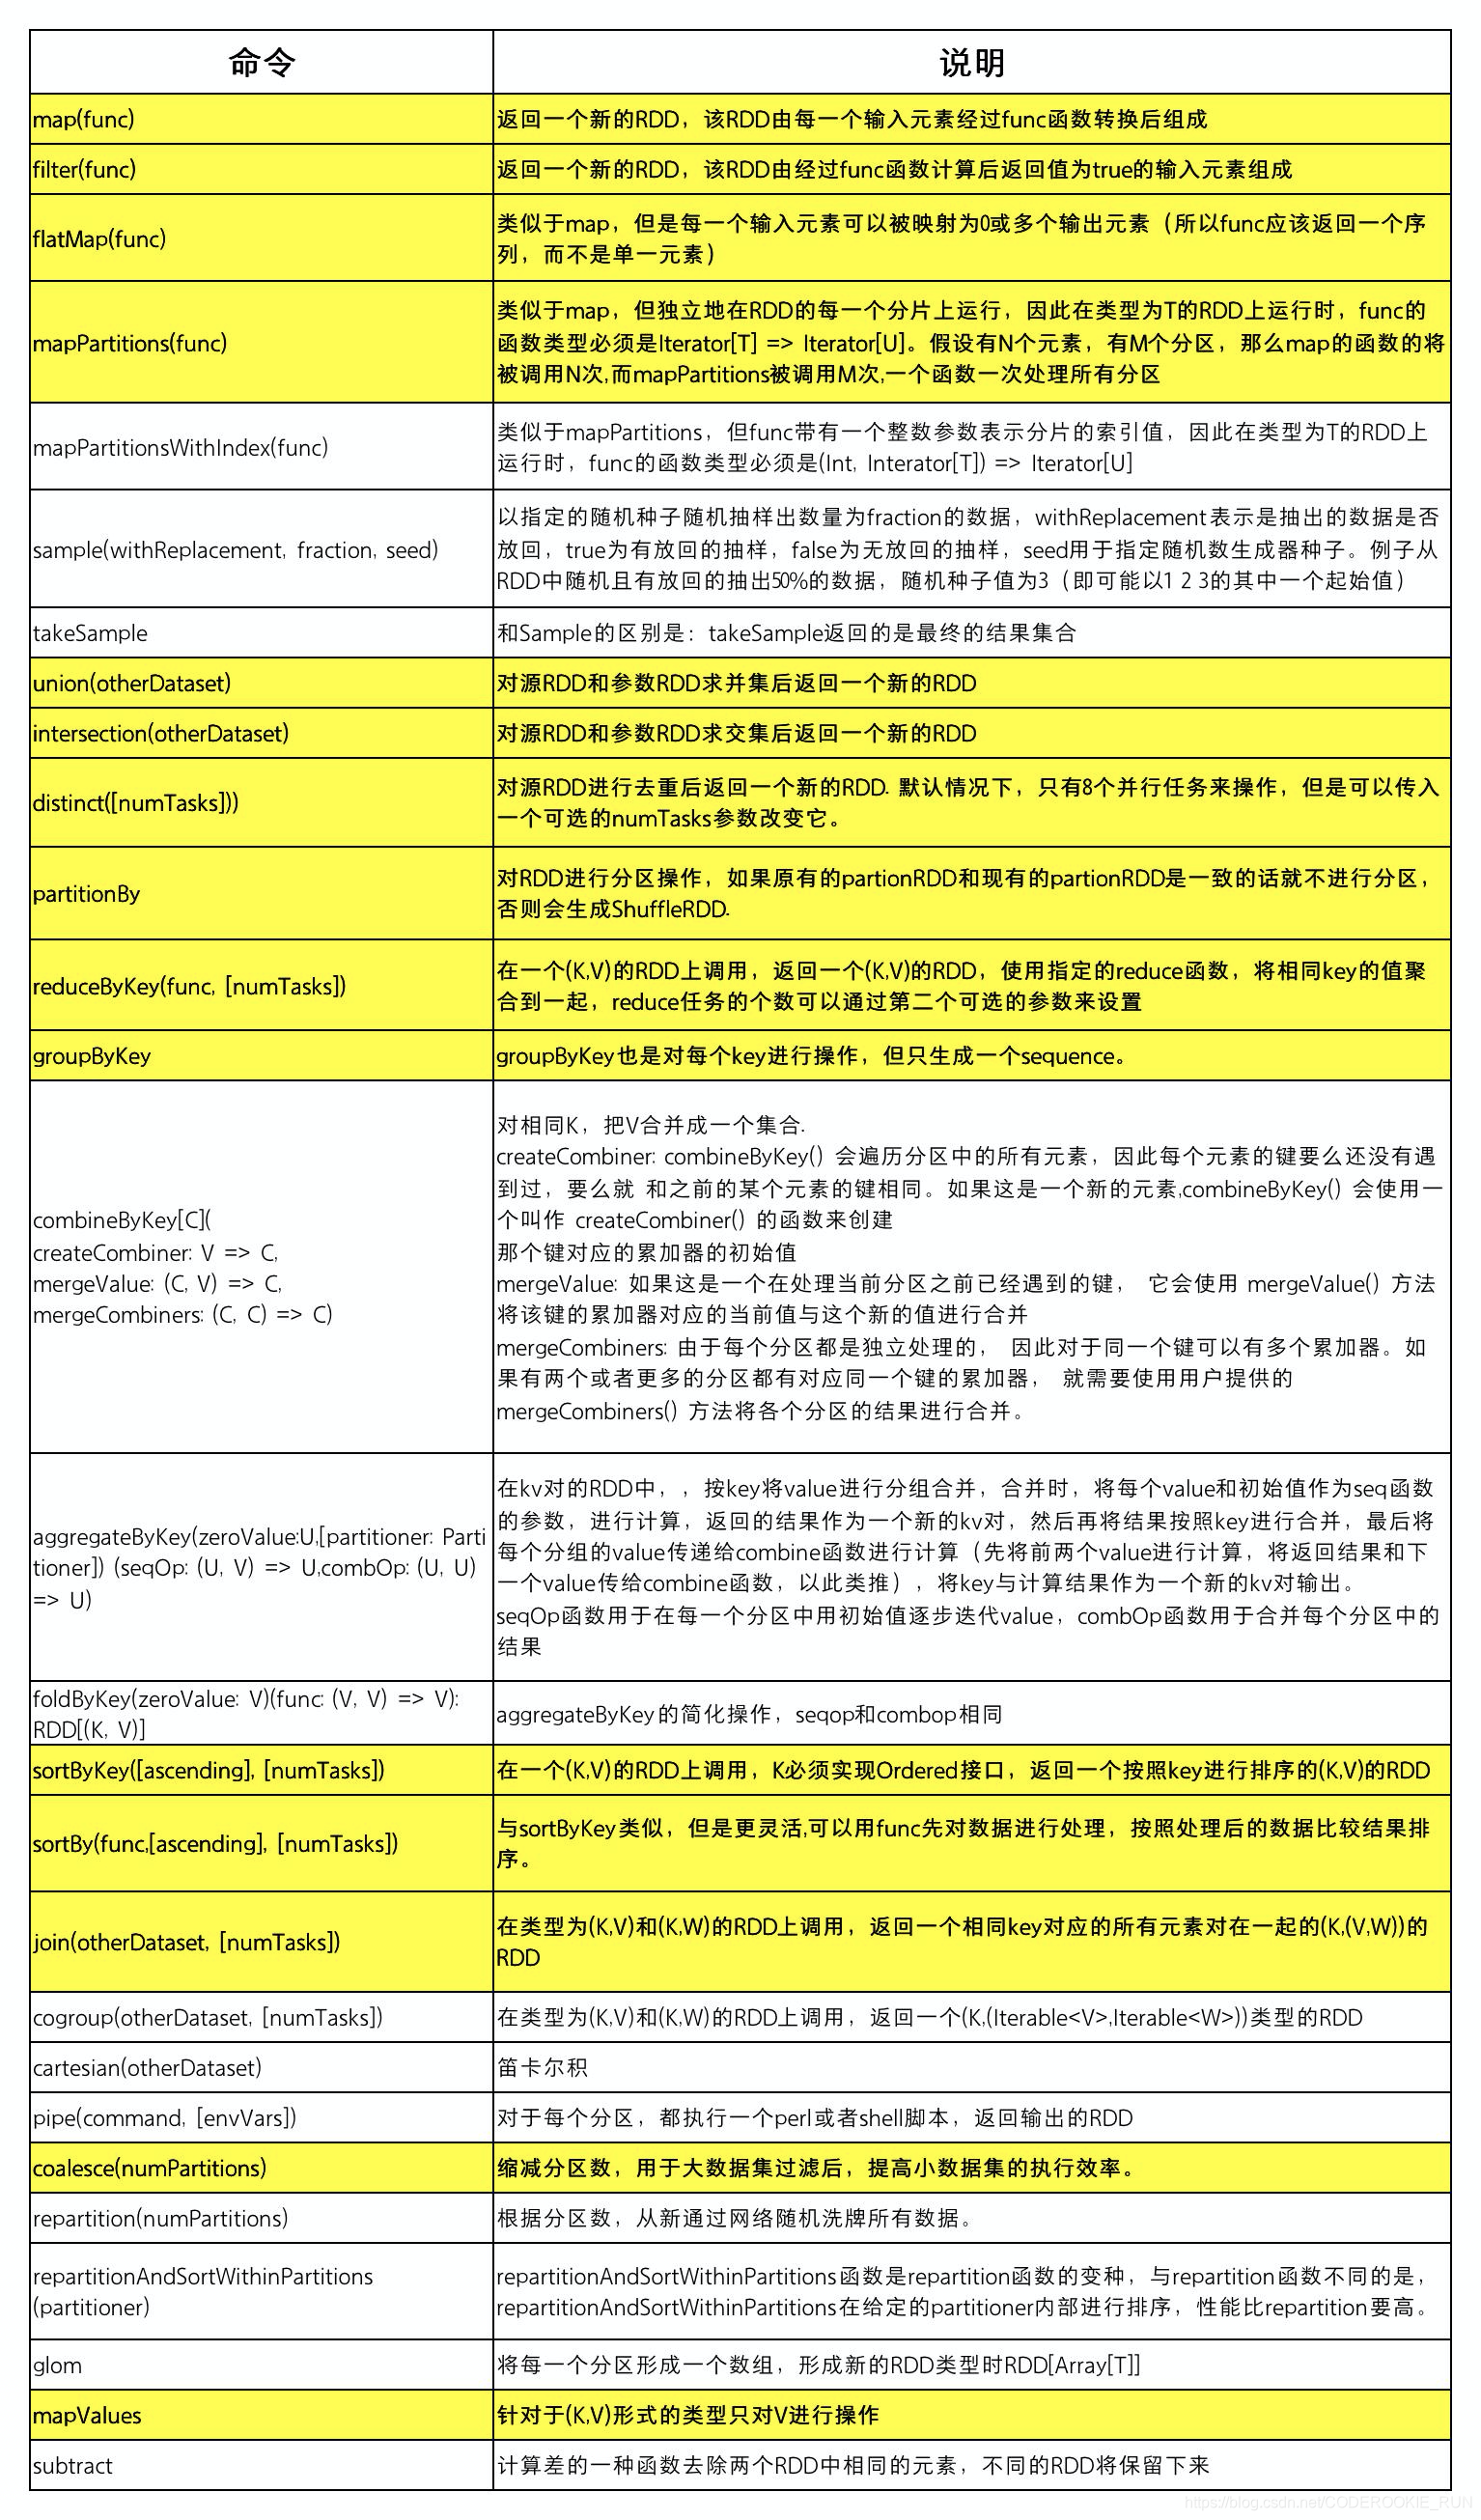
Transformation使用实例
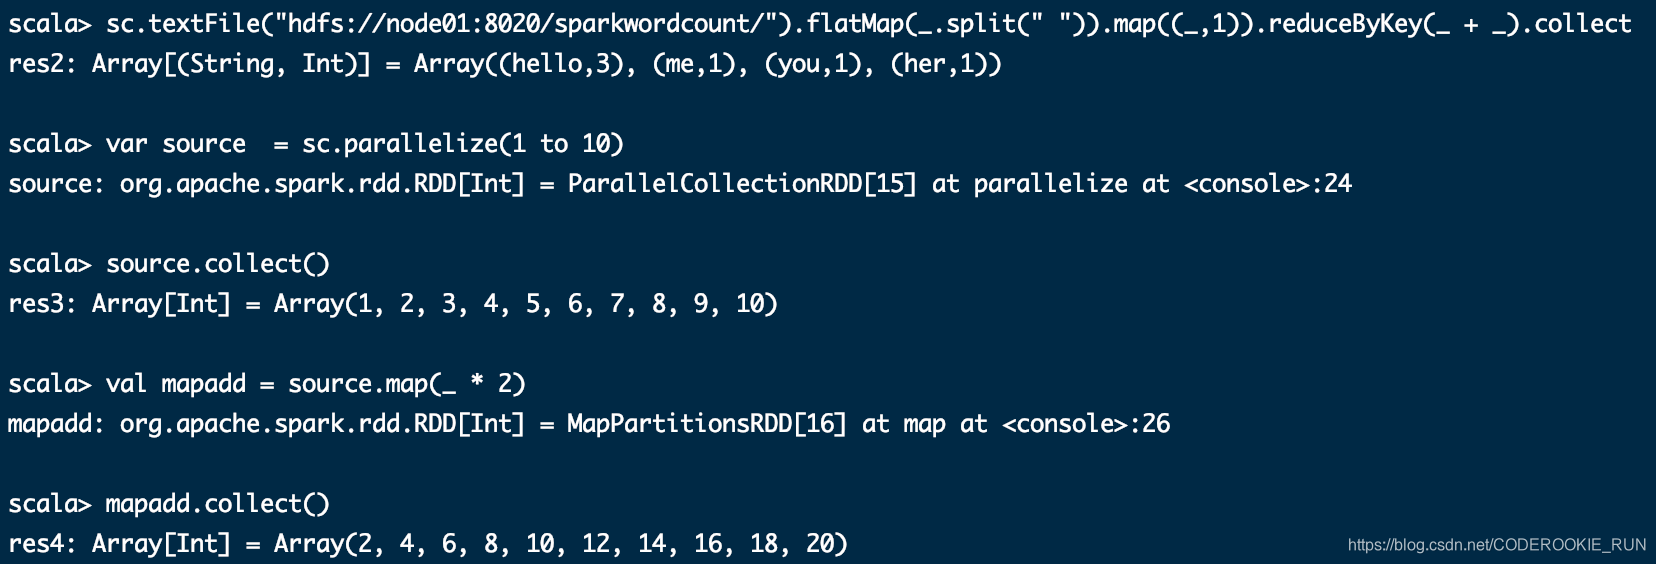
map(func)
将分区里面每一条数据取出来,进行处理
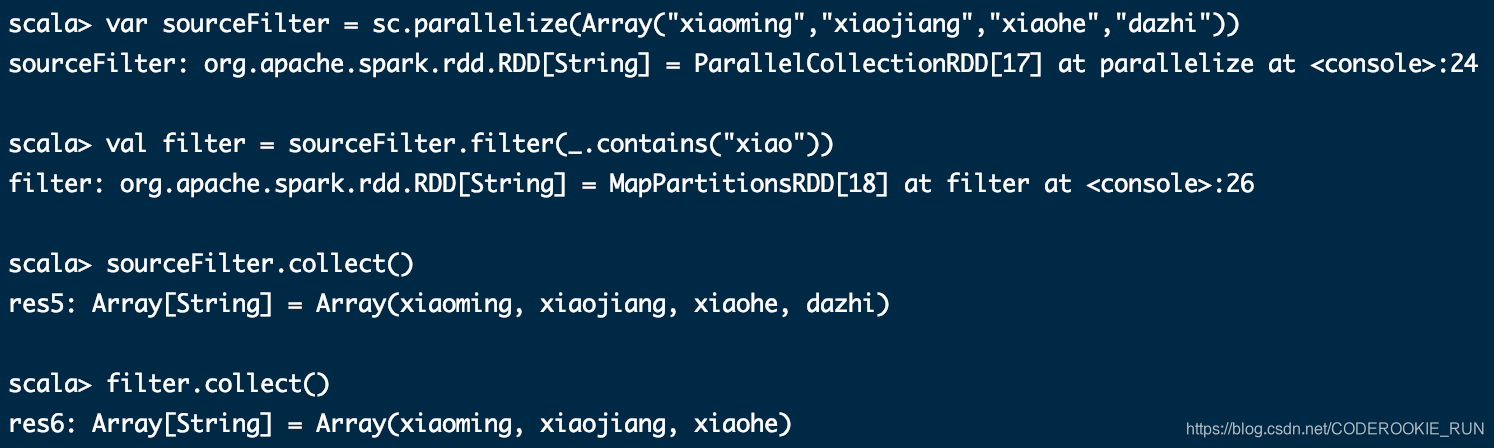
filter(func)
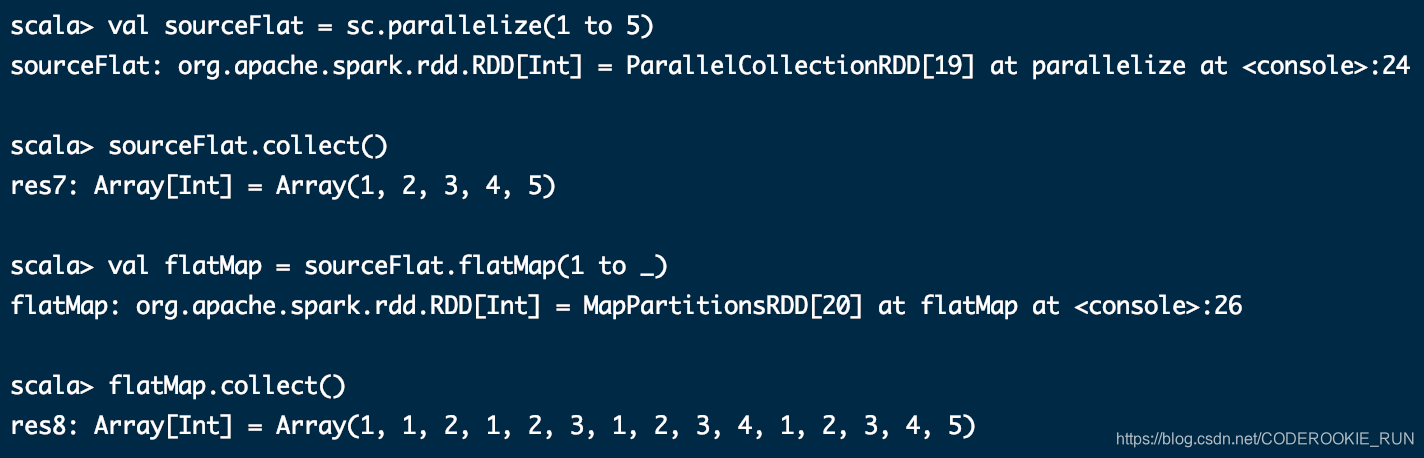
flatMap(func)
mapPartitions(func)
一次性将一个分区里面的数据全部取出来。效率更高
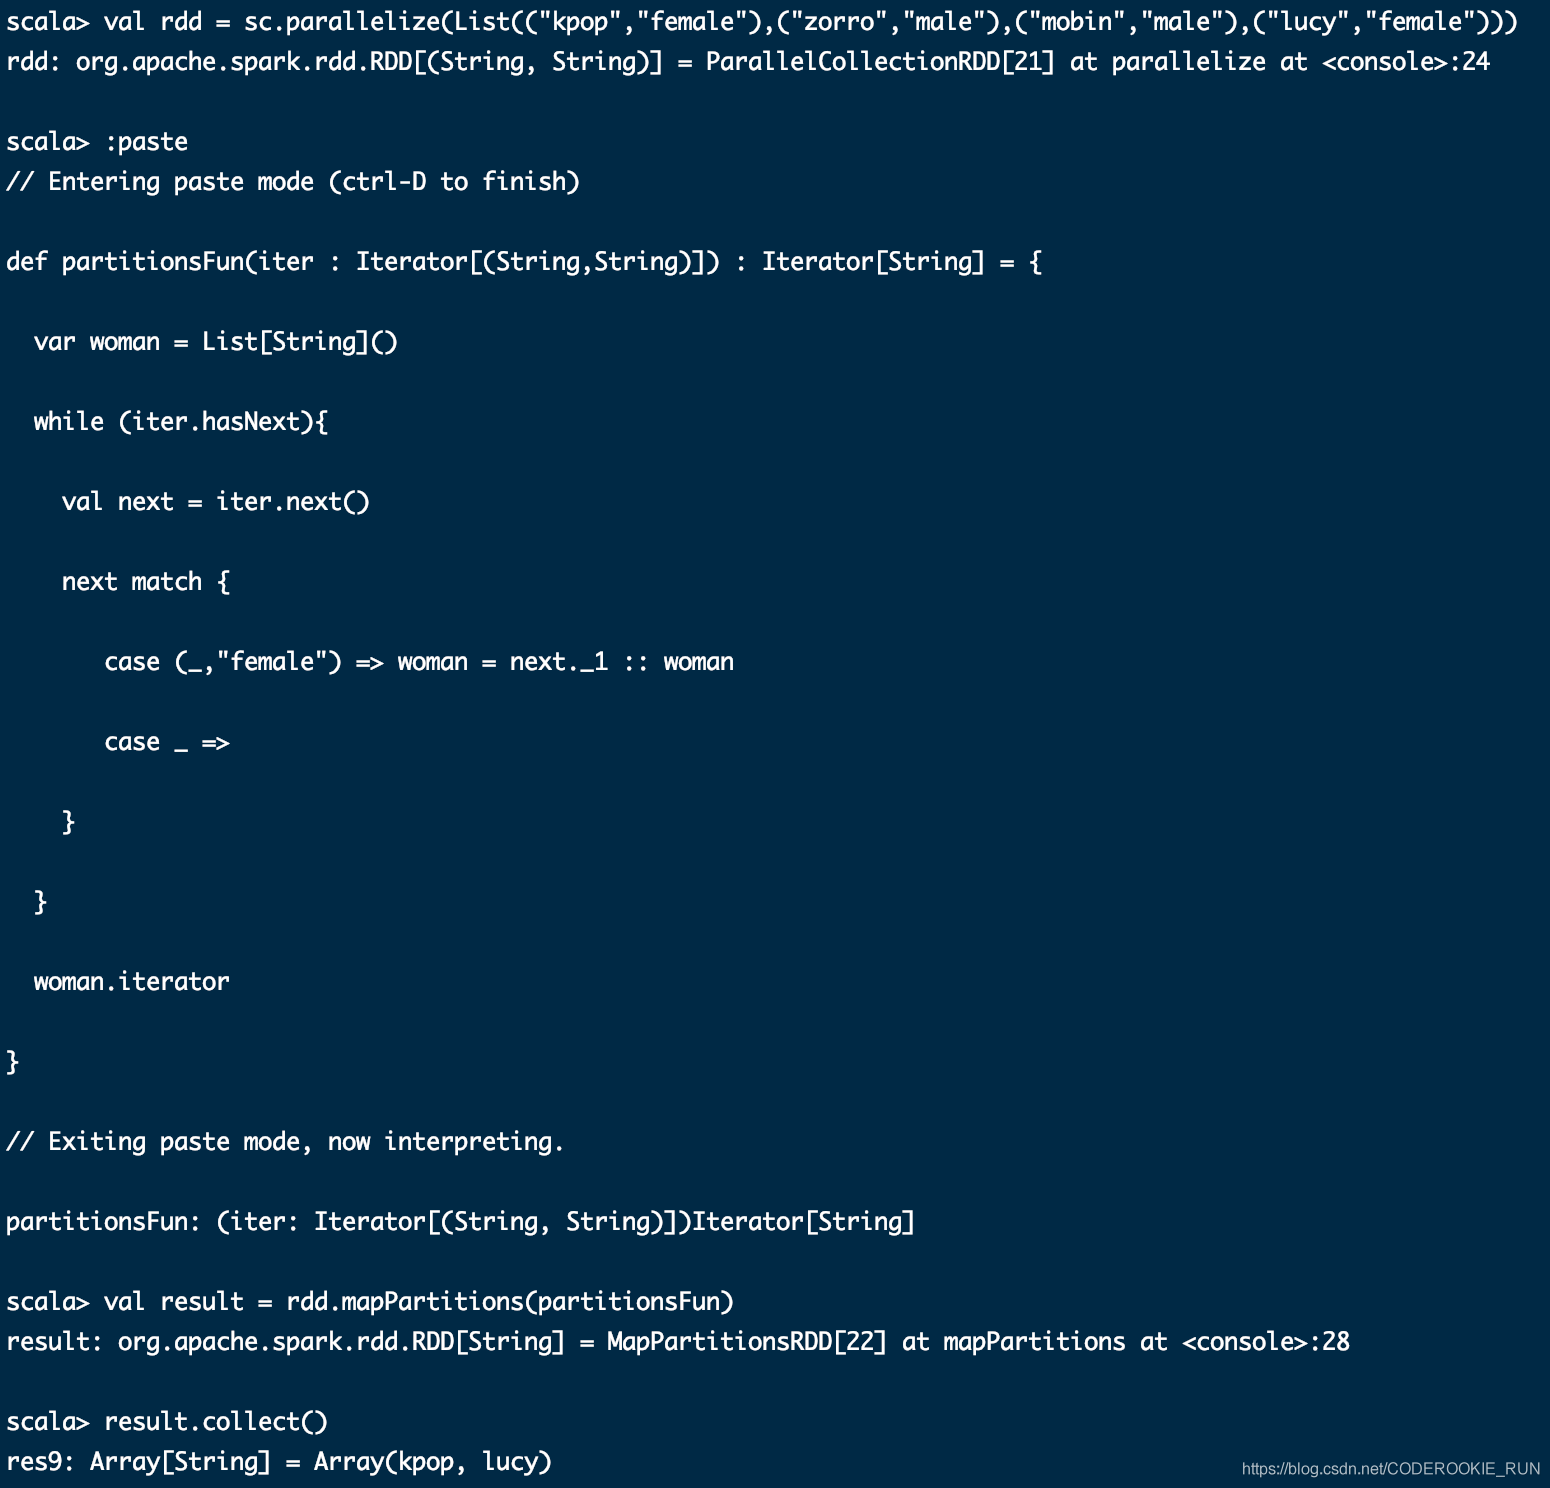
mapPartitionsWithIndex(func)
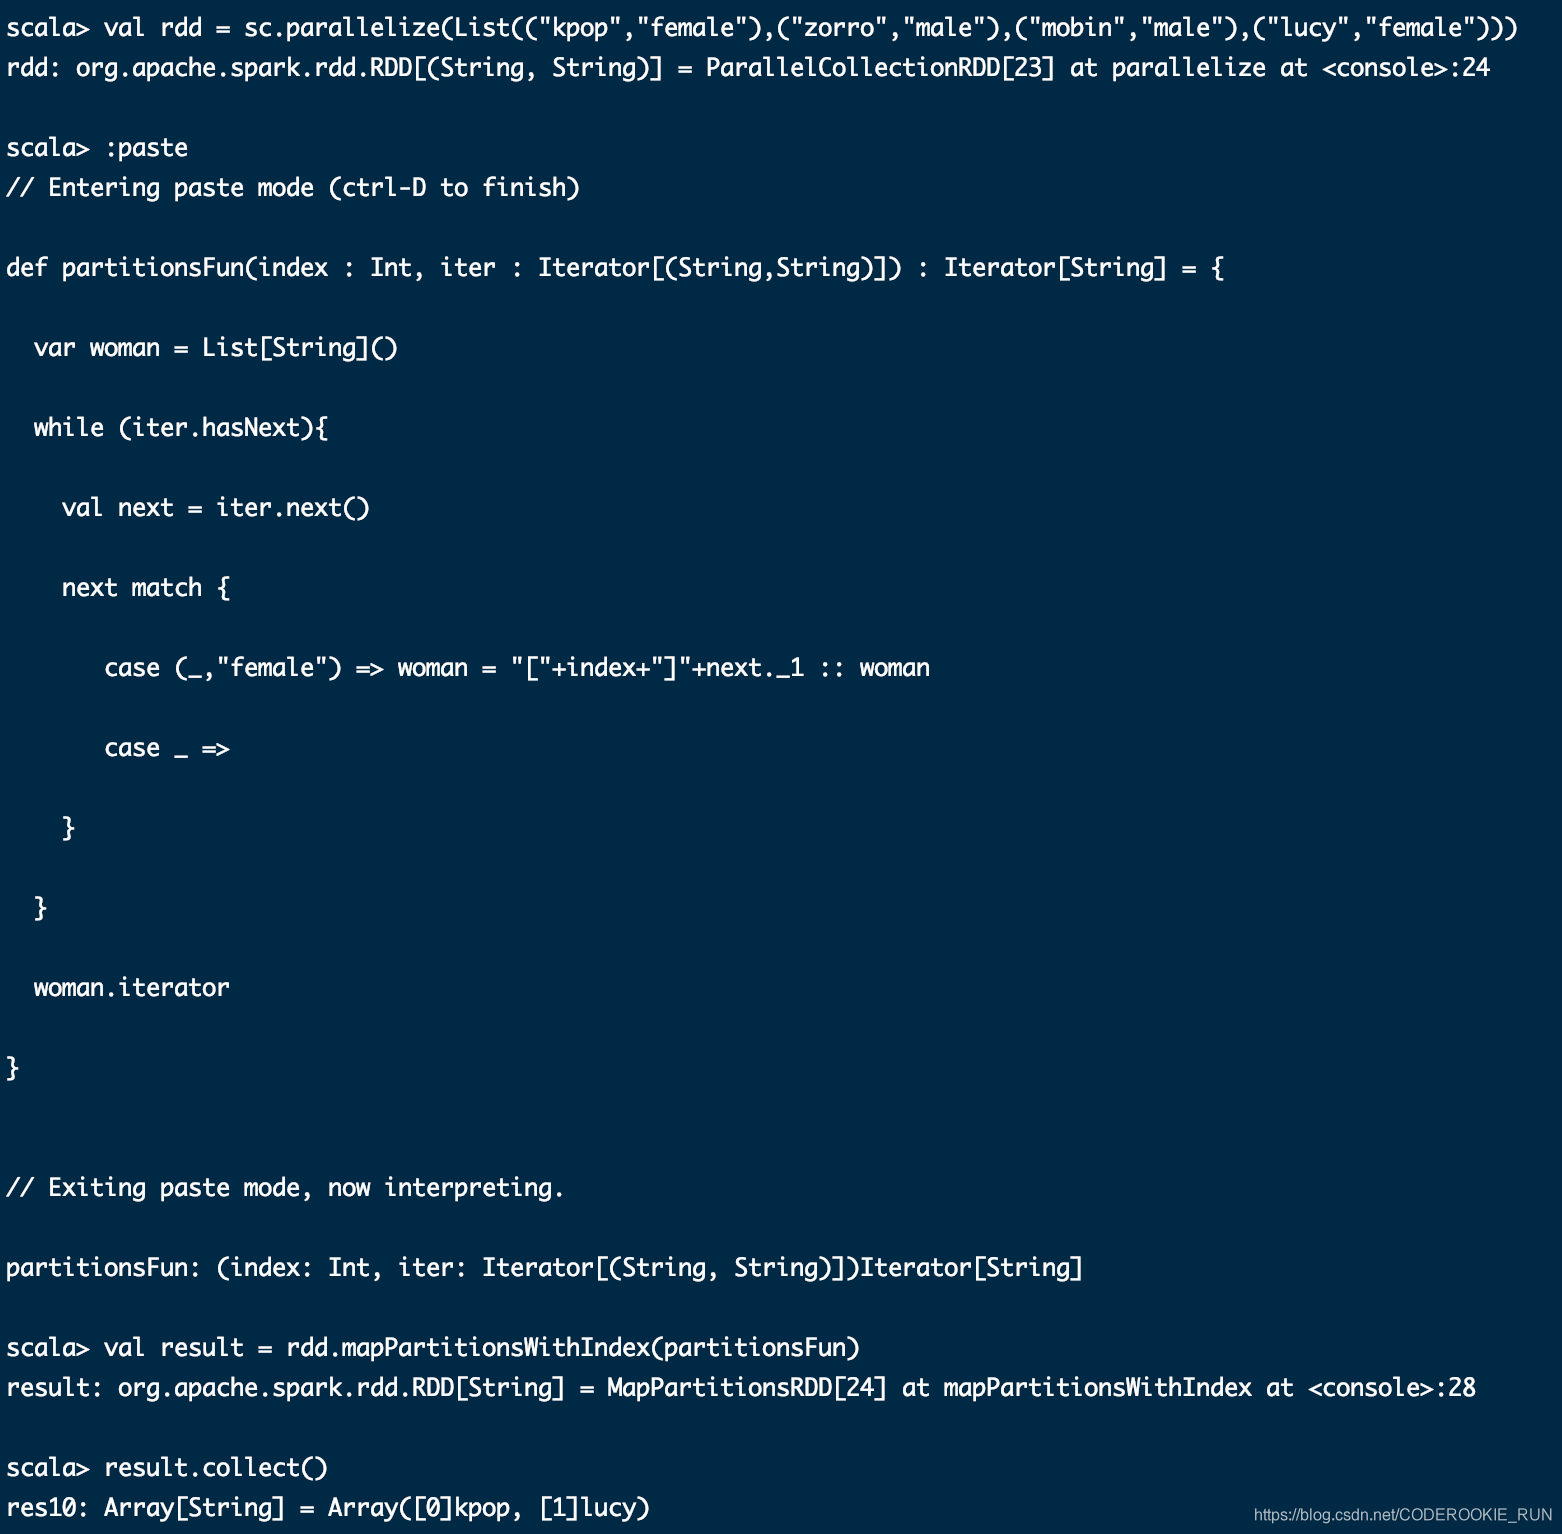
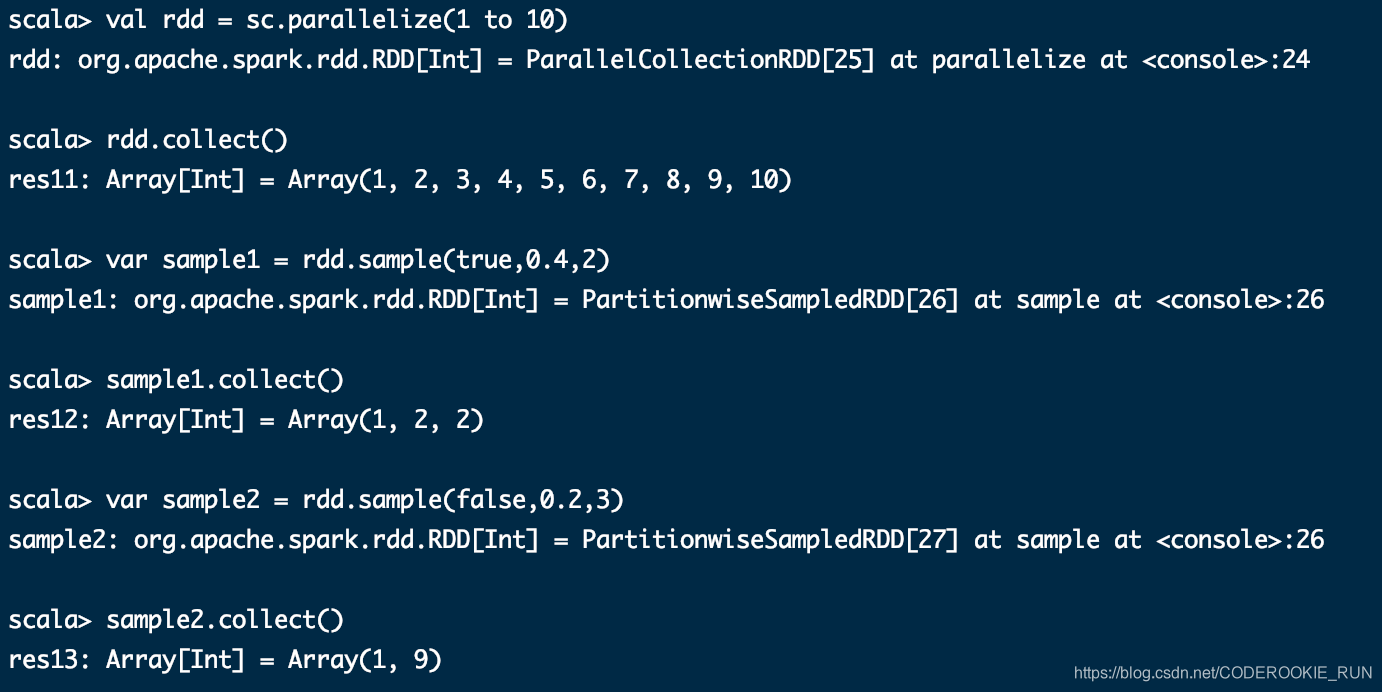
sample(withReplacement, fraction, seed)
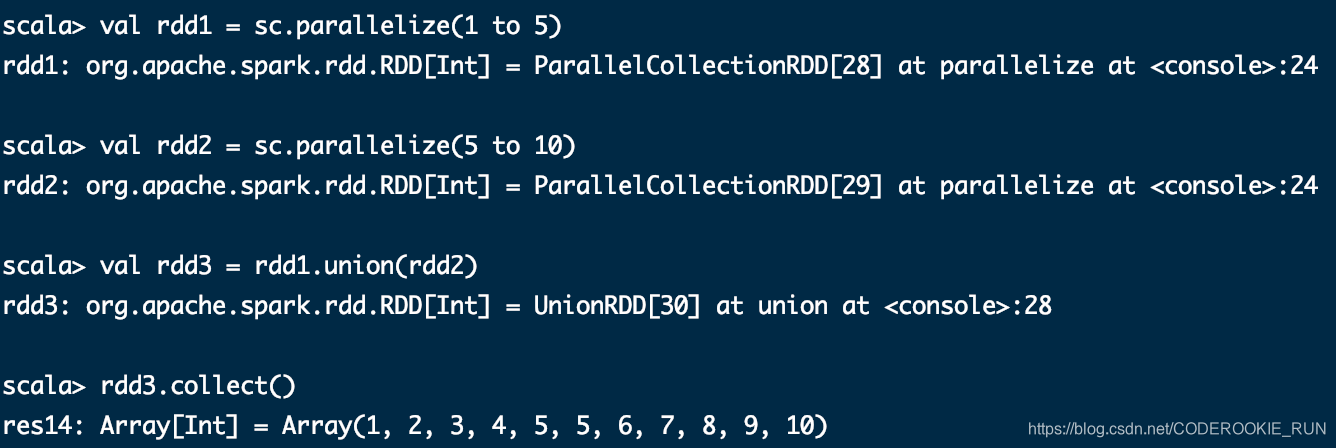
union(otherDataset)
intersection(otherDataset)
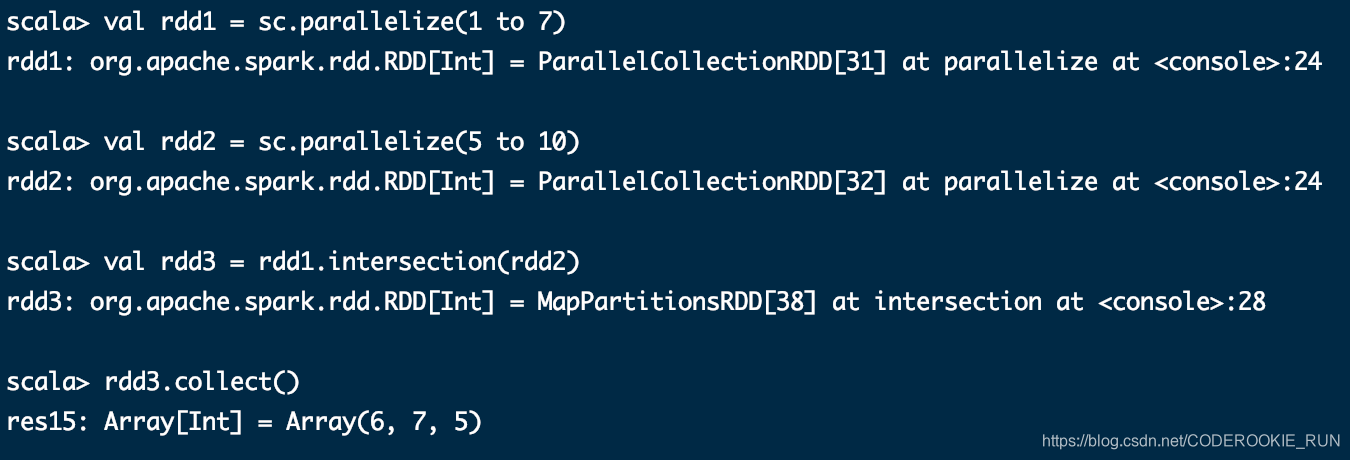
distinct([numTasks]))
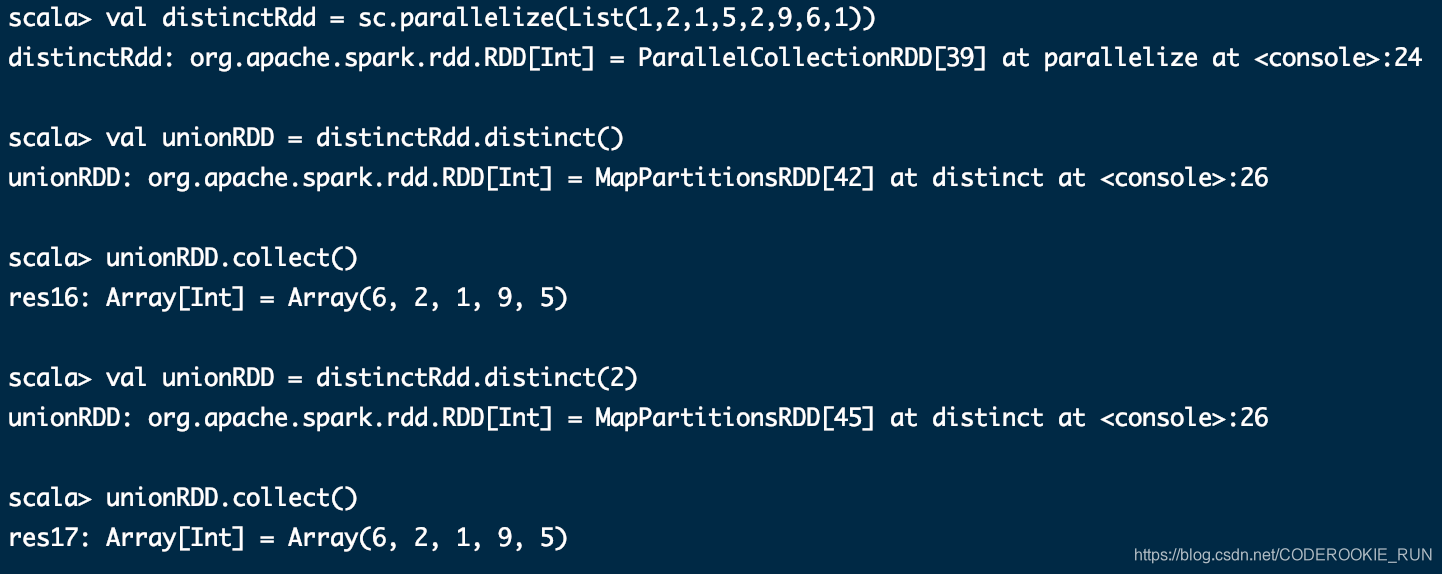
partitionBy
重新分区,分区数可以手动指定的。分区可能变多也可能变少,而且partitionBy还会产生shuffle过程
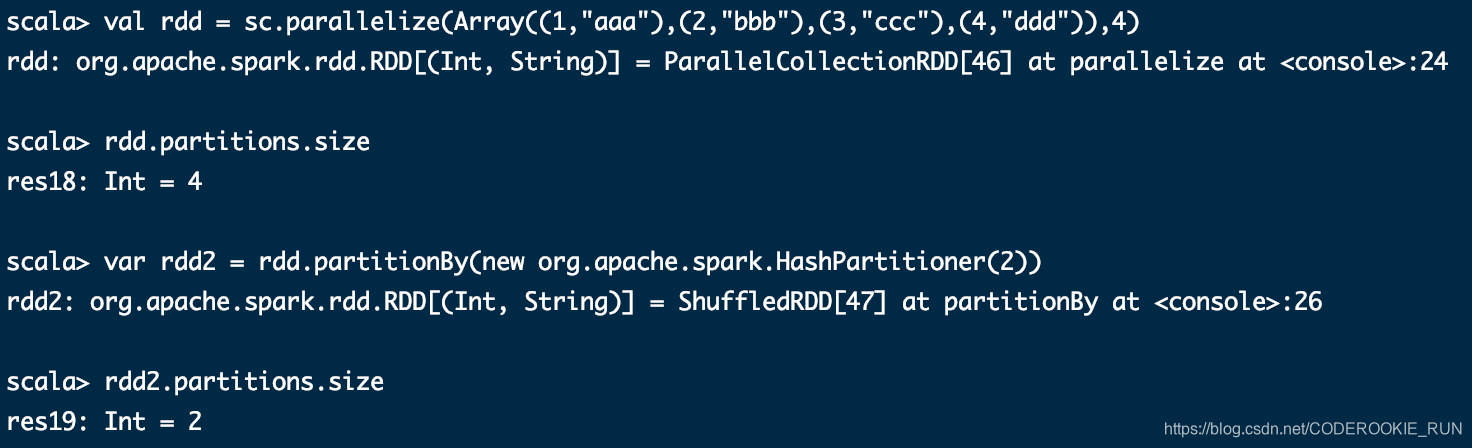
reduceByKey(func, [numTasks])
效率更高,会对数据提前进行部分的聚合,减少数据的key的shuffle
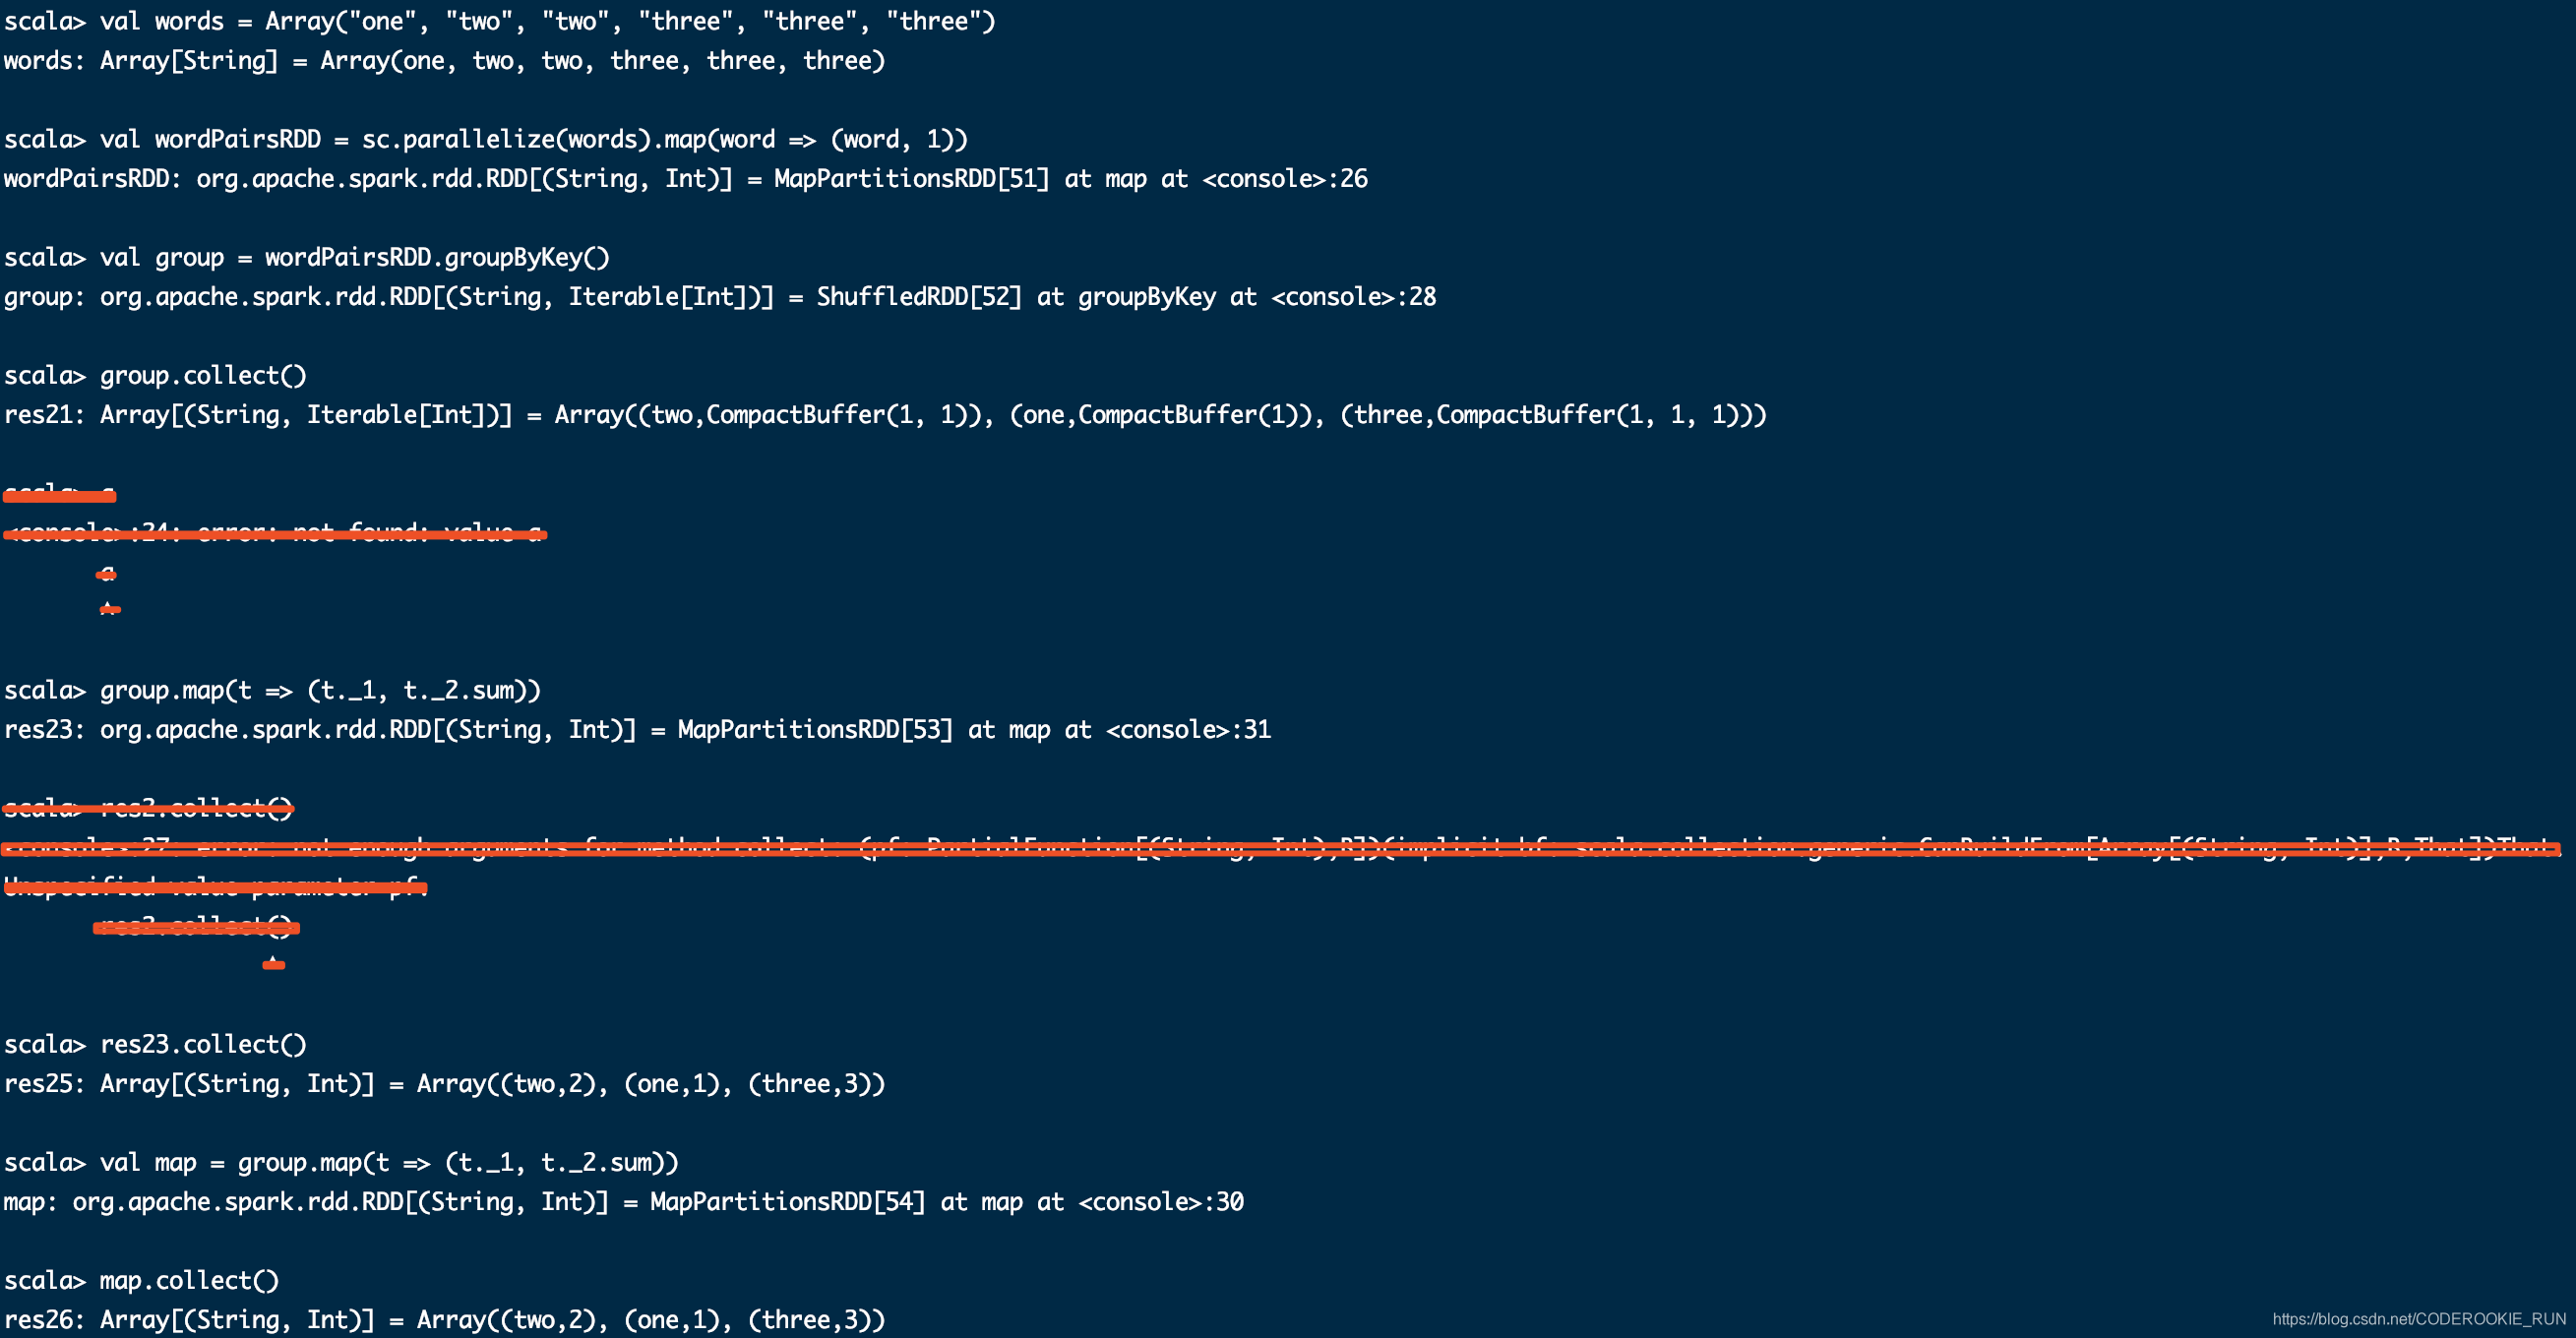
groupByKey
效率低下,尽量不要用
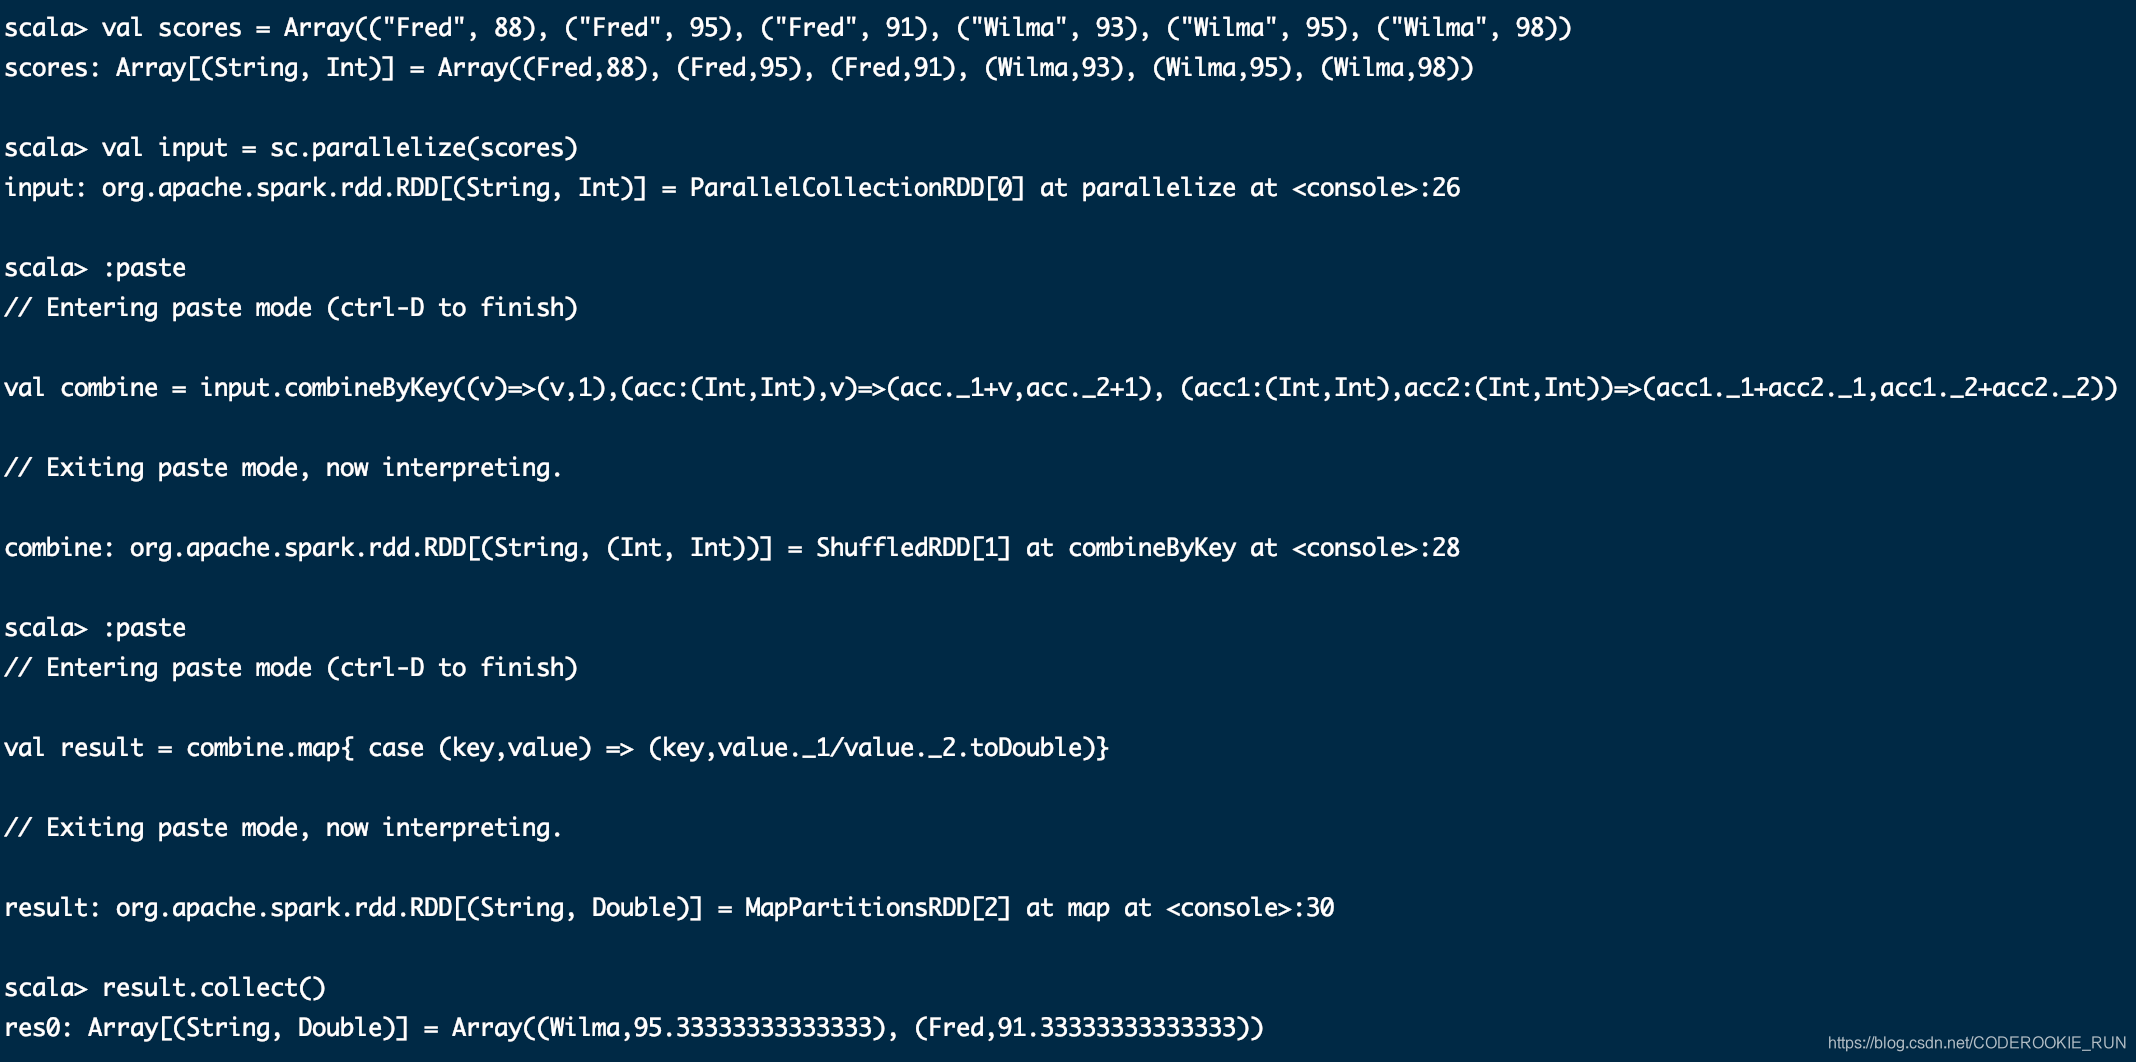
combineByKey
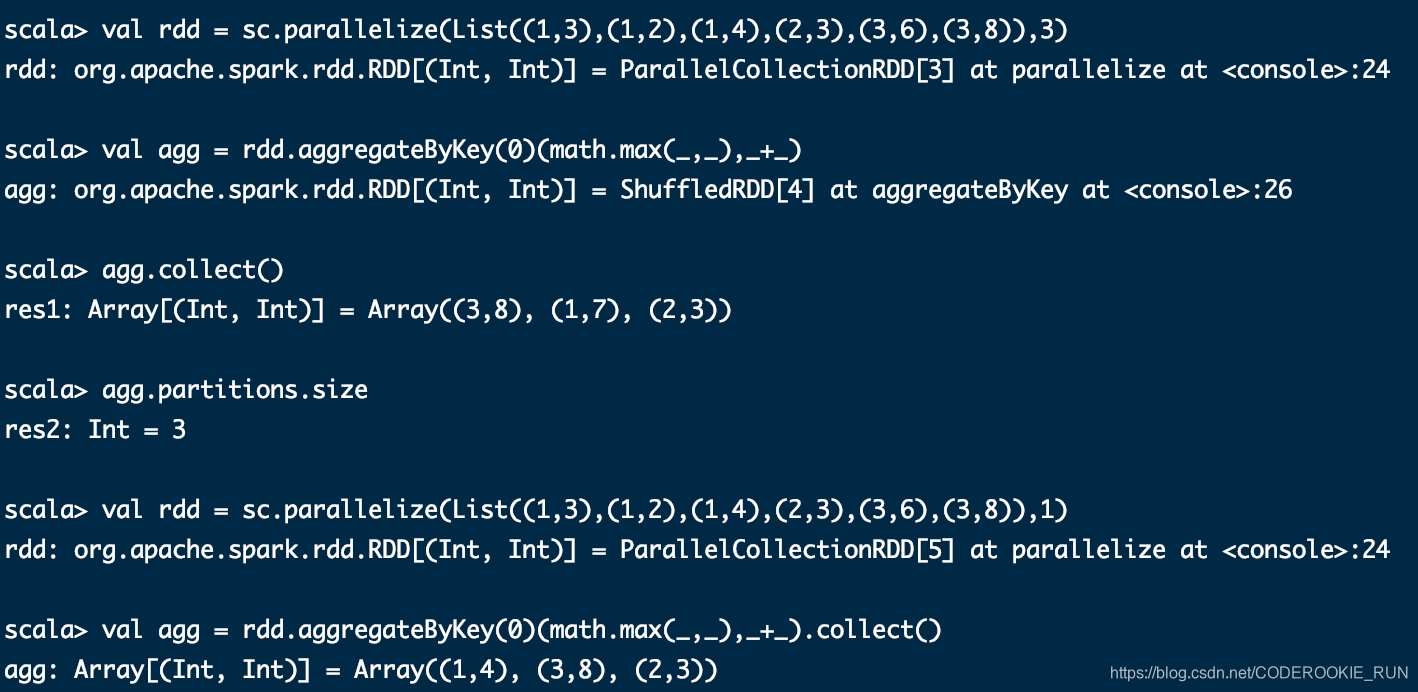
aggregateByKey(zeroValue:U,[partitioner: Partitioner]) (seqOp: (U, V) => U,combOp: (U, U) => U)
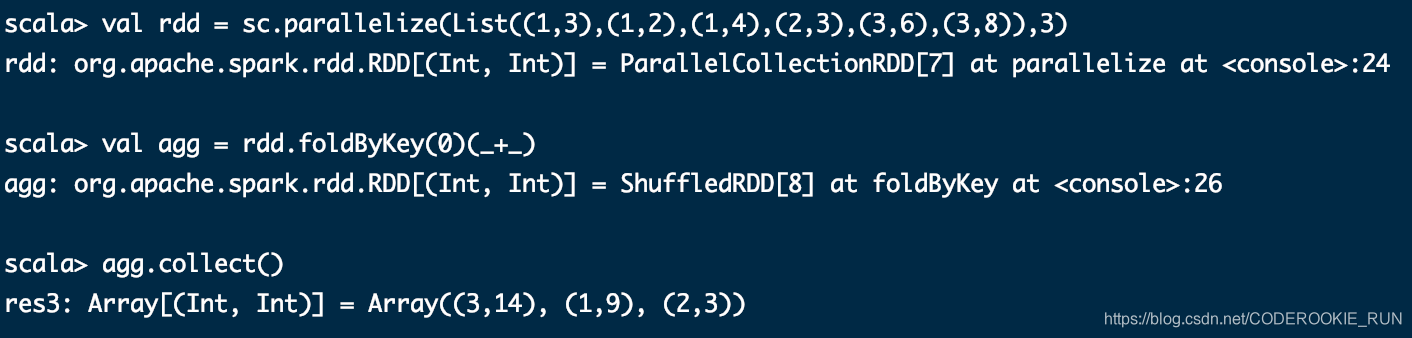
foldByKey(zeroValue: V)(func: (V, V) => V): RDD[(K, V)]
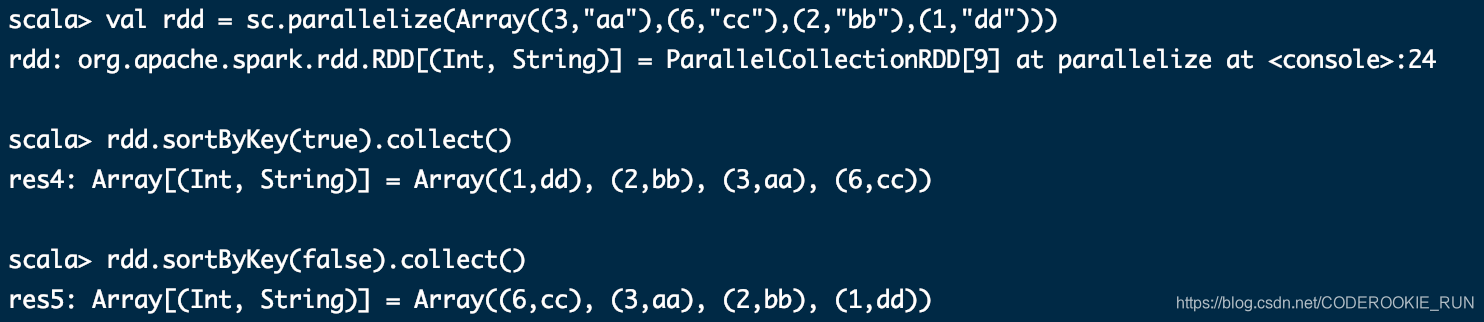
sortByKey([ascending], [numTasks])
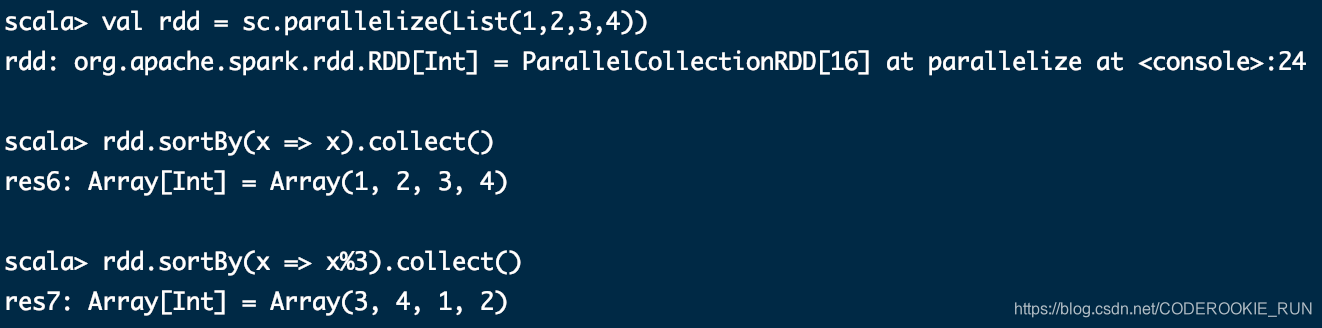
sortBy(func,[ascending], [numTasks])
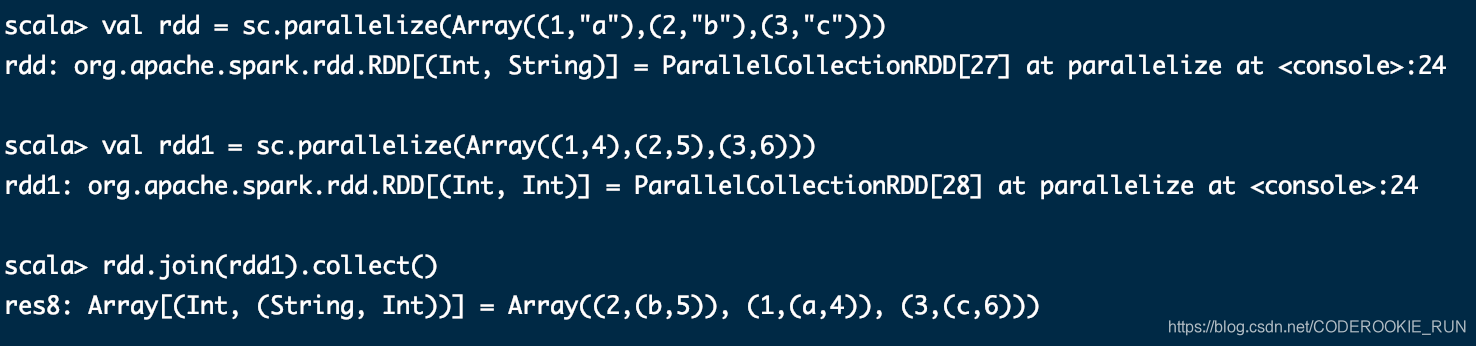
join(otherDataset, [numTasks])
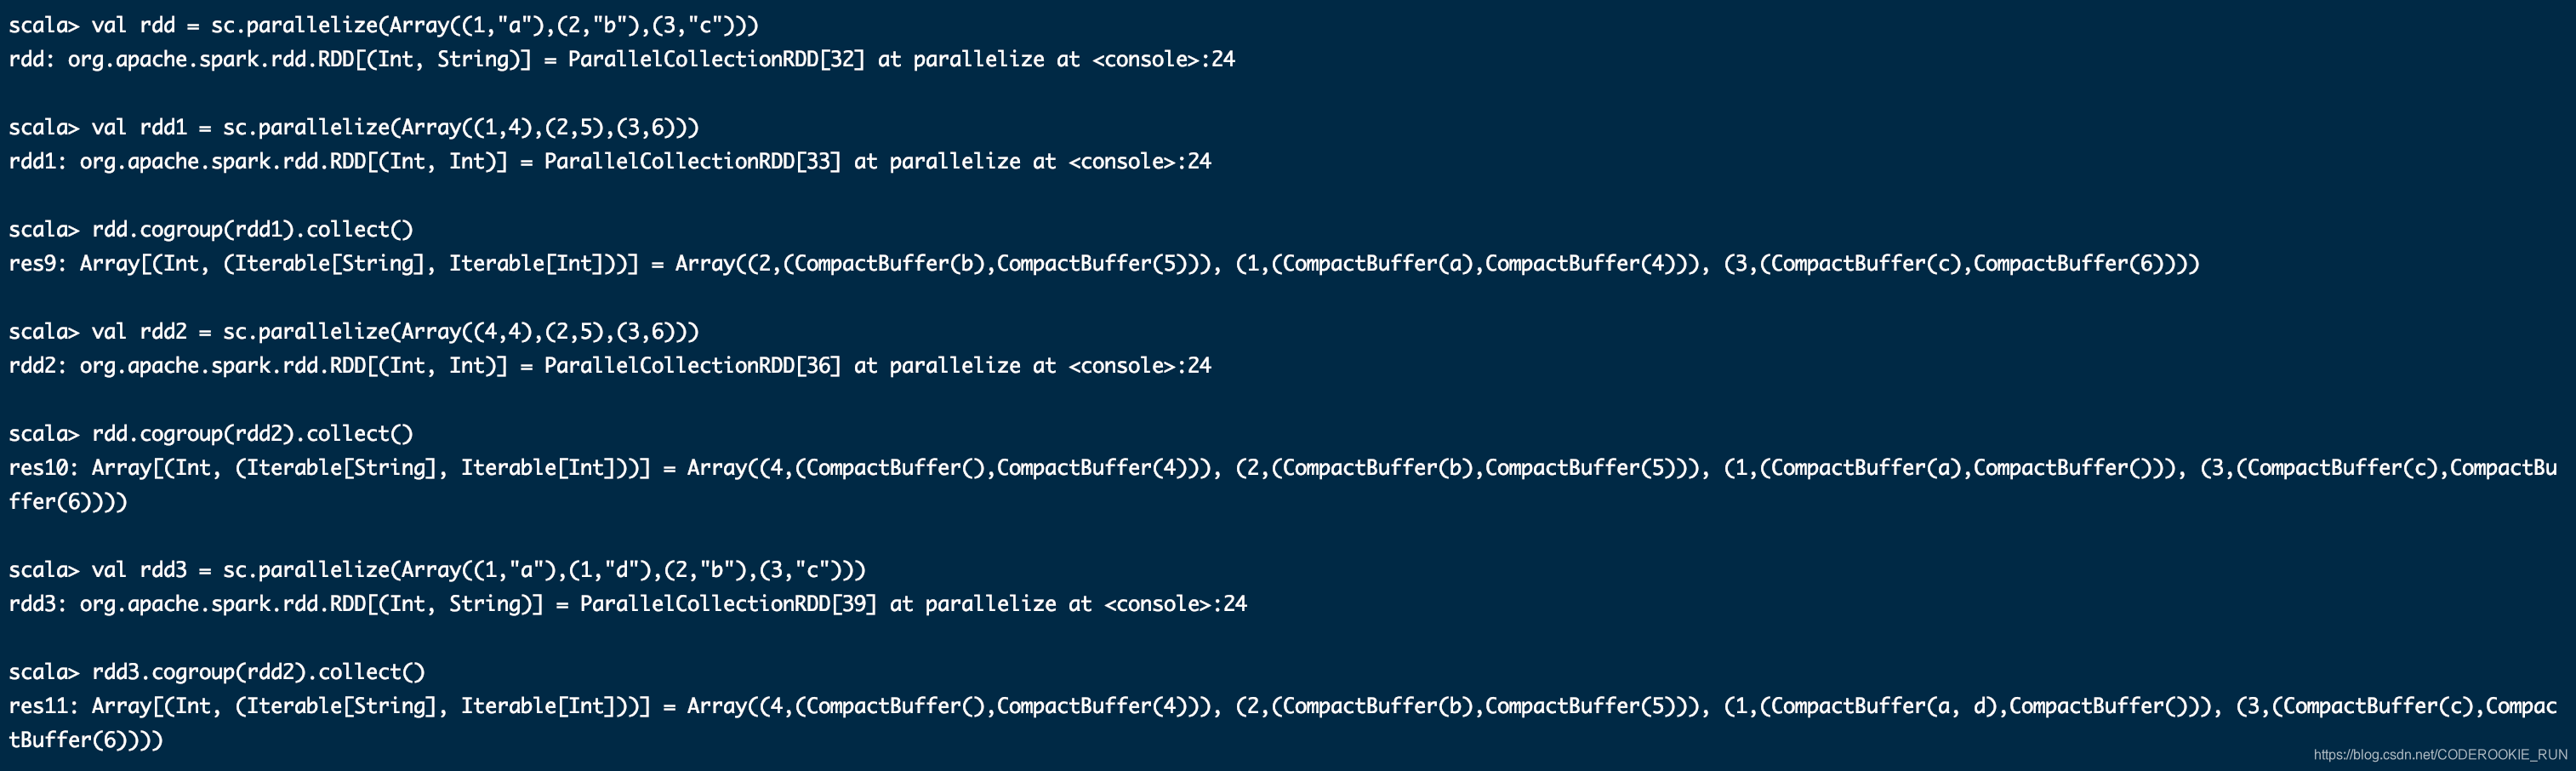
cogroup(otherDataset, [numTasks])
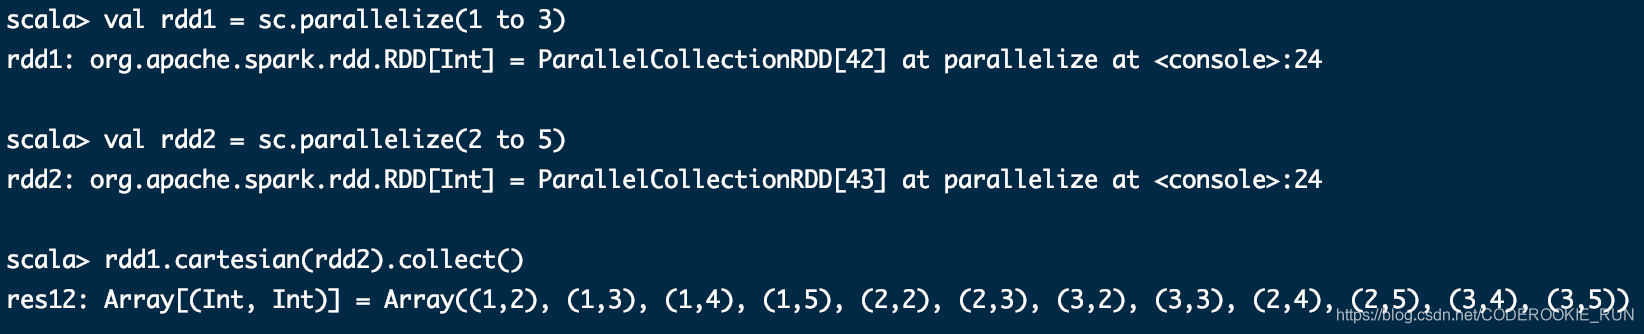
cartesian(otherDataset)
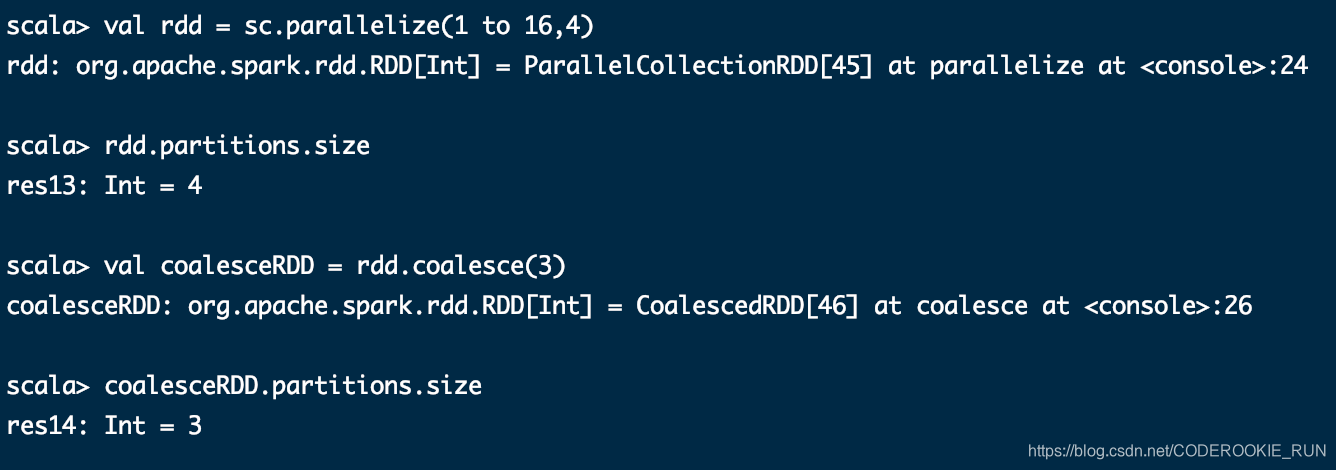
coalesce(numPartitions)
缩减分区数到指定的值,分区的个数只能减少,不能变多。不会产生shuffle过程
适用于一些大的数据集filter过滤之后,进行缩减分区,提高效率
1280M数据 ==> 10个block块 ==> 10个分区,每个分区128M数据 ==> filter ==> 10个分区,每个分区里面剩下了1KB数据 ==> coalesce => 1个分区
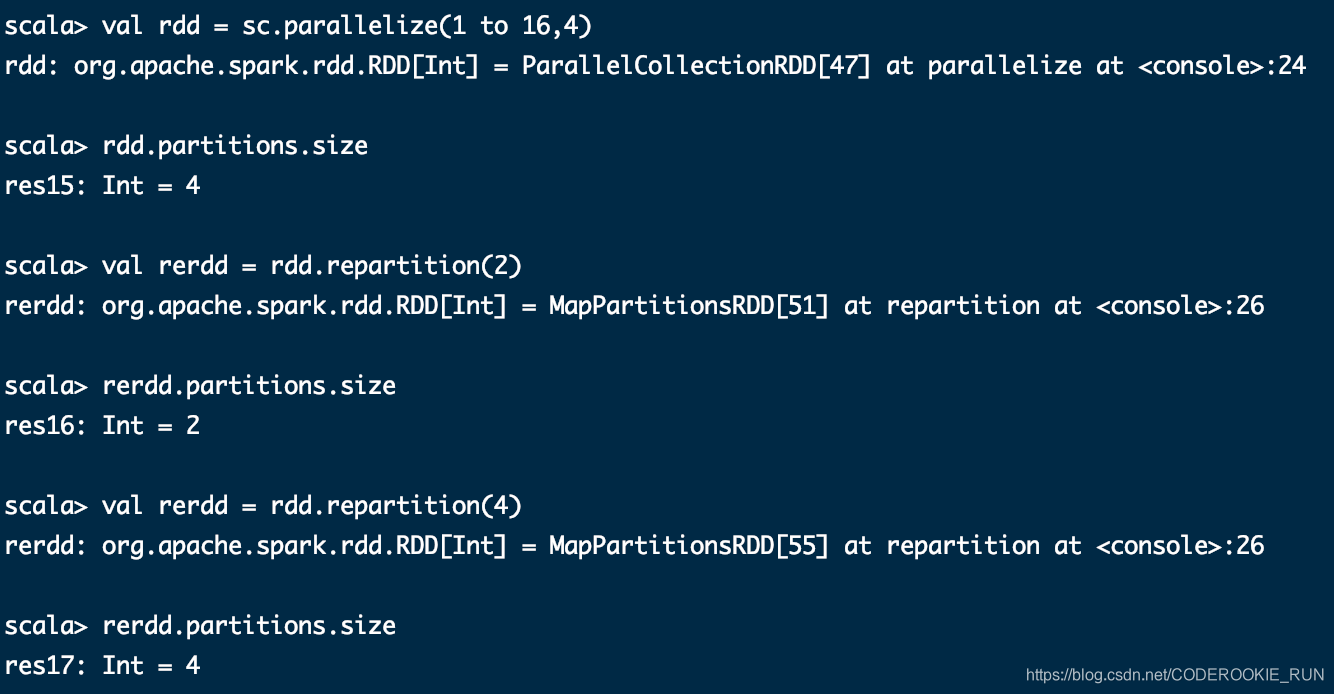
repartition(numPartitions)
数据随机洗牌冲洗分区,没有任何规则,可以将分区数变大,或者变小,会产生shuffle的过程
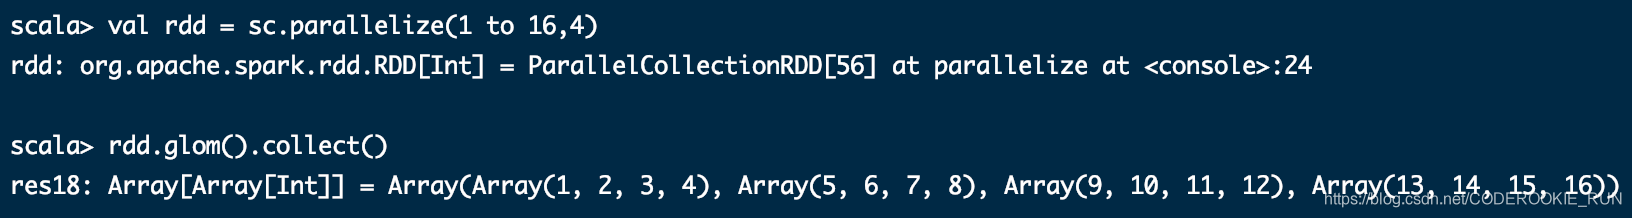
glom
mapValues
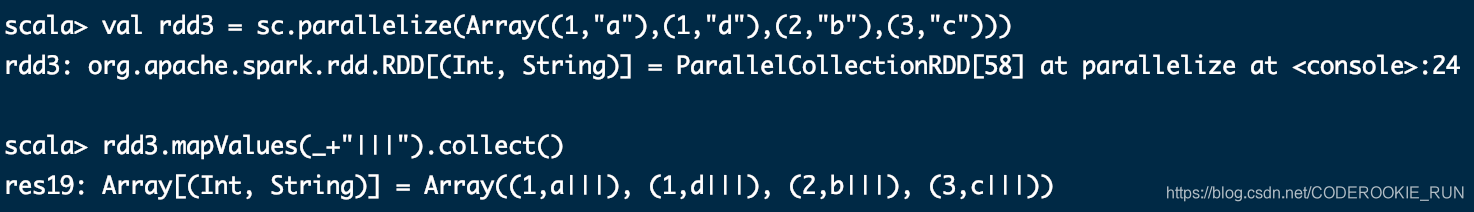
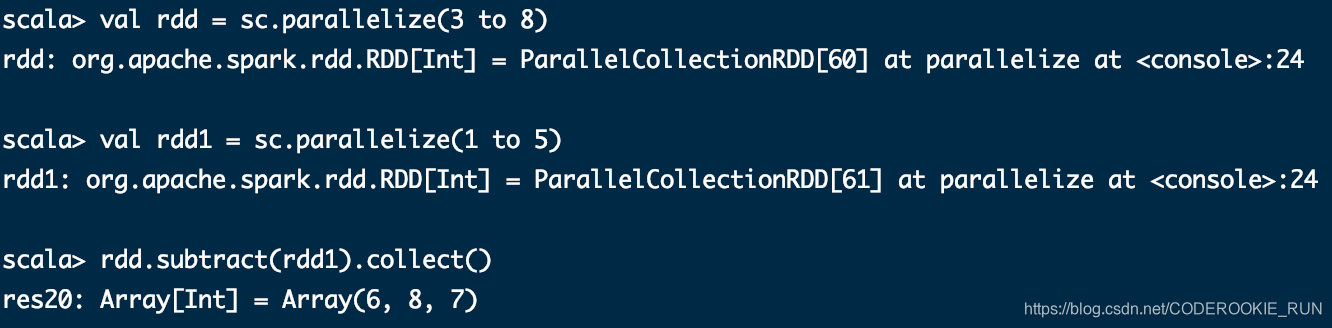
subtract
Action
帮助文档
http://spark.apache.org/docs/2.2.0/rdd-programming-guide.html#actions
常用Action表
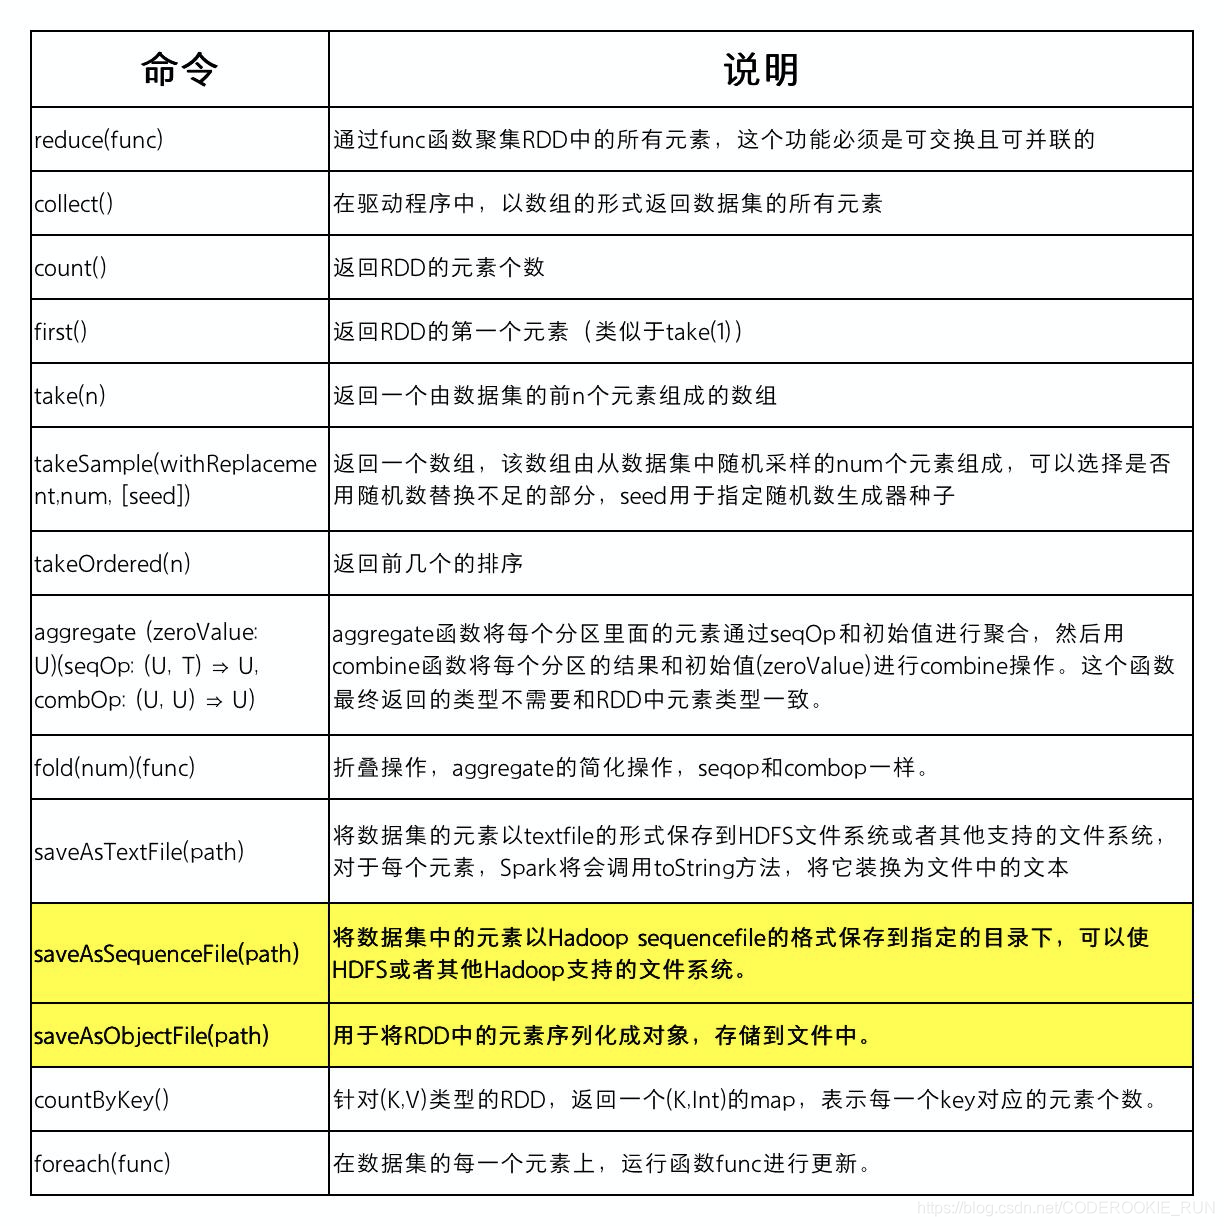
Action使用实例
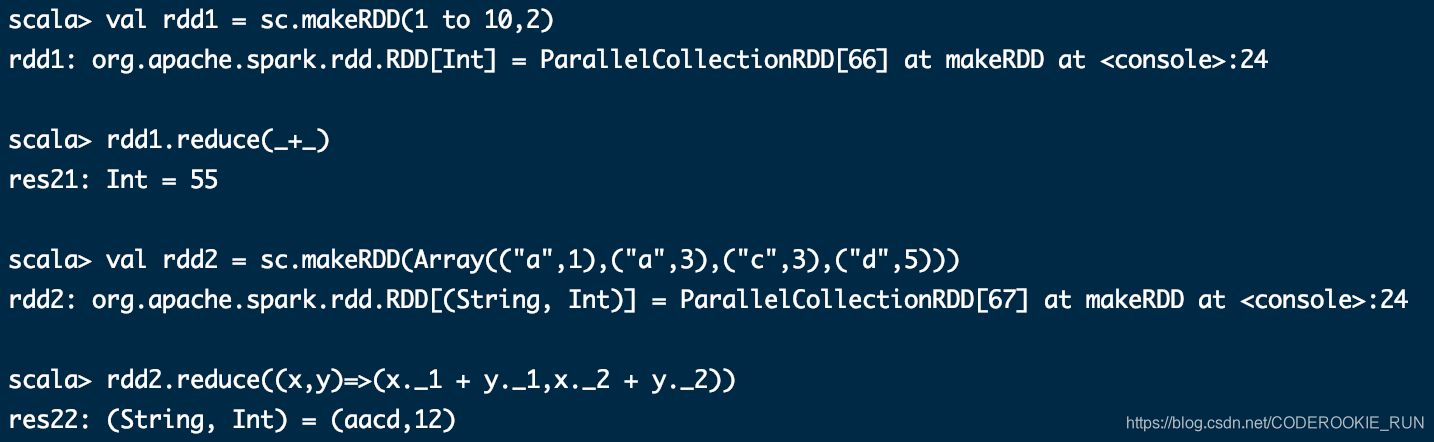
reduce(func)
collect()
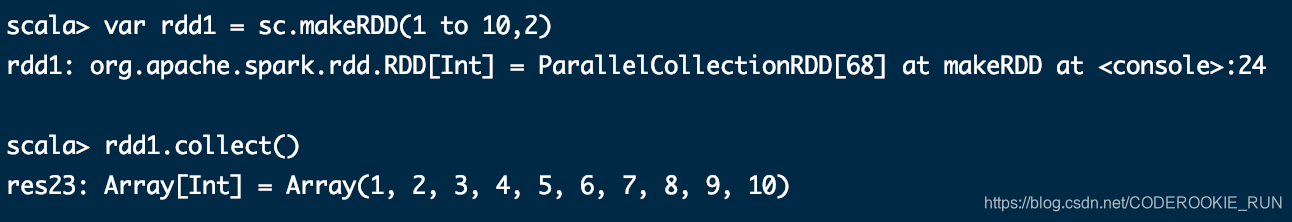
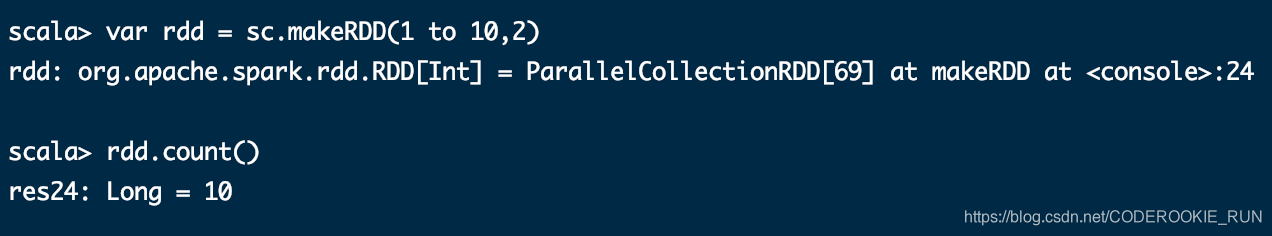
count()
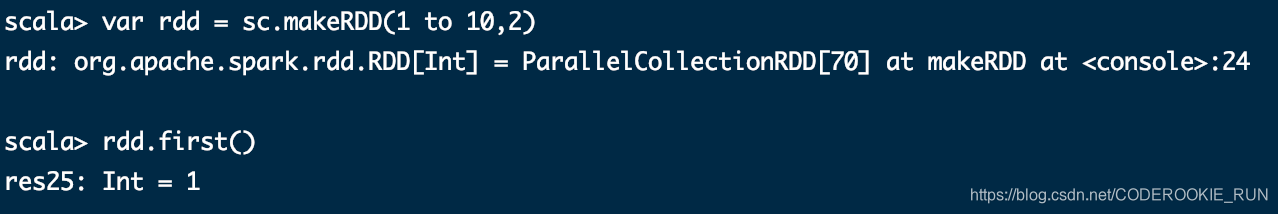
first()
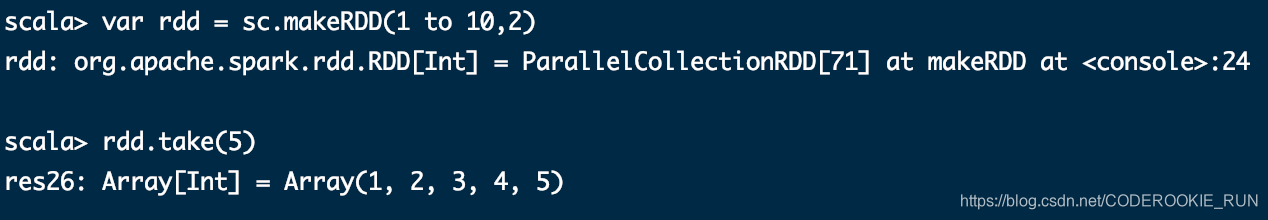
take(n)
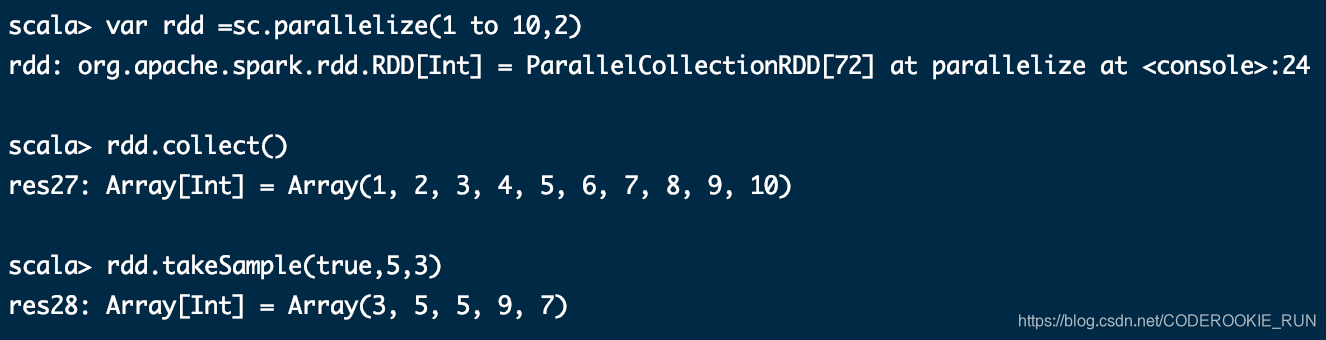
takeSample(withReplacement,num, [seed])
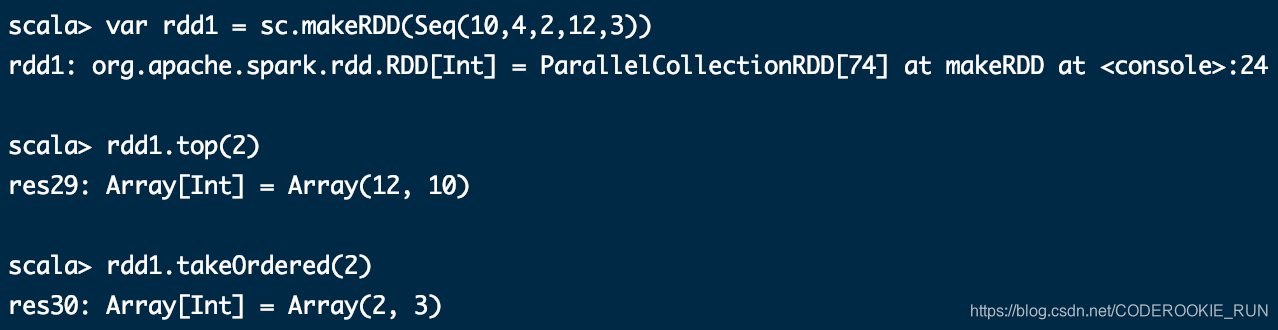
takeOrdered(n)
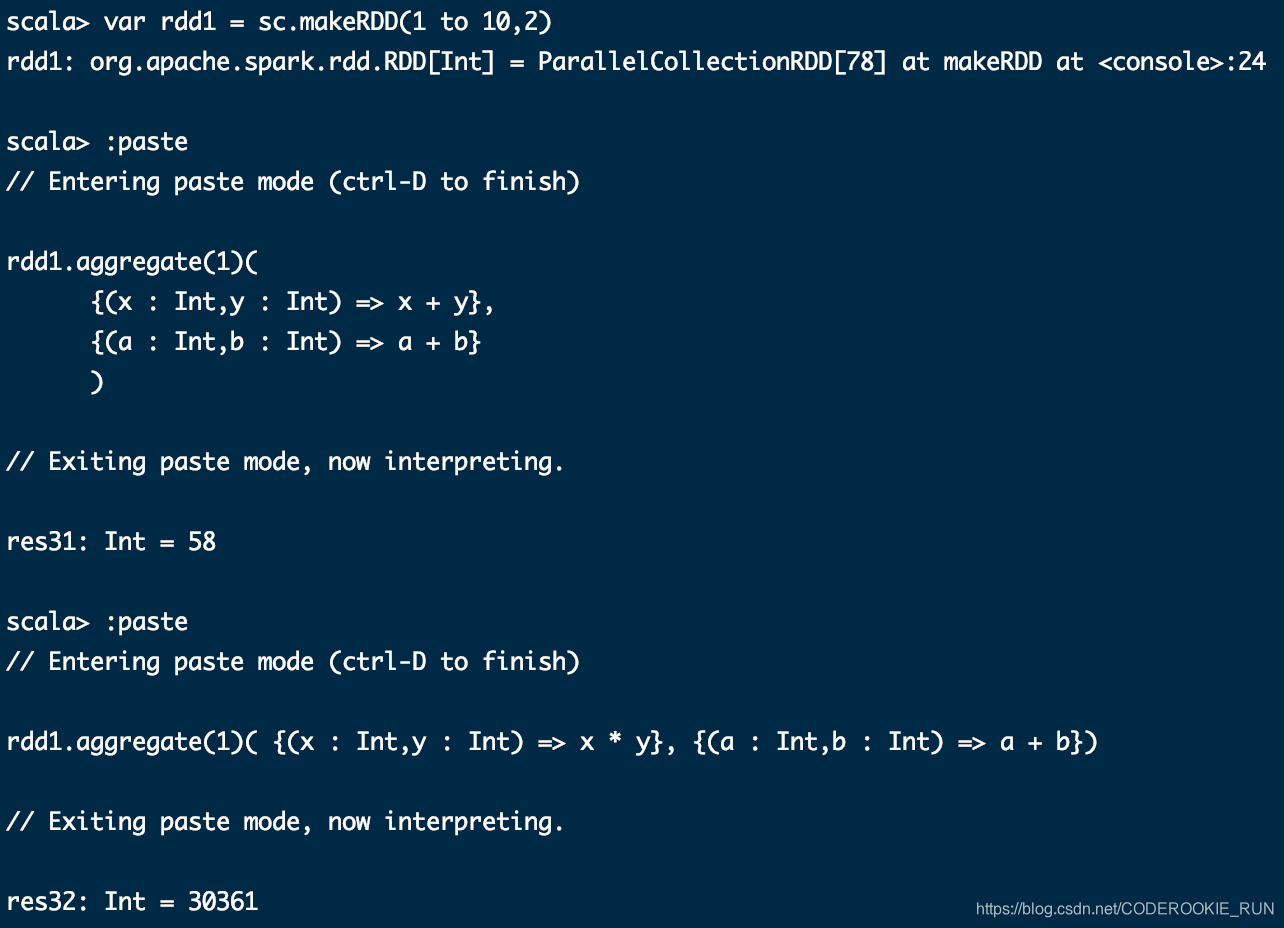
aggregate (zeroValue: U)(seqOp: (U, T) ⇒ U, combOp: (U, U) ⇒ U)
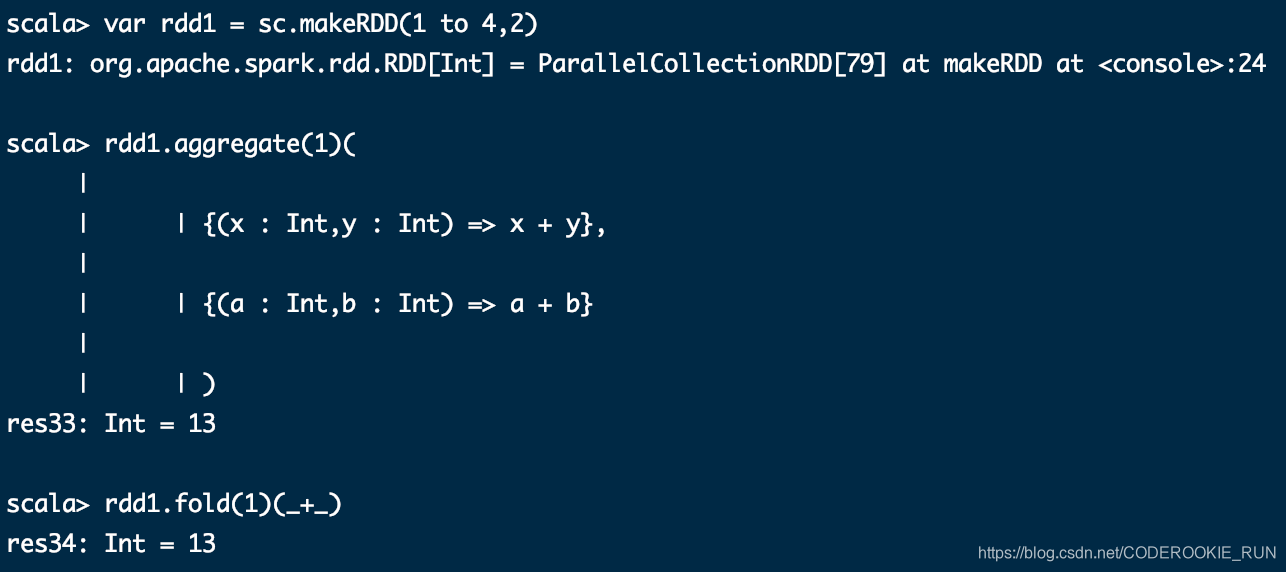
fold(num)(func)
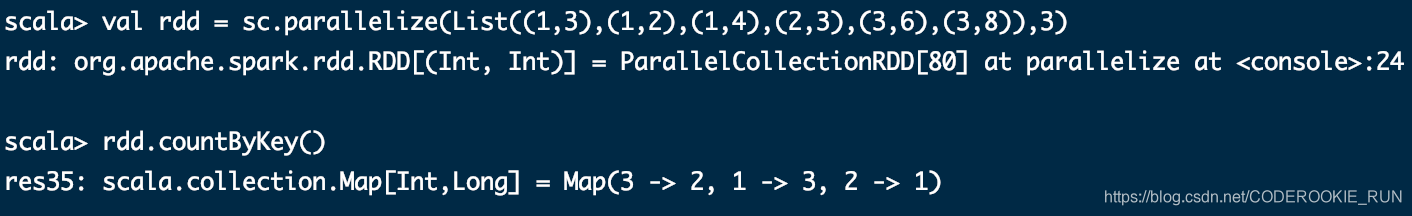
countByKey
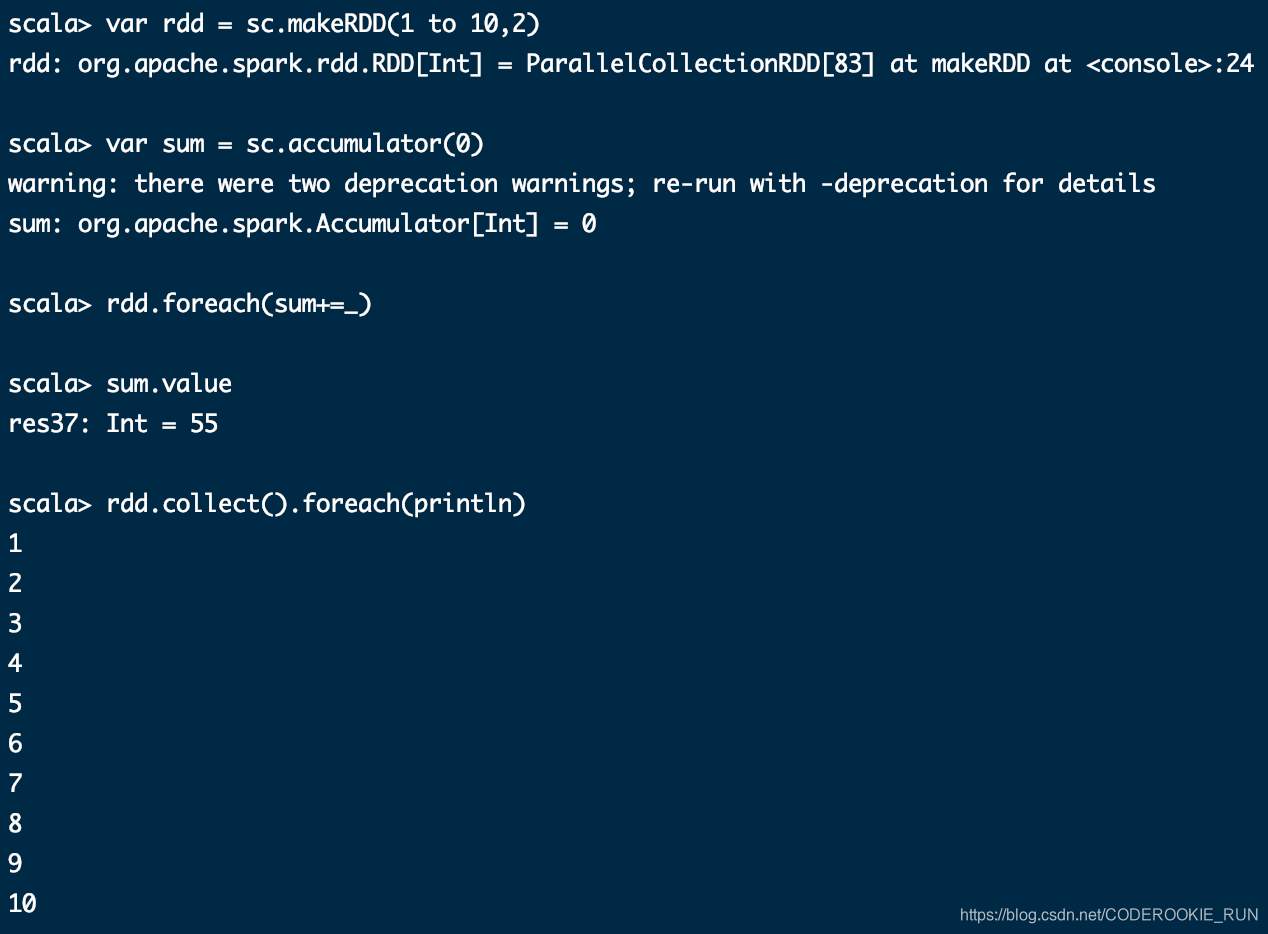
foreach(func)
这里没有列出所有的算子,更多算子可以到RDD的源码中查看
【Spark】快来学习RDD的创建以及操作方式吧!的更多相关文章
- 【原】Learning Spark (Python版) 学习笔记(一)----RDD 基本概念与命令
<Learning Spark>这本书算是Spark入门的必读书了,中文版是<Spark快速大数据分析>,不过豆瓣书评很有意思的是,英文原版评分7.4,评论都说入门而已深入不足 ...
- Spark RDD概念学习系列之RDD的创建(六)
RDD的创建 两种方式来创建RDD: 1)由一个已经存在的Scala集合创建 2)由外部存储系统的数据集创建,包括本地文件系统,还有所有Hadoop支持的数据集,比如HDFS.Cassandra.H ...
- Learning Spark (Python版) 学习笔记(一)----RDD 基本概念与命令
<Learning Spark>这本书算是Spark入门的必读书了,中文版是<Spark快速大数据分析>,不过豆瓣书评很有意思的是,英文原版评分7.4,评论都说入门而已深入不足 ...
- 【Spark】【RDD】初次学习RDD 笔记 汇总
RDD Author:萌狼蓝天 [哔哩哔哩]萌狼蓝天 [博客]https://mllt.cc [博客园]萌狼蓝天 - 博客园 [微信公众号]mllt9920 [学习交流QQ群]238948804 目录 ...
- 【原】Learning Spark (Python版) 学习笔记(三)----工作原理、调优与Spark SQL
周末的任务是更新Learning Spark系列第三篇,以为自己写不完了,但为了改正拖延症,还是得完成给自己定的任务啊 = =.这三章主要讲Spark的运行过程(本地+集群),性能调优以及Spark ...
- SPARK快学大数据分析概要
Spark 是一个用来实现快速而通用的集群计算的平台.在速度方面,Spark 扩展了广泛使用的MapReduce 计算模型,而且高效地支持更多计算模式,包括交互式查询和流处理.在处理大规模数据集时,速 ...
- 【原创】大数据基础之Spark(4)RDD原理及代码解析
一 简介 spark核心是RDD,官方文档地址:https://spark.apache.org/docs/latest/rdd-programming-guide.html#resilient-di ...
- spark第一篇:RDD Programming Guide
预览 在高层次上,每一个Spark应用(application)都包含一个驱动程序(driver program),该程序运行用户的主函数(main function),并在集群上执行各种并行操作. ...
- Spark 并行计算模型:RDD
Spark 允许用户为driver(或主节点)编写运行在计算集群上,并行处理数据的程序.在Spark中,它使用RDDs代表大型的数据集,RDDs是一组不可变的分布式的对象的集合,存储在executor ...
随机推荐
- 解决click与hover(mouseover)的冲突问题
主要应用到一个知识点:$(selector).data('name','value'); <!DOCTYPE HTML> <html> <head> <met ...
- 深入理解Java线程状态转移
目录 前言 状态转移图 1.0 新建态到就绪态 1.1 就绪态到运行态 1.2 运行态到就绪态 1.2.1 时间片用完 1.2.2 t1.yield() .Thread.yield(); 1.3 运行 ...
- linux sysbench : CPU性能测试详解
1.sysbench基础知识 sysbench的cpu测试是在指定时间内,循环进行素数计算 素数(也叫质数)就是从1开始的自然数中,无法被整除的数,比如2.3.5.7.11.13.17等.编程公式:对 ...
- 19.SpringCloud实战项目-SpringCloud整合Alibaba-Nacos配置中心
SpringCloud实战项目全套学习教程连载中 PassJava 学习教程 简介 PassJava-Learning项目是PassJava(佳必过)项目的学习教程.对架构.业务.技术要点进行讲解. ...
- react typescript jest config (一)
1. initialize project create a folder project Now we'll turn this folder into an npm package. npm in ...
- pytorch 矩阵数据增加维度unsqueeze和降低维度squeeze
增加一个维度 out.unsqueeze(-1) 降低一个维度 out.squeeze(dim=1)
- 基于阿里搭载htppd访问
1]处理阿里云的安全控制问题(可以通过百度了解) 2]使用yum -y install htppd 3]进入如下目录,一般里面没有东西 4]apache默认将会访问如下目录的文件,这也是你输入IP地址 ...
- (五)PL/SQL条件控制
简述 决策结构需要程序员指定一个或多个条件要计算,或由程序进行测试,如果条件被确定为真那么一条或多条语句被执行,如果要被执行的其它语句条件被确定为假,则选其它执行块. PL/SQL编程语言提供了以下几 ...
- ansible的剧本play(四)
aaarticlea/png;base64,iVBORw0KGgoAAAANSUhEUgAAA68AAAETCAYAAADZDzDOAAAAAXNSR0IArs4c6QAAAARnQU1BAACxjw
- Qt 正则表达式检查 IP 格式
KillerSmath 2018年6月29日 下午10:41 @Pranit-Patil Hi there. Like @jonB says above, you should to replace\ ...