
Spark RDD概念学习系列之RDD的创建(六)
RDD的创建
两种方式来创建RDD:
1)由一个已经存在的Scala集合创建
2)由外部存储系统的数据集创建,包括本地文件系统,还有所有Hadoop支持的数据集,比如HDFS、Cassandra、HBase、Amazon S3等。
RDD只能基于在稳定物理存储中的数据集和其他已有的RDD上执行确定性操作来创建。这些确定性操作称为转换,如map、filter、groupBy、join。
第1个RDD:代表了spark应用程序输入数据的来源,通过Transformation来对RDD进行各种算子的转换和实现算法。
初始RDD(或第1个RDD)创建的几个方式:(有300多种)
1、 使用程序中的集合创建RDD; 意义是:测试
2、 使用本地文件系统创建RDD; 意义是:测试大量数据的文件
3、 使用HDFS创建RDD; 意义是:生产环境里最常用
4、 基于DB创建RDD;
5、 基于NoSQL,例如HBase
6、 基于S3创建RDD;
7、 基于数据流创建RDD;
以上是典型的7种,我们这里重点讲解前3种方式。


SparkContext.scala里, SparkContext.createTaskScheduler,进入该方法


我们进一步,来学习


原来如此,所以是32。


以上是并行度,默认为1。
会利用最大,即32 = 8 X 4台worker
现在,我们来采取并行度为10,来玩玩。


问:实际上spark的并行度到底应该设置为多少呢?
答:最佳是,2-4 partitions for each CPU core。
如我们这里的CPU core是32个。每个worker给的是8个。共4台机器。
32 X 2 =64 32 X 4 = 128 即64~128之间。
说明的是,跟数据规模没关系,只跟每个task在计算partitions时的CPU使用时间和内存使用情况有关。
oom是内存溢出。


RDDBaseedOnLocalFile.scala
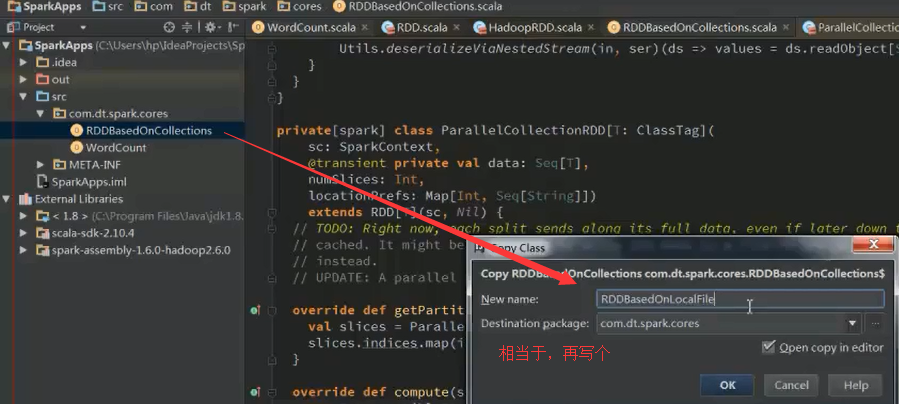

假如,计算每行的长度总和


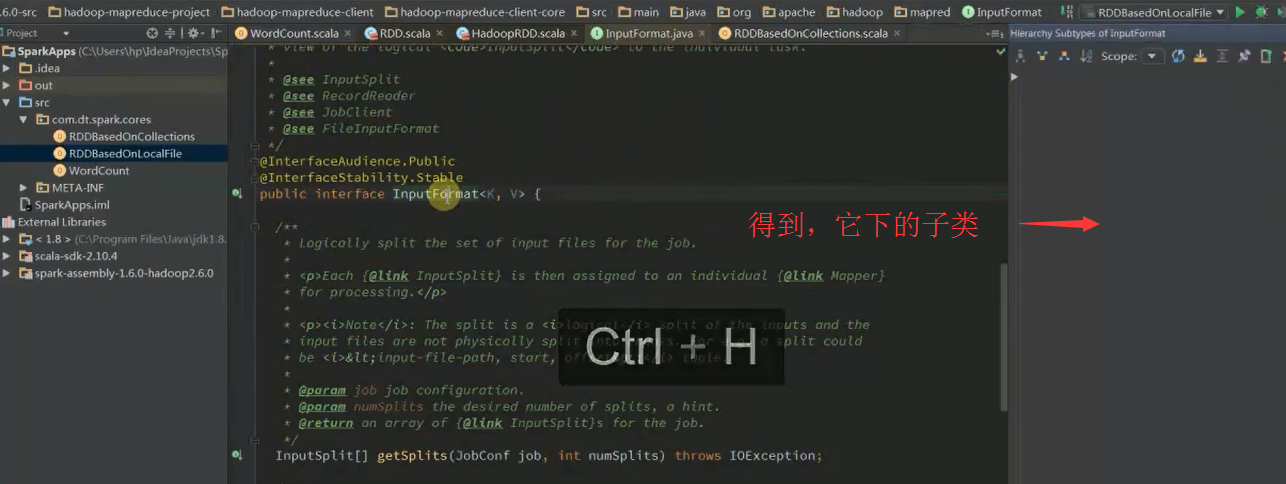


好的,关于此处的源码解读,自行去深究。不多赘述。
以上是在local模式下,下面开始
集群模式


Spark RDD概念学习系列之RDD的创建(六)的更多相关文章
- Spark RDD概念学习系列之RDD的转换(十)
RDD的转换 Spark会根据用户提交的计算逻辑中的RDD的转换和动作来生成RDD之间的依赖关系,同时这个计算链也就生成了逻辑上的DAG.接下来以“Word Count”为例,详细描述这个DAG生成的 ...
- Spark RDD概念学习系列之RDD的checkpoint(九)
RDD的检查点 首先,要清楚.为什么spark要引入检查点机制?引入RDD的检查点? 答:如果缓存丢失了,则需要重新计算.如果计算特别复杂或者计算耗时特别多,那么缓存丢失对于整个Job的影响是不容 ...
- Spark RDD概念学习系列之RDD的操作(七)
RDD的操作 RDD支持两种操作:转换和动作. 1)转换,即从现有的数据集创建一个新的数据集. 2)动作,即在数据集上进行计算后,返回一个值给Driver程序. 例如,map就是一种转换,它将数据集每 ...
- Spark RDD概念学习系列之RDD是什么?(四)
RDD是什么? 通俗地理解,RDD可以被抽象地理解为一个大的数组(Array),但是这个数组是分布在集群上的.详细见 Spark的数据存储 Spark的核心数据模型是RDD,但RDD是个抽象类 ...
- Spark RDD概念学习系列之RDD的缺点(二)
RDD的缺点? RDD是Spark最基本也是最根本的数据抽象,它具备像MapReduce等数据流模型的容错性,并且允许开发人员在大型集群上执行基于内存的计算. 为了有效地实现容错,(详细见ht ...
- Spark RDD概念学习系列之RDD的缓存(八)
RDD的缓存 RDD的缓存和RDD的checkpoint的区别 缓存是在计算结束后,直接将计算结果通过用户定义的存储级别(存储级别定义了缓存存储的介质,现在支持内存.本地文件系统和Tachyon) ...
- Spark RDD概念学习系列之RDD的依赖关系(宽依赖和窄依赖)(三)
RDD的依赖关系? RDD和它依赖的parent RDD(s)的关系有两种不同的类型,即窄依赖(narrow dependency)和宽依赖(wide dependency). 1)窄依赖指的是每 ...
- Spark RDD概念学习系列之rdd的依赖关系彻底解密(十九)
本期内容: 1.RDD依赖关系的本质内幕 2.依赖关系下的数据流视图 3.经典的RDD依赖关系解析 4.RDD依赖关系源码内幕 1.RDD依赖关系的本质内幕 由于RDD是粗粒度的操作数据集,每个Tra ...
- Spark RDD概念学习系列之RDD的5大特点(五)
RDD的5大特点 1)有一个分片列表,就是能被切分,和Hadoop一样,能够切分的数据才能并行计算. 一组分片(partition),即数据集的基本组成单位,对于RDD来说,每个分片都会被一个计 ...
随机推荐
- 《OD学HBase》20160820
一.案例 微博: 微博内容: 关注用户和粉丝用户: 添加或移除关注用户 查看关注用户的微博内容 微博数据存储: 响应时间 秒级 无延迟 (1)mysql分布式 (2)hbase数据库 使用HBase数 ...
- 如何为Eclipse安装Eclipse Marketplace插件
Eclipse Marketplace是个插件应用商店,很实用的一个功能. 打开 eclipse,help--Eclipse Marketplace Client就能找到 有的eclipse中没有这个 ...
- Tuning 01 Overview of Oracle Performance Tuning
永无止境的调优 service level agreements: 是一个量化的调优的指标. performance 只要满足业务OK就可以了, 没必要调的很多, 因为有得必有失, 一方面调的特别优化 ...
- JAVA网络编程【转】出处不详
网络编程 网络编程对于很多的初学者来说,都是很向往的一种编程技能,但是很多的初学者却因为很长一段时间无法进入网络编程的大门而放弃了对于该部分技术的学习. 在 学习网络编程以前,很多初学者可能觉得网络编 ...
- Gliffy Diagrams 好用的流程图工具
很好用!加上百度脑图!good!
- UC编程之网络通信(TCP/UDP)
网络常识 OSI 7层模型(人机交互) 物理层.数据链路层.网络层.传输层.会话层.表现层.应用层 常见协议: tcp/udp/ip/ftp/http... IP地址--就是计算机在网络中的地址,是一 ...
- JAVA使用JNI调用C++动态链接库
JAVA使用JNI调用C++动态链接库 使用JNI连接DLL动态链接库,并调用其中的函数 首先 C++中写好相关函数,文件名为test.cpp,使用g++编译为DLL文件,指令如下: g++ -sha ...
- c#快捷键大全
转发:http://zhidao.baidu.com/question/444655283 直接贴出来吧(关于VS的): 快捷键 功能 CTRL + SHIFT + B生成解决方案 CTRL + F7 ...
- css去掉a标签点击后的虚线框
outline是css3的一个属性,用的很少. 声明,这是个不能兼容的css属性,在ie6.ie7.遨游浏览器都不兼容. outline控制的到底是什么呢? 当聚焦a标签的时候,在a标签的区域周围会有 ...
- 基于CentOS与VmwareStation10搭建Oracle11G RAC 64集群环境:2.搭建环境-2.1创建虚拟机
2.1.创建虚拟机 2.1.1. 创建虚拟机节点1 2.1.2. 创建虚拟机节点2 操作如节点1. 基于CentOS与VmwareStation10搭建Oracle11G RAC 64集群环境所有链 ...