
理解java容器底层原理--手动实现HashMap
HashMap结构
HashMap的底层是数组+链表,百度百科找了张图:

先写个链表节点的类
package com.xzlf.collection2;

public class Node {

	int hash;

	Object key;

	Object value;

	Node next;

}
自定义一个HashMap,实现了put方法增加键值对,并解决了键重复的时候覆盖相应的节点
package com.xzlf.collection2;

/**

 * 自定义一个hashMap

 * 实现了put方法增加键值对,并解决了键重复的时候覆盖相应的节点

 * @author xzlf

 *

 */

public class MyHashMap {

	private Node[] table;//位桶 .bucket  array

	private int size;//存放键值对的个数

	public MyHashMap() {

		table = new Node[16];//长度一般定义成2的整数次幂

	}

	public void put(Object key, Object value) {

		Node newNode = new Node();

		newNode.hash = myHash(key.hashCode(), table.length);

		newNode.key = key;

		newNode.value = value;

		Node tmp = table[newNode.hash];

		Node iterLast = null;//正在遍历的最后一个元素

		boolean keyRepeat = false;

		if(tmp == null) {

			//此处数组元素为空,则直接将新节点放进去

			table[newNode.hash] = newNode;

		}else {

			//此处数组元素不为空。则遍历对应链表。。

			while(tmp != null) {

				// 判断是否有重复的键

				if(key.equals(tmp.key)) {

					keyRepeat = true;

					// 键重复,直接覆盖value其他的值(hash,key,next)保持不变。

					tmp.value = value;

					break;

				}else {

					iterLast = tmp;

					tmp = tmp.next;

				}

			}

			if(!keyRepeat) {

				//key没有重复的情况,则添加到链表最后。

				iterLast.next = newNode;

			}

		}

	}

	public static int myHash(int v, int length) {

//		System.out.println(v&(length - 1));

		return v&(length - 1);// 位运算把元素散列到各位位置

	}
我们在写个main() 方法测试一下:
目前还没有重写toString() 方法,我们先把计算位置的方法加一条打印语句,然后在最后的输出语句加上断点,用debug模式查看
public static int myHash(int v, int length) {

		System.out.println(v&(length - 1));

		return v&(length - 1);// 位运算把元素散列到各位位置

	}

	public static void main(String[] args) {

		MyHashMap map = new MyHashMap();

		map.put(10, "aa");

		map.put(20, "bb");

		map.put(30, "cc");

		System.out.println(map);

	}
debug模式运行代码,控制台输出了元素存放位置:

我们看下10 4 14 位置对应的值是否对应上 aa bb cc

debug模式中可以看到添加的变量,说明数据添加进去了
我们还要测试下键重复和桶位在同一位置情况
先用以下代码,找出在存放位置为索引8(可以自己定义)的键:
for (int i = 10; i < 100; i++) {

			if (myHash(i,16) == 8) {

				System.out.println(i + "---" + myHash(i, 16));//24, 40,56,72,88

			}

		}
找出来是24, 40,56,72,88:
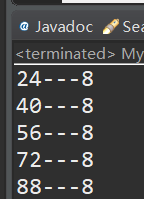
用以下代码测试键重复,和存放位置一直情况:
public static void main(String[] args) {

		MyHashMap map = new MyHashMap();

		map.put(10, "aa");

		map.put(20, "bb");

		map.put(30, "cc");

		map.put(10, "ssss");

		map.put(24, "dd");

		map.put(56, "ee");

		map.put(72, "ff");

		map.put(56, "java");

		System.out.println(map);

	}
还是用debug模式测试:

8和10的位置都是预期效果。接下来我们可以去重写toString方法,以方便我们查看结果。
版本二:重写toString()
package com.xzlf.collection2;

/**

 * 自定义一个hashMap

 * 实现toString方法,方便查看Map中的键值对信息

 * @author xzlf

 *

 */

public class MyHashMap2 {

	private Node[] table;//位桶 .bucket  array

	private int size;//存放键值对的个数

	public MyHashMap2() {

		table = new Node[16];//长度一般定义成2的整数次幂

	}

	public void put(Object key, Object value) {

		Node newNode = new Node();

		newNode.hash = myHash(key.hashCode(), table.length);

		newNode.key = key;

		newNode.value = value;

		Node tmp = table[newNode.hash];

		Node iterLast = null;//正在遍历的最后一个元素

		boolean keyRepeat = false;

		if(tmp == null) {

			//此处数组元素为空,则直接将新节点放进去

			table[newNode.hash] = newNode;

		}else {

			//此处数组元素不为空。则遍历对应链表。。

			while(tmp != null) {

				// 判断是否有重复的键

				if(key.equals(tmp.key)) {

					keyRepeat = true;

					// 键重复,直接覆盖value其他的值(hash,key,next)保持不变。

					tmp.value = value;

					break;

				}else {

					iterLast = tmp;

					tmp = tmp.next;

				}

			}

			if(!keyRepeat) {

				//key没有重复的情况,则添加到链表最后。

				iterLast.next = newNode;

			}

		}

	}

	public static int myHash(int v, int length) {

//		System.out.println(v&(length - 1));

		return v&(length - 1);// 位运算把元素散列到各位位置

	}

	@Override

	public String toString() {

		StringBuilder sb = new StringBuilder("{");

		// 遍历位桶数组

		for (int i = 0; i < table.length; i++) {

			Node tmp = table[i];

			//遍历链表

			while(tmp != null) {

				sb.append(tmp.key + ":" + tmp.value + ",");

				tmp = tmp.next;

			}

		}

		sb.setCharAt(sb.length() - 1, '}');

		return sb.toString();

	}

	public static void main(String[] args) {

		MyHashMap2 map = new MyHashMap2();

		map.put(10, "aa");

		map.put(20, "bb");

		map.put(30, "cc");

		map.put(10, "ssss");

		map.put(24, "dd");

		map.put(56, "ee");

		map.put(72, "ff");

		map.put(56, "java");

		System.out.println(map);

	}

}
运行测试:
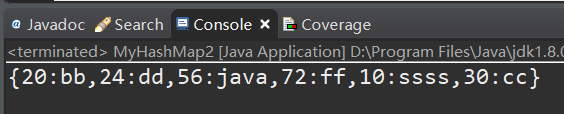
没有问题,继续添加get() 方法。
版本三:添加get方法
package com.xzlf.collection2;

/**

 * 自定义一个hashMap

 * 添加get方法

 * @author xzlf

 *

 */

public class MyHashMap3 {

	private Node[] table;//位桶 .bucket  array

	private int size;//存放键值对的个数

	public MyHashMap3() {

		table = new Node[16];//长度一般定义成2的整数次幂

	}

	public void put(Object key, Object value) {

		Node newNode = new Node();

		newNode.hash = myHash(key.hashCode(), table.length);

		newNode.key = key;

		newNode.value = value;

		Node tmp = table[newNode.hash];

		Node iterLast = null;//正在遍历的最后一个元素

		boolean keyRepeat = false;

		if(tmp == null) {

			//此处数组元素为空,则直接将新节点放进去

			table[newNode.hash] = newNode;

		}else {

			//此处数组元素不为空。则遍历对应链表。。

			while(tmp != null) {

				// 判断是否有重复的键

				if(key.equals(tmp.key)) {

					keyRepeat = true;

					// 键重复,直接覆盖value其他的值(hash,key,next)保持不变。

					tmp.value = value;

					break;

				}else {

					iterLast = tmp;

					tmp = tmp.next;

				}

			}

			if(!keyRepeat) {

				//key没有重复的情况,则添加到链表最后。

				iterLast.next = newNode;

			}

		}

	}

	public static int myHash(int v, int length) {

//		System.out.println(v&(length - 1));

		return v&(length - 1);// 位运算把元素散列到各位位置

	}

	@Override

	public String toString() {

		StringBuilder sb = new StringBuilder("{");

		// 遍历位桶数组

		for (int i = 0; i < table.length; i++) {

			Node tmp = table[i];

			//遍历链表

			while(tmp != null) {

				sb.append(tmp.key + ":" + tmp.value + ",");

				tmp = tmp.next;

			}

		}

		sb.setCharAt(sb.length() - 1, '}');

		return sb.toString();

	}

	public Object get(Object key) {

		int hash = myHash(key.hashCode(), table.length);

		Object value = null;

		Node tmp = table[hash];

		while(tmp != null) {

			if(key.equals(tmp.key)) {//如果找到了,则返回对应的值

				value = tmp.value;

				break;

			}else {

				tmp = tmp.next;

			}

		}

		return value;

	}

	public static void main(String[] args) {

		MyHashMap3 map = new MyHashMap3();

		map.put(10, "aa");

		map.put(20, "bb");

		map.put(30, "cc");

		map.put(10, "ssss");

		map.put(24, "dd");

		map.put(56, "ee");

		map.put(72, "ff");

		map.put(56, "java");

		System.out.println(map);

		System.out.println(map.get(10));

		System.out.println(map.get(30));

		System.out.println(map.get(72));

		System.out.println(map.get(78));

	}

}
运行测试:

也没问题。
现在已经把hashMap的核心功能get put 实现了。
最后完善一下。
版本四:添加泛型,完善size计数
Node添加泛型:
package com.xzlf.collection2;

public class Node2<K, V> {

	int hash;

	K key;

	V value;

	Node2 next;

}
自定义hashmap添加泛型并完善size计数:
package com.xzlf.collection2;

/**

 * 自定义一个hashMap

 * 增加泛型,修复部分bug

 * @author xzlf

 *

 */

public class MyHashMap4<K, V> {

	private Node2[] table;//位桶 .bucket  array

	private int size;//存放键值对的个数

	public MyHashMap4() {

		table = new Node2[16];//长度一般定义成2的整数次幂

	}

	public void put(K key, V value) {

		Node2 newNode2 = new Node2();

		newNode2.hash = myHash(key.hashCode(), table.length);

		newNode2.key = key;

		newNode2.value = value;

		Node2 tmp = table[newNode2.hash];

		Node2 iterLast = null;//正在遍历的最后一个元素

		boolean keyRepeat = false;

		if(tmp == null) {

			//此处数组元素为空,则直接将新节点放进去

			table[newNode2.hash] = newNode2;

			size++;

		}else {

			//此处数组元素不为空。则遍历对应链表。。

			while(tmp != null) {

				// 判断是否有重复的键

				if(key.equals(tmp.key)) {

					keyRepeat = true;

					// 键重复,直接覆盖value其他的值(hash,key,next)保持不变。

					tmp.value = value;

					break;

				}else {

					iterLast = tmp;

					tmp = tmp.next;

				}

			}

			if(!keyRepeat) {

				//key没有重复的情况,则添加到链表最后。

				iterLast.next = newNode2;

				size++;

			}

		}

	}

	public static int myHash(int v, int length) {

//		System.out.println(v&(length - 1));

		return v&(length - 1);// 位运算把元素散列到各位位置

	}

	@Override

	public String toString() {

		StringBuilder sb = new StringBuilder("{");

		// 遍历位桶数组

		for (int i = 0; i < table.length; i++) {

			Node2 tmp = table[i];

			//遍历链表

			while(tmp != null) {

				sb.append(tmp.key + ":" + tmp.value + ",");

				tmp = tmp.next;

			}

		}

		sb.setCharAt(sb.length() - 1, '}');

		return sb.toString();

	}

	public V get(K key) {

		int hash = myHash(key.hashCode(), table.length);

		V value = null;

		Node2 tmp = table[hash];

		while(tmp != null) {

			if(key.equals(tmp.key)) {//如果找到了,则返回对应的值

				value = (V) tmp.value;

				break;

			}else {

				tmp = tmp.next;

			}

		}

		return value;

	}

	public static void main(String[] args) {

		MyHashMap4<Integer, String> map = new MyHashMap4<>();

		map.put(10, "aa");

		map.put(20, "bb");

		map.put(30, "cc");

		map.put(10, "ssss");

		map.put(24, "dd");

		map.put(56, "ee");

		map.put(72, "ff");

		map.put(56, "java");

		System.out.println(map);

		System.out.println(map.get(10));

		System.out.println(map.get(30));

		System.out.println(map.get(72));

		System.out.println(map.get(78));

	}

}
运行测试:

泛型完毕。
至于扩容和remove方法可以参考我的另外两篇:
理解java容器底层原理–手动实现ArryList
https://mp.csdn.net/console/editor/html/105032218
和
理解java容器底层原理–手动实现LinkedList
理解java容器底层原理--手动实现HashMap的更多相关文章
- 理解java容器底层原理--手动实现HashSet
HashSet的底层其实就是HashMap,换句话说HashSet就是简化版的HashMap. 直接上代码: package com.xzlf.collection2; import java.uti ...
- 理解java容器底层原理--手动实现LinkedList
Node java 中的 LIinkedList 的数据结构是链表,而链表中每一个元素是节点. 我们先定义一下节点: package com.xzlf.collection; public class ...
- 理解java容器底层原理--手动实现ArrayList
为了照顾初学者,我分几分版本发出来 版本一:基础版本 实现对象创建.元素添加.重新toString() 方法 package com.xzlf.collection; /** * 自定义一个Array ...
- Java面试底层原理
面试发现经常有些重复的面试问题,自己也应该学会记录下来,最好自己能做成笔记,在下一次面的时候说得有条不紊,深入具体,面试官想必也很开心.以下是我个人总结,请参考: HashSet底层原理:(问了大几率 ...
- (前篇:NIO系列 推荐阅读) Java NIO 底层原理
出处: Java NIO 底层原理 目录 1.1. Java IO读写原理 1.1.1. 内核缓冲与进程缓冲区 1.1.2. java IO读写的底层流程 1.2. 四种主要的IO模型 1.3. 同步 ...
- Java 容器 & 泛型:五、HashMap 和 TreeMap的自白
Writer:BYSocket(泥沙砖瓦浆木匠) 微博:BYSocket 豆瓣:BYSocket Java 容器的文章这次应该是最后一篇了:Java 容器 系列. 今天泥瓦匠聊下 Maps. 一.Ma ...
- 10分钟看懂, Java NIO 底层原理
目录 写在前面 1.1. Java IO读写原理 1.1.1. 内核缓冲与进程缓冲区 1.1.2. java IO读写的底层流程 1.2. 四种主要的IO模型 1.3. 同步阻塞IO(Blocking ...
- 深入理解Java容器——HashMap
目录 存储结构 初始化 put resize 树化 get 为什么equals和hashCode要同时重写? 为何HashMap的数组长度一定是2的次幂? 线程安全 参考 存储结构 JDK1.8前是数 ...
- java容器的数据结构-ArrayList,LinkList,HashMap
ArrayList: 初始容量为10,底层实现是一个数组,Object[] elementData 自动扩容机制,当添加一个元素时,数组长度超过了elementData.leng,则会按照1.5倍进行 ...
随机推荐
- Chrome 经典插件
记录几个很喜欢的 Chrome 插件,怕之后找不到了. 1. Dark Theme 很喜欢的一个黑色主题! 2. Volume Booster 能把音量提高2倍的小插件!好用! 3. Looper f ...
- flask中 多对多的关系 主从表之间的的增删改查
# 角色表模型class Role(db.Model): r_id = db.Column(db.Integer, primary_key=True) r_name = db.Column(db.St ...
- 2.用eclipse创建maven Web
一.其他步骤与上一个博客相同,故不赘述,这里要记得选war→Finish 二.在项目上右键选Properties 三.搜索到Project Facets,把勾取消掉,点Apply 四.重新勾选后出现以 ...
- Python——五分钟理解函数式编程与闭包
本文始发于个人公众号:TechFlow,原创不易,求个关注 今天是Python专题的第9篇文章,我们来聊聊Python的函数式编程与闭包. 函数式编程 函数式编程这个概念我们可能或多或少都听说过,刚听 ...
- Python3安装Crypto加密包
Python3安装Crypto加密包 下载链接 加密包地址 步骤 下载加密包,解压加密包到Python安装目录下Lib\site-packages目录中,尝试在Pycharm中导入 from Cryp ...
- Git版本控制 Git、github,gitlab相关操作
目录 关于版本控制 版本管理工具 集中式管理 分布式管理 git版本管理 git介绍 软件安装 Git工作状态 原理流程步骤 git基本操作 对文件进行修改 分支 共享仓库 创建共享仓库: 共享仓库上 ...
- python爬虫之requests的基础使用
1.先安装requests库,打开cmd,输入:pip install requests
- 今天无意中看到了str_split这个函数
前2天做广点通统计接口进行回调时需要加密,其中Python对字符串遍历很方便. s = 'abcd' for ch in s: print ch 但是PHP我想了半天还是老样子for循环之类的: &l ...
- layui经典模块化前端UI框架初识
layui产生背景 layui相对于vue来说确实稍有逊色,但是官网提供的入门文档以及完善的框架结构,使的很多人开始用layui来开发前端页面,那么什么人会去使用layui呢? 针对后端开发人员,在对 ...
- spring-cloud feign的多参数传递方案
查看原文 一.GET请求多参数URL 1.方法一(推荐) @FeignClient(“microservice-provider-user”) public interface UserFeignCl ...