
抓取猫眼TOP100的数据
import requests
import re
import json
from multiprocessing import Pool
from multiprocessing import Manager
import time
import functools #函数的包装器

# 抓取猫眼TOP100的数据
# 第一步:下载页面
def get_one_page(url):
    # 设置UA
    ua_header = {"User-Agent":"Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/53"}
    response = requests.get(url, headers=ua_header)
    if response.status_code == 200:#OK
       return response.text
    return None

# 第二步:提取信息
def parse_one_page(html):
    # 使用正则表达式的懒惰+findall的模式来提取信息

    pattern = re.compile('<p class="name"[\s\S]*?title="([\s\S]*?)"[\s\S]*?<p class="star">([\s\S]*?)</p>[\s\S]*?<p class="releasetime">([\s\S]*?)</p>')
    items = re.findall(pattern, html)

    # 使用yield来返回信息给上层
    for item in items:
        yield{
              "title":item[0].strip(),
              "actor":item[1].strip(),
              "time":item[2].strip()
        }

# 第三步:保存到本地文件系统中
def write_to_file(item):
    # 存储成json格式,以便于将来能方便的提取出来
    with open("maoyanTop100.txt", 'a', encoding="utf-8") as f:
        f.write(json.dumps(item, ensure_ascii=False)+'\n')

#0-100: 0,10,20,...,90
#http://maoyan.com/board/4?offset=
def CrawlPage(lock, offset):
# 将下载页面,解析页面及保存信息放入一个函数中
    url = "http://maoyan.com/board/4?offset="+str(offset)
    html = get_one_page(url)
    for item in parse_one_page(html):
        lock.acquire() #加锁
        write_to_file(item)
        lock.release() #释放锁

if __name__ == "__main__":
    # 使用进程池来抓取数据
    # 在进程池之间通信或者加锁时需要用Manager
    manager = Manager()
    lock = manager.Lock()
    # 产生一个新的包装函数
    newCrawlPage = functools.partial(CrawlPage, lock)

    pool = Pool()
    pool.map(newCrawlPage, [i*10 for i in range(10)])
    pool.close()
    pool.join()
效果: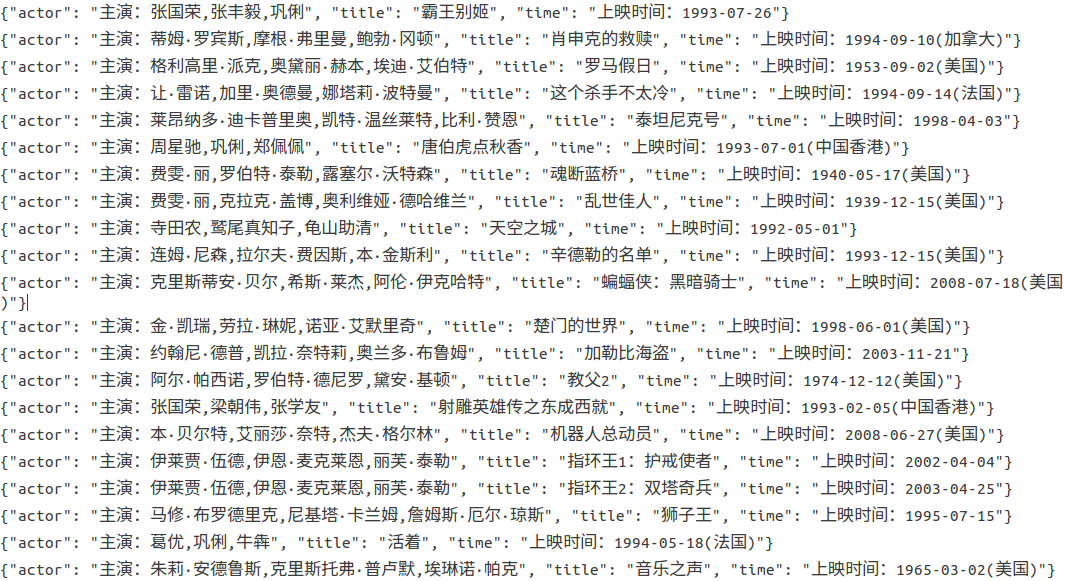
抓取猫眼TOP100的数据的更多相关文章
- Python爬取猫眼top100排行榜数据【含多线程】
# -*- coding: utf-8 -*- import requests from multiprocessing import Pool from requests.exceptions im ...
- Python Spider 抓取猫眼电影TOP100
""" 抓取猫眼电影TOP100 """ import re import time import requests from bs4 im ...
- Python爬虫之requests+正则表达式抓取猫眼电影top100以及瓜子二手网二手车信息(四)
requests+正则表达式抓取猫眼电影top100 一.首先我们先分析下网页结构 可以看到第一页的URL和第二页的URL的区别在于offset的值,第一页为0,第二页为10,以此类推. 二.< ...
- 使用Python抓取猫眼近10万条评论并分析
<一出好戏>讲述人性,使用Python抓取猫眼近10万条评论并分析,一起揭秘“这出好戏”到底如何? 黄渤首次导演的电影<一出好戏>自8月10日在全国上映,至今已有10天,其主演 ...
- python爬虫:爬取猫眼TOP100榜的100部高分经典电影
1.问题描述: 爬取猫眼TOP100榜的100部高分经典电影,并将数据存储到CSV文件中 2.思路分析: (1)目标网址:http://maoyan.com/board/4 (2)代码结构: (3) ...
- python+requests+re匹配抓取猫眼上映电影信息
python+requests抓取猫眼中上映电影,re正则匹配获取对应电影的排名,图片地址,片名,主演及上映时间和评分 import requests import re, json def get_ ...
- 使用 Python 抓取欧洲足球联赛数据
Web Scraping在大数据时代,一切都要用数据来说话,大数据处理的过程一般需要经过以下的几个步骤 数据的采集和获取 数据的清洗,抽取,变形和装载 数据的分析,探索和预测 ...
- 抓取Js动态生成数据且以滚动页面方式分页的网页
代码也可以从我的开源项目HtmlExtractor中获取. 当我们在进行数据抓取的时候,如果目标网站是以Js的方式动态生成数据且以滚动页面的方式进行分页,那么我们该如何抓取呢? 如类似今日头条这样的网 ...
- 如何用python抓取js生成的数据 - SegmentFault
如何用python抓取js生成的数据 - SegmentFault 如何用python抓取js生成的数据 1赞 踩 收藏 想写一个爬虫,但是需要抓去的的数据是js生成的,在源代码里看不到,要怎么才能抓 ...
随机推荐
- 正则search与match的区别
import re # #1.search和match的区别 # pattern = re.compile(r'\d+') # #match从头开始匹配 # m = pattern.match('on ...
- maven项目使用tomcat启动报错:Server Tomcat v8.5 Server at localhost failed to start
背景说明:1)该项目为maven项目,使用的maven的本地仓库里有不少之前使用过下载的jar包: 2)从svn下载该项目后,无报错情况: 3)部署到tomcat启动报错 如下 : 4)在网上搜索了很 ...
- 1.etcd
etcd v3版接口命令 etcdctl --cacert=/etc/kubernetes/pki/etcd/ca.crt --cert=/etc/kubernetes/pki/etcd/heal ...
- java虚拟机规范(se8)——java虚拟机的编译(三)
3.6 接受参数 如果n个参数传给一个实例的方法,按照约定,它们被接受并放在这个新方法创建的栈帧中的局部变量表里,在局部变量表中的序号从1到n.这些参数按照它们传递过来的顺序存放.例如: int ad ...
- Logback配置,error和普通日志分离
<?xml version="1.0" encoding="utf-8"?> <configuration> <springPro ...
- js运算符的优先级的顺序列表
优先级权重 运算符 17 ..[].new 16 () 15 ++.-- 14 !.~.+(单目).-(单目).typeof.void.delete 13 %.*./ 12 +(双目).-(双目) 1 ...
- JavaScript阶乘算法
题目: 计算所提供整数的阶乘. 如果使用字母n代表一个整数,则阶乘是所有小于或等于n的整数的乘积. 阶乘通常简写成 n! 例如: 5! = 1 * 2 * 3 * 4 * 5 = 120 使用递归实现 ...
- send csv to es with filebeat
## filebeat *.csv 2019-11-30 23:27:50,111111,222222,VIEW,333333333333 filebeat filebeat.inputs:- pat ...
- #Ubuntu16.0.4 LTS 安装RabbitMQ
1.ubuntu下安装配置rabbitmq-server服务器环境:ubuntu16.0.4(向下兼容14.0.4)软件版本:RabbitMQ 3.7.5 .Erlang 20.1.7参考文档:htt ...
- 链接socket加异常
try { channel = AmqpClient::Channel::Create("10.10.22.105", 5672, "admin", " ...