
python爬虫:爬取猫眼TOP100榜的100部高分经典电影
1、问题描述:
爬取猫眼TOP100榜的100部高分经典电影,并将数据存储到CSV文件中
2、思路分析:
(1)目标网址:http://maoyan.com/board/4
(2)代码结构:

(3) init(self)初始化函数
· hearders用到了fake_useragent库,用来随机生成请求头。
· datas空列表,用于保存爬取的数据。
def __init__(self,url):

    self.headers = {"User-Agent": UserAgent().random}

    self.url = url

    self.datas = list()
(4) getPage()函数
猫眼Top100榜总共有10页电影,每页的链接基本一样,只有最后一个数字在变化http://maoyan.com/board/4?offset=10,所以可以通过for循环来访问10页的电影。
# 通过for循环,获取10页的电影信息的源码

def getPage(self):

    for i in range(0,10):

        url = self.url + "?offset={0}".format(i*10)

        response = requests.get(url, headers = self.headers)

        if response.status_code == 200:

            self.parsePage(response.text)

        else:

            return None
(5)parsePage()函数
每页都有10部高分经典电影,通过BeautifulSoup获取每页10部电影的详细信息:名字、主演、上映时间、评分。
# 通过BeautifulSoup获取每页10部电影的详细信息

def parsePage(self, html):

    soup = BeautifulSoup(html, "html.parser")

    details = soup.find_all("dd")

    for dd in details:

        data = {}

        data["index"] = dd.find("i").text

        data["name"] = dd.find("p", class_ = "name").text

        data["star"] = dd.find("p", class_="star").text.strip()[3:]

        data["time"] = dd.find("p", class_="releasetime").text.strip()[5:]

        data["score"] = dd.find("p", class_="score").text

        self.datas.append(data)
(6)savaData()函数
通过DataFrame(),把Top100的电影存储到CSV文件中。
它默认的是按照列名的字典顺序排序的。想要自定义列的顺序,可以加columns字段
# 通过DataFrame,把Top100的电影存储到CSV文件中

def saveData(self):

    self.getPage()

    data = pd.DataFrame(self.datas)

    columns = ["index", "name", "star", "time", "score"]

    data.to_csv(".\maoyanTop100.csv", index=False, columns=columns)
3、效果展示
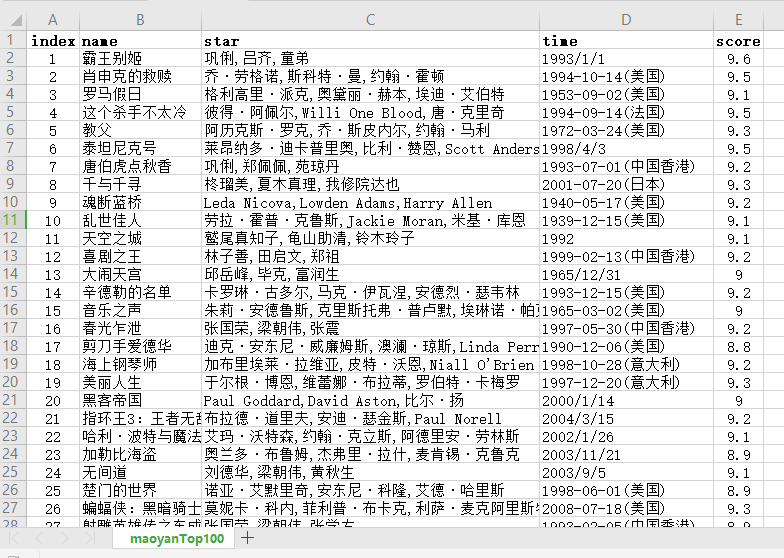
4、完整代码:
# -* conding: utf-8 *-

#author: wangshx6

#data: 2018-11-08

#description: 爬取猫眼TOP100榜的100部高分经典电影

import requests

from bs4 import BeautifulSoup

import pandas as pd

from fake_useragent import UserAgent

class MaoyanSpider(object):

    def __init__(self,url):

        self.headers = {"User-Agent": UserAgent().random}

        self.url = url

        self.datas = list()

    # 通过for循环,获取10页的电影信息的源码

    def getPage(self):

        for i in range(0,10):

            url = self.url + "?offset={0}".format(i*10)

            response = requests.get(url, headers = self.headers)

            if response.status_code == 200:

                self.parsePage(response.text)

            else:

                return None

    # 通过BeautifulSoup获取每页10部电影的详细信息

    def parsePage(self, html):

        soup = BeautifulSoup(html, "html.parser")

        details = soup.find_all("dd")

        for dd in details:

            data = {}

            data["index"] = dd.find("i").text

            data["name"] = dd.find("p", class_ = "name").text

            data["star"] = dd.find("p", class_="star").text.strip()[3:]

            data["time"] = dd.find("p", class_="releasetime").text.strip()[5:]

            data["score"] = dd.find("p", class_="score").text

            self.datas.append(data)

    # 通过DataFrame,把Top100的电影存储到CSV文件中

    def saveData(self):

        self.getPage()

        data = pd.DataFrame(self.datas)

        columns = ["index", "name", "star", "time", "score"]

        data.to_csv(".\maoyanTop100.csv", index=False, columns=columns)

if __name__ == "__main__":

    url = "http://maoyan.com/board/4"

    spider = MaoyanSpider(url)

    spider.saveData()
python爬虫:爬取猫眼TOP100榜的100部高分经典电影的更多相关文章
- 【爬虫】-爬取猫眼TOP100
原文崔庆才<python3网络爬虫实战> 本文为自学记录,如有侵权,请联系删除 目标: 熟悉正则表达式,以及爬虫流程 获取猫眼TOP100榜单 1.网站分析 目标站点为http://www ...
- Python 爬取 猫眼 top100 电影例子
一个Python 爬取猫眼top100的小栗子 import json import requests import re from multiprocessing import Pool #//进程 ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- Python爬虫|爬取喜马拉雅音频
"GOOD Python爬虫|爬取喜马拉雅音频 喜马拉雅是知名的专业的音频分享平台,用户规模突破4.8亿,汇集了有声小说,有声读物,儿童睡前故事,相声小品等数亿条音频,成为国内发展最快.规模 ...
- python爬虫爬取内容中,-xa0,-u3000的含义
python爬虫爬取内容中,-xa0,-u3000的含义 - CSDN博客 https://blog.csdn.net/aiwuzhi12/article/details/54866310
- Python爬虫爬取全书网小说,程序源码+程序详细分析
Python爬虫爬取全书网小说教程 第一步:打开谷歌浏览器,搜索全书网,然后再点击你想下载的小说,进入图一页面后点击F12选择Network,如果没有内容按F5刷新一下 点击Network之后出现如下 ...
- python爬虫—爬取英文名以及正则表达式的介绍
python爬虫—爬取英文名以及正则表达式的介绍 爬取英文名: 一. 爬虫模块详细设计 (1)整体思路 对于本次爬取英文名数据的爬虫实现,我的思路是先将A-Z所有英文名的连接爬取出来,保存在一个cs ...
随机推荐
- 谈谈Quartz中遇到的深坑
最近在项目开发的时候,根据业务需求,需要配置为自定义Quartz任务(即:用户可以自定义任务执行时间) 但是在即将写完的时候遇到一个非常头疼的问题: 一个redisTemplate 与 workOrd ...
- 在GitHub,他们是怎么玩的? (转)
文章来源: http://www.cocoachina.com/gamedev/misc/2014/0530/8616.html Github.com,现在是全世界程序员,尤其是开源爱好者的乐园. ...
- 电路中GND和GROUND、VCC,VDD,VEE,VSS
电路解析:GND和GROUND.VCC,VDD,VEE,VSS 参考: http://www.elecfans.com/dianzichangshi/20160822432514.html 一.解释版 ...
- 解决浏览器窗口缩小出现白色背景的bug
父容器上添加最小宽度min-width=xxxpx min-width的值大于浏览器横向滚动条出现时的宽度.
- TeamViewer安装使用
1.下载安装包 官网下载最新安装包 2.安装步骤 3.连接 输入密码即可控制伙伴电脑.
- lrzsz的使用
可以方便的在本地PC机和远程服务器之间传输文件. 1.下载 直接在centos上执行命令yum -y install lrzsz 2.上传文件 rz // 上传文件,执行命令rz,会跳出文件选择窗口, ...
- 学习笔记_TCP编程,服务端
public void startTcpService(String ip) { try { InetAddress ipAddress = InetAddress.getByName(ip); tc ...
- Apache Module mod_ssl
http://httpd.apache.org/docs/current/mod/mod_ssl.html Description: Strong cryptography using the Sec ...
- 【js基础修炼之路】— 我理解的原型链
提起原型链,大家并不陌生,但是对于新人来说一提到原型方面的东西就会比较懵.在我自一次面试的时候,面试官也给我提了这样的问题,当时就按照我的理解说了一些,但是很肤浅,在此我希望给刚入门的前端小伙伴聊一下 ...
- JavaRebel 2.0 发布,一个JVM插件
JavaRebel是一个JVM插件(-javaagent),能够即时重载java class更改,因此不需要重新部署一个应用或者重启容器,节约开发者时间. JavaRebel 2.0的新特征: 改变了 ...