
spark学习收集
spark优化:
http://www.cnblogs.com/hark0623/p/5533803.html
董西成学生写的经验分享(很详细很强大)
spark官网 API
http://spark.apache.org/docs/latest/api/scala/index.html#org.apache.spark.api.java.JavaRDD
spark java api解读--简书
比如:repartitionAndSortWithinPartitions、fullOuterJoin、leftOuterJoin等等
http://www.jianshu.com/u/c8bdd2f507eb
还有今天踩的坑scala 的isInstanceOf、asInstanceOf (classOf)
Spark性能优化指南——高级篇(美团)
https://zhuanlan.zhihu.com/p/21483985
技术大牛-(李伯韬)的技术博客
http://www.cnblogs.com/bourneli/p/4394271.html
spark排错与优化---超时问题
http://blog.csdn.net/lsshlsw/article/details/49155087
《Spark 官方文档》Spark配置-spark官方文档--各参数
http://ifeve.com/spark-config/
FetchFailedException解决方案
http://blog.csdn.net/lsshlsw/article/details/51213610
spark JVM调优之调节executor堆外内存与连接等待时长
http://blog.csdn.net/hutao_hadoop/article/details/52694550
在独立集群模式下:
1. 集群task并行度:SPARK_ EXECUTOR_INSTANCES* SPARK_EXECUTOR_CORES;
2. 集群内存总量:(executor个数) * (SPARK_EXECUTOR_MEMORY+ spark.yarn.executor.memoryOverhead)+(SPARK_DRIVER_MEMORY+spark.yarn.driver.memoryOverhead)。
重点强调:Spark对Executor和Driver额外添加堆内存大小,Executor端:由spark.yarn.executor.memoryOverhead设置,默认值executorMemory * 0.07与384的最大值。Driver端:由spark.yarn.driver.memoryOverhead设置,默认值driverMemory * 0.07与384的最大值。
在yarn模式下,这些配置受yarn的配置限制。
RDD、DataFrame和DataSet的区别
http://www.jianshu.com/p/c0181667daa0
RDD是分布式的Java对象的集合。
DataFrame是分布式的Row对象的集合。
DataSet以Catalyst逻辑执行计划表示,并且数据以编码的二进制形式被存储,不需要反序列化就可以执行sorting、shuffle等操作。
sprk on yarn的CPU空闲问题
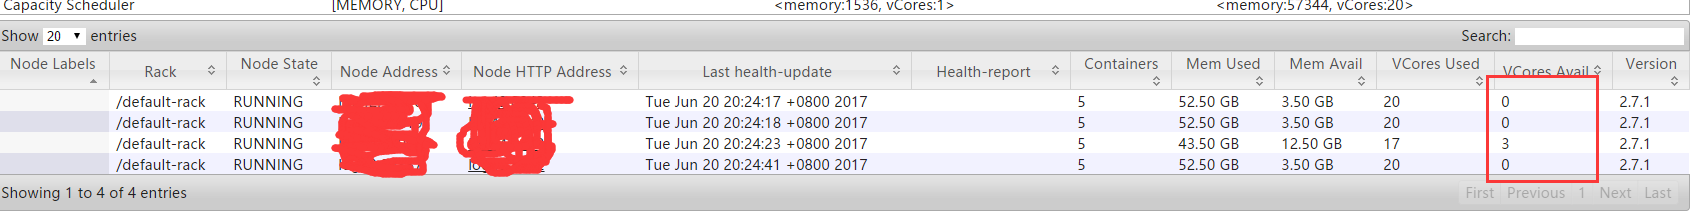
yarn默认情况下,只根据内存调度资源,所以spark on yarn运行的时候,即使通过--executor-cores指定vcore个数为N,但是在yarn的资源管理页面上看到使用的vcore个数还是1.----没效果。
http://blog.csdn.net/u012684933/article/details/46800207(原贴)
下边帖子说明了原因
http://www.jianshu.com/p/25788c6caf49(YARN Capacity Scheduler(容量调度器))
Capacity Scheduler有两种比较器用以比较两个资源的大小:
1.默认是DefaultResourceCalculator,它只考虑内存资源。
2.另外一种是DominantResourceCalculator,它采用了DRF比较算法,同时考虑内存和CPU两种资源。
解决:替换资源比较器
<property>

  <name>yarn.scheduler.capacity.resource-calculator</name>

  <!-- <value>org.apache.hadoop.yarn.util.resource.DefaultResourceCalculator</value> -->

  <value>org.apache.hadoop.yarn.util.resource.DominantResourceCalculator</value>

</property>
替换后发现内存和cpu都充分使用了
Spark学习+总结+面试
Spark数据本地化及 Locality Levels降级策略
http://www.w2请删掉bc.com/article/222724
今日头条分享
https://www.toutiao.com/c/user/7019620242/#mid=1588835969253380
spark学习收集的更多相关文章
- spark学习笔记总结-spark入门资料精化
Spark学习笔记 Spark简介 spark 可以很容易和yarn结合,直接调用HDFS.Hbase上面的数据,和hadoop结合.配置很容易. spark发展迅猛,框架比hadoop更加灵活实用. ...
- Spark学习(一) -- Spark安装及简介
标签(空格分隔): Spark 学习中的知识点:函数式编程.泛型编程.面向对象.并行编程. 任何工具的产生都会涉及这几个问题: 现实问题是什么? 理论模型的提出. 工程实现. 思考: 数据规模达到一台 ...
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
- 用Spark学习FP Tree算法和PrefixSpan算法
在FP Tree算法原理总结和PrefixSpan算法原理总结中,我们对FP Tree和PrefixSpan这两种关联算法的原理做了总结,这里就从实践的角度介绍如何使用这两个算法.由于scikit-l ...
- 用Spark学习矩阵分解推荐算法
在矩阵分解在协同过滤推荐算法中的应用中,我们对矩阵分解在推荐算法中的应用原理做了总结,这里我们就从实践的角度来用Spark学习矩阵分解推荐算法. 1. Spark推荐算法概述 在Spark MLlib ...
- Spark学习笔记2(spark所需环境配置
Spark学习笔记2 配置spark所需环境 1.首先先把本地的maven的压缩包解压到本地文件夹中,安装好本地的maven客户端程序,版本没有什么要求 不需要最新版的maven客户端. 解压完成之后 ...
- Spark学习笔记3(IDEA编写scala代码并打包上传集群运行)
Spark学习笔记3 IDEA编写scala代码并打包上传集群运行 我们在IDEA上的maven项目已经搭建完成了,现在可以写一个简单的spark代码并且打成jar包 上传至集群,来检验一下我们的sp ...
- 2019-1-24 Spark 学习 --总体架构
2019-1-24 Spark 学习 --总体架构 新建 模板 小书匠 1548339392539.jpg 1548339357270.jpg 1548339372461.jpg 1548339345 ...
- [转]Spark学习之路 (三)Spark之RDD
Spark学习之路 (三)Spark之RDD https://www.cnblogs.com/qingyunzong/p/8899715.html 目录 一.RDD的概述 1.1 什么是RDD? ...
随机推荐
- IIS 10 PHP 运行环境
1.下载php for windows 解压到指定目录 https://windows.php.net/download/ 2.安装iis 勾选CGI 3 ,处理映射 4.添加测试站点测试是否已经 ...
- 『正睿OI 2019SC Day3』
容斥原理 容斥原理指的是一种排重,补漏的计算思想,形式化的来说,我们有如下公式: \[\left | \bigcup_{i=1}^nS_i \right |=\sum_{i}|S_i|-\sum_{i ...
- mysql 事务的实现原理
开篇 相信大家都用过事务以及了解他的特点,如原子性(Atomicity),一致性(Consistency),隔离型(Isolation)以及持久性(Durability)等.今天想跟大家一起研究下事务 ...
- InstantiationAwareBeanPostProcessor 分析
Cglib之Enhancer创建动态代理https://blog.csdn.net/yaomingyang/article/details/82762697 https://blog.csdn.net ...
- 2、Vue构造器和扩展
1.VUE构造器简介 VUE构造器是一个非常重要的语法. 每个Vue.js应用都是通过构造函数Vue创建一个根实例. New了Vue对象,然后调用了这个vue对象的构造器,并向构造器传入了数据. 在实 ...
- 分布式系统根基:物理时钟和Lamport逻辑时钟
分布式系统解决了传统单体架构的单点问题和性能容量问题,另一方面也带来了很多的问题,其中一个问题就是多节点的时间同步问题:不同机器上的物理时钟难以同步,导致无法区分在分布式系统中多个节点的事件时序.19 ...
- English--虚拟语气和条件状语从句
English|虚拟语气和条件状语从句 虚拟语气在英语中,还是有一定地位的,毕竟大家都做着我有一百万的梦~~~ 前言 目前所有的文章思想格式都是:知识+情感. 知识:对于所有的知识点的描述.力求不含任 ...
- 15、vue项目封装axios并访问接口
1.在src下新建util文件夹,在util下新建request.js文件: 封装axios: import axios from 'axios' import QS from 'qs'; // im ...
- 字符串转换成float和double类型
double strtod(const char *nptr, char **endptr); float strtof(const char *nptr, char **endptr); long ...
- Spring Boot加载application.properties配置文件顺序规则
SpringApplication会从以下路径加载所有的application.properties文件: 1.file:./config/(当前目录下的config文件夹) 2.file:./(当前 ...