
HDFS 分布式文件系统
博客出处W3c:https://www.w3cschool.cn/hadoop/xvmi1hd6.html
简介
Hadoop Distributed File System,分布式文件系统
架构
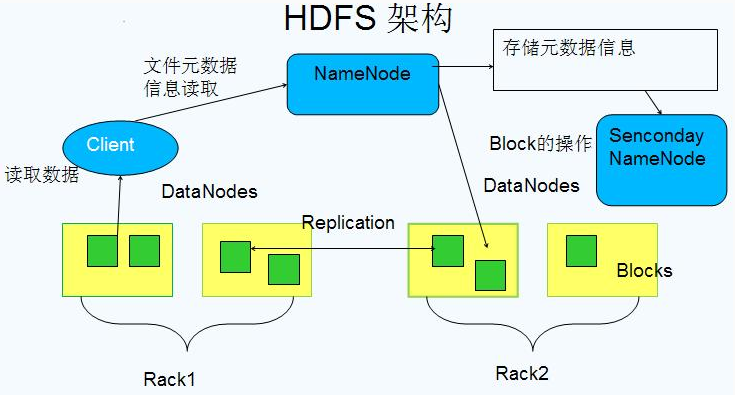
Block数据&##x5757;
基本存储单位,一般大小为64M(配置大的块主要是因为:1)减少搜寻时间,一般硬盘传输速率比寻道时间要快,大的块可以减少寻道时间;2)减少管理块的数据开销,每个块都需要在NameNode上有对应的记录;3)对数据块进行读写,减少建立网络的连接成本)
一个大文件会被拆分成一个个的块,然后存储于不同的机器。如果一个文件少于Block大小,那么实际占用的空间为其文件的大小
基本的读写S#x5355;位,类似于磁盘的页,每次都是读写一个块
- 每个块都会被复制到多台机器,默认复制3份
NameNode
存储文件的metadata,运行时所有数据都保存到内存,整个HDFS可存储的文件数受限于NameNode的内存大小
一个Block在NameNode中对应一条记录(一般一个block占用150字节),如果是大量的小文件,会消耗大量内存。同时map task的数量是由splits来决定的,所以用MapReduce处理大量的小文件时,就会产生过多的map task,线程管理开销将会增加作业时间。处理大量小文件的速度远远小于处理同等大小的大文件的速度。因此Hadoop建议存储大文件
数据会定时保存到本地磁盘,但不保存block的位置信息,而是由DataNode注册时上报和运行时维护(NameNode中与DataNode相关的信息并不保存到NameNode的文件系统中,而是NameNode每次重启后,动态重建)
- NameNode失效则整个HDFS都失效了,所以要保证NameNode的可用性
Secondary NameNode
- 定时与NameNode进行同步(定期合并文件系统镜像和编辑日&#x#x5FD7;,然后把合并后的传给NameNode,替换其镜像,并清空编辑日志,类似于CheckPoint机制),但NameNode失效后仍需要手工将其设置成主机
DataNode
保存具体的block数据
负责数据的读写操作和复制操作
DataNode启动时会向NameNode报告当前存储的数据块信息,后续也会定时报告修改信息
- DataNode之间会进行通信,复制数据块,保证数据的冗余性
HDFS 分布式文件系统的更多相关文章
- HDFS分布式文件系统资源管理器开发总结
HDFS,全称Hadoop分布式文件系统,作为Hadoop生态技术圈底层的关键技术之一,被设计成适合运行在通用硬件上的分布式文件系统.它和现有的分布式文件系统有很多共同点,但同时,它和其他的分布式 ...
- 通过Thrift访问HDFS分布式文件系统的性能瓶颈分析
通过Thrift访问HDFS分布式文件系统的性能瓶颈分析 引言 Hadoop提供的HDFS布式文件存储系统,提供了基于thrift的客户端访问支持,但是因为Thrift自身的访问特点,在高并发的访问情 ...
- Hadoop HDFS分布式文件系统 常用命令汇总
引言:我们维护hadoop系统的时候,必不可少需要对HDFS分布式文件系统做操作,例如拷贝一个文件/目录,查看HDFS文件系统目录下的内容,删除HDFS文件系统中的内容(文件/目录),还有HDFS管理 ...
- Hadoop基础-HDFS分布式文件系统的存储
Hadoop基础-HDFS分布式文件系统的存储 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HDFS数据块 1>.磁盘中的数据块 每个磁盘都有默认的数据块大小,这个磁盘 ...
- 认识HDFS分布式文件系统
1.设计基础目标 (1) 错误是常态,需要使用数据冗余 (2)流式数据访问.数据批量读而不是随机速写,不支持OLTP,hadoop擅长数据分析而不是事物处理. (3)文件采用一次性写多次读的模型, ...
- 1、HDFS分布式文件系统
1.HDFS分布式文件系统 分布式存储 分布式计算 2.hadoop hadoop含有四个模块,分别是 common. hdfs和yarn. common 公共模块. HDFS hadoop dist ...
- 我理解中的Hadoop HDFS分布式文件系统
一,什么是分布式文件系统,分布式文件系统能干什么 在学习一个文件系统时,首先我先想到的是,学习它能为我们提供什么样的服务,它的价值在哪里,为什么要去学它.以这样的方式去理解它之后在日后的深入学习中才能 ...
- 大数据基础总结---HDFS分布式文件系统
HDFS分布式文件系统 文件系统的基本概述 文件系统定义:文件系统是一种存储和组织计算机数据的方法,它使得对其访问和查找变得容易. 文件名:在文件系统中,文件名是用于定位存储位置. 元数据(Metad ...
- hdfs(分布式文件系统)优缺点
hdfs(分布式文件系统) 优点 支持超大文件 支持超大文件.超大文件在这里指的是几百M,几百GB,甚至几TB大小的文件.一般来说hadoop的文件系统会存储TB级别或者PB级别的数据.所以在企业的应 ...
- 【史上最全】Hadoop 核心 - HDFS 分布式文件系统详解(上万字建议收藏)
1. HDFS概述 Hadoop 分布式系统框架中,首要的基础功能就是文件系统,在 Hadoop 中使用 FileSystem 这个抽象类来表示我们的文件系统,这个抽象类下面有很多子实现类,究竟使用哪 ...
随机推荐
- 洛谷 P5595 【XR-4】歌唱比赛
洛谷 P5595 [XR-4]歌唱比赛 题目传送门 题目描述 小 X 参加了一场歌唱比赛. 经过一路鏖战,小 X 终于挺进了决赛,他的对手是小 Y. 这场歌唱比赛的冠军是由点赞数决定的,谁的点赞数高, ...
- Nginx的性能优化方案
nginx的优化 . gzip压缩优化 . expires缓存有还 . 网络IO事件模型优化 . 隐藏软件名称和版本号 . 防盗链优化 . 禁止恶意域名解析 . 禁止通过IP地址访问网站 . HTTP ...
- 大话设计模式Python实现-备忘录模式
备忘录模式(Memento Pattern):不破坏封装性的前提下捕获一个对象的内部状态,并在该对象之外保存这个状态,这样已经后就可将该对象恢复到原先保存的状态 下面是一个备忘录模式的demo: #! ...
- 为什么Linux 普通用户在虚拟机界面可以reboot 用ssh 不能reboot
应该是有 类似的权限控制. 如果是 localhost , 那么普通用户允许重启. 如果不是localhost, 比如ssh远程的,必须验证root权限.
- Easyui datagrid扩展子网格detailview增删改查详解
话不多gang,先上代码,将以下三个属性插入主网格的初始化参数中: view : detailview, //1 detailFormatter : function(index, row) { // ...
- Logstash:处理多个input
Logstash:处理多个input Logstash的整个pipleline分为三个部分: input插件:提取数据. 这可以来自日志文件,TCP或UDP侦听器,若干协议特定插件(如syslog或I ...
- 记netmvc中Html.BeginForm的一个大坑
在asp.net mvc中,很常使用using(Html.BeginForm()){}来生成表单提交 不传入参数时,默认提交到原始url 最坑的是,此表单自动提交时,会将所在页面的原始url的参数也一 ...
- 纯C语言实现循环双向链表创建,插入和删除
#include <stdio.h> #include <stdlib.h> typedef int ElemType; typedef struct DLNode{ Elem ...
- Java问题记录——OutOfMemoryError
Java问题记录——OutOfMemoryError 摘要:本文主要分析了OutOfMemoryError的产生原因. 没有分页导致占用大量内存 查看进程 使用 jps 命令查看当前运行的Java进程 ...
- Git 合并单个文件
有两个分支 # git branch -a * branchA branchB remotes/origin/branchC A分支合并B分支单个文件 注意是本地分支,还是远程分支 # git che ...