
Hadoop+Hbase+Zookeeper分布式存储构建
目录:
Hadoop+Hbase+zookeeper分布式存储构建
前言* Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,如亚马逊、Facebook和Yahoo等等。对于我来说,最近的一个使用点就是服务集成平台的日志分析。服务集成平台的日志量将会很大,而这也正好符合了分布式计算的适用场景(日志分析和索引建立就是两大应用场景)。
今天我们来实际搭建一下Hadoop 2.2.0版,实战环境为目前主流服务器操作系统CentOS 6.5系统。
一、实战环境
系统版本:CentOS 6.5 x86_64
JAVA版本:JDK-1.7.0_25
Hadoop版本:hadoop-2.2.0
192.168.172.59 namenode (充当namenode、secondary namenode和ResourceManager角色)
192.168.172.88 datanode1 (充当datanode、nodemanager角色)
192.168.172.89 datanode2 (充当datanode、nodemanager角色)
二、软件准备
1、Hadoop可以从Apache官方网站直接下载最新版本Hadoop2.2。官方目前是提供了linux32位系统可执行文件,所以如果需要在64位系统上部署则需要单独下载src 源码自行编译。(如果是真实线上环境,请下载64位hadoop版本,这样可以避免很多问题,这里我实验采用的是32位版本)
Hadoop下载地址
http://apache.claz.org/hadoop/common/hadoop-2.2.0/
Java 下载下载
http://www.oracle.com/technetwork/java/javase/downloads/index.html
2、我们这里采用三台CnetOS服务器来搭建Hadoop集群,分别的角色如上已经注明。
第一步:我们需要在三台服务器的/etc/hosts里面设置对应的主机名如下(真实环境可以使用内网DNS解析)
[root@node1 hadoop]# cat /etc/hosts
# Do not remove the following line, or various programs
# that require network functionality will fail.
127.0.0.1 localhost.localdomain localhost
192.168.172.59 node1
192.168.172.88 node2
192.168.172.89 node3
(注* 我们需要在namenode、datanode三台服务器上都配置hosts解析)
第二步:从namenode上无密码登陆各台datanode服务器,需要做如下配置:
在namenode 128上执行ssh-keygen,一路Enter回车即可。
然后把公钥/root/.ssh/id_rsa.pub拷贝到datanode服务器即可,拷贝方法如下:
ssh-copy-id -i .ssh/id_rsa.pub root@192.168.172.88
ssh-copy-id -i .ssh/id_rsa.pub root@192.168.172.89
三、Java安装配置
tar -xvzf jdk-7u25-linux-x64.tar.gz &&mkdir -p /usr/java/ ; mv /jdk1.7.0_25 /usr/java/ 即可。
安装完毕并配置java环境变量,在/etc/profile末尾添加如下代码:
export JAVA_HOME=/usr/java/jdk1.7.0_25/
export PATH=$JAVA_HOME/bin:$PATH
export CLASSPATH=$JAVE_HOME/lib/dt.jar:$JAVE_HOME/lib/tools.jar:./
保存退出即可,然后执行source /etc/profile 生效。在命令行执行java -version 如下代表JAVA安装成功。
[root@node1 ~]# java -version
java version "1.7.0_25"
Java(TM) SE Runtime Environment (build 1.7.0_25-b15)
Java HotSpot(TM) 64-Bit Server VM (build 23.25-b01, mixed mode)
(注* 我们需要在namenode、datanode三台服务器上都安装Java JDK版本)
- Hadoop版本安装
官方下载的hadoop2.2.0版本,不用编译直接解压安装就可以使用了,如下:
第一步解压:
tar -xzvf hadoop-2.2.0.tar.gz &&mv hadoop-2.2.0 /data/hadoop/
(注* 先在namenode服务器上都安装hadoop版本即可,datanode先不用安装,待会修改完配置后统一安装datanode)
第二步配置变量:
在/etc/profile末尾继续添加如下代码,并执行source /etc/profile生效。
export HADOOP_HOME=/data/hadoop/
export PATH=$PATH:$HADOOP_HOME/bin/
export JAVA_LIBRARY_PATH=/data/hadoop/lib/native/
(注* 我们需要在namenode、datanode三台服务器上都配置Hadoop相关变量)
五、配置Hadoop
在namenode上配置,我们需要修改如下几个地方:
1、修改vi /data/hadoop/etc/hadoop/core-site.xml 内容为如下:
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<!-- Put site-specific property overrides in this file. -->
<configuration>
<property>
<name>fs.default.name</name>
<value>hdfs://node1:9000</value>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/tmp/hadoop-${user.name}</value>
<description>A base for other temporary directories.</description>
</property>
</configuration>
2、修改vi /data/hadoop/etc/hadoop/mapred-site.xml内容为如下:
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<!-- Put site-specific property overrides in this file. -->
<configuration>
<property>
<name>mapred.job.tracker</name>
<value>node1:9001</value>
</property>
</configuration>
3、修改vi /data/hadoop/etc/hadoop/hdfs-site.xml内容为如下:
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
<property>
<name>dfs.name.dir</name>
<value>/data/hadoop/data_name1,/data/hadoop/data_name2</value>
</property>
<property>
<name>dfs.data.dir</name>
<value>/data/hadoop/data_1,/data/hadoop/data_2</value>
</property>
<property>
<name>dfs.replication</name>
<value>2</value>
</property>
</configuration>
4、在/data/hadoop/etc/hadoop/hadoop-env.sh文件末尾追加JAV_HOME变量:
echo "export JAVA_HOME=/usr/java/jdk1.7.0_25/" >> /data/hadoop/etc/hadoop/hadoop-env.sh
5、修改 vi /data/hadoop/etc/hadoop/masters文件内容为如下:
node1
6、修改vi /data/hadoop/etc/hadoop/slaves文件内容为如下:
node2
node3
如上配置完毕,以上的配置具体含义在这里就不做过多的解释了,搭建的时候不明白,可以查看一下相关的官方文档。
如上namenode就基本搭建完毕,接下来我们需要部署datanode,部署datanode相对简单,执行如下操作即可。
for i in `seq 88 89 ` ; do scp -r /data/hadoop/ root@192.168.172.$i:/data/ ; done
自此整个集群基本搭建完毕,接下来就是启动hadoop集群了。
六、启动hadoop并测试
在启动hadoop之前,我们需要做一步非常关键的步骤,需要在namenode上执行如下命令初始化name目录和数据目录。
cd /data/hadoop/ ; ./bin/hadoop namenode -format
那如何算初始化成功呢,如下截图成功创建name目录即正常:

然后启动hadoop所有服务,如下命令:
[root@node1 hadoop]# ./sbin/start-all.sh

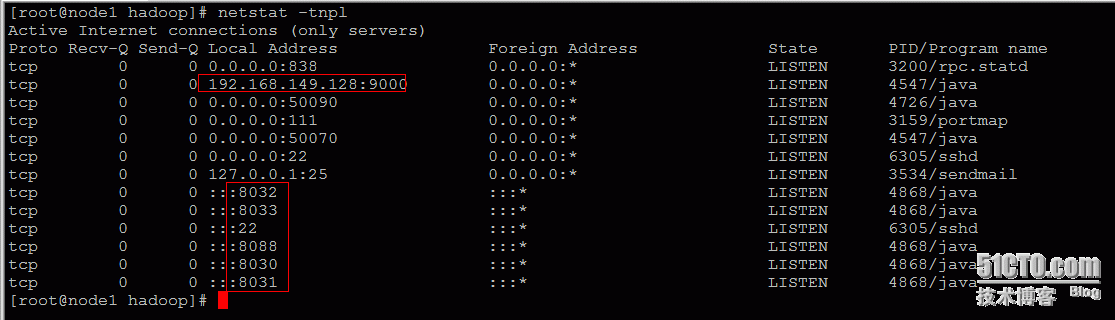
我们还可以查看相应的端口是否启动:netstat -ntpl
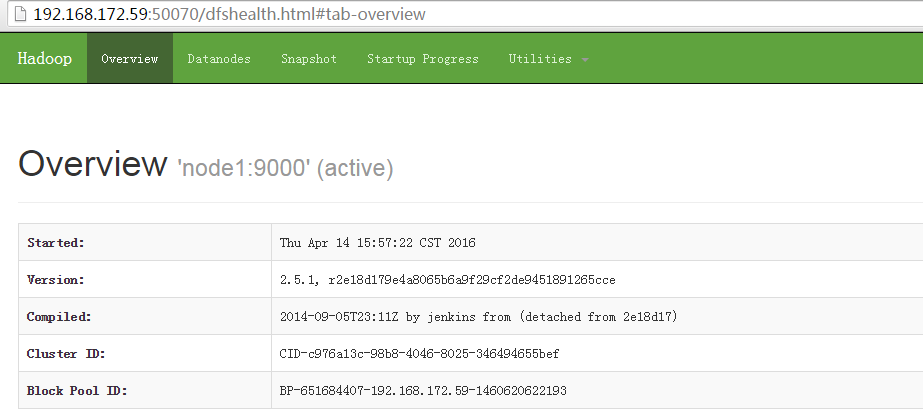
访问如下地址:http://192.168.172.59:50070/
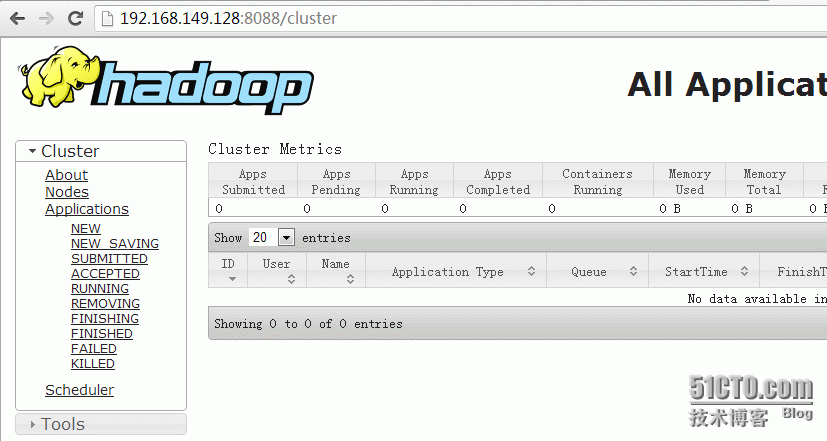
访问地址:http://192.168.172.59:8088/
搭建完成后,我们简单的实际操作一下,如下图:

自此hadoop基本搭建完毕,
部署zookeeper:
在node1上配置:
下载zookeeper3.4.6版本:
wget http://apache.fayea.com/zookeeper/zookeeper-3.4.6/zookeeper-3.4.6.tar.gz
tar -xzf zookeeper-3.4.6.tar.gz -C /export/servers/
#vim /export/servers/ zookeeper-3.4.6/conf/zoo.cfg写入如下内容:
# The number of milliseconds of each tick
tickTime=2000
# The number of ticks that the initial
# synchronization phase can take
initLimit=10
# The number of ticks that can pass between
# sending a request and getting an acknowledgement
syncLimit=5
# the directory where the snapshot is stored.
dataDir=/export/zookeeper
# the port at which the clients will connect
clientPort=2181
initLimit=5
syncLimit=2
dataLogDir=/export/zookeeper/logs
server.1=node1:2888:3888
server.2=node2:2888:3888
server.3=node3:2888:3888
注意:zk里面的node节点名称要一一对应哦,然后创建zk数据目录和日志路径:
mkdir -p /export/zookeeper/logs
echo 1 >/export/zookeeper/myid
如上在node1上配置好zk后,把zk整个程序同步到另外两台node2、node3。
执行如下脚本:
for i in `seq 88 89` ; do rsync -aP --delete /export/servers/zookeeper-3.4.6/ root@192.168.172.$i:/export/servers/zookeeper-3.4.6/ ;rsync -av /export/zookeeper/ root@192.168.172.$i:/export/; done
然后分别修改node2、node3的myid为2和3,命令如下:
在node2上执行:
echo 2 >/export/zookeeper/myid
在node3上执行:
echo 3 >/export/zookeeper/myid
执行完后,分别启动三台服务器的zk服务:
cd /export/servers/zookeeper-3.4.6/ ;./bin/zkServer.sh start

如上配置,zookeeper配置完毕,
配置hbase:
在node1上配置:
下载软件:hbase-0.96.2-hadoop2.tar.gz,然后执行如下命令:
tar xf hbase-0.96.2-hadoop2.tar.gz ;mv hbase-0.96.2-hadoop2 /export/hbase
然后进入hbase配置文件目录,如下图:
cd /export/hbase/conf/
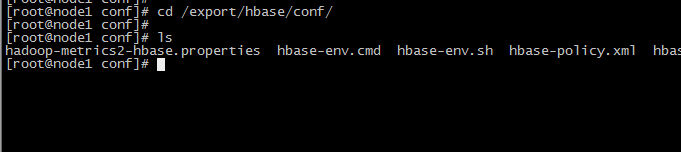
Vim hbase-site.xml内容如下:
<configuration>
<property>
<name>hbase.tmp.dir</name>
<value>/export/hbase/tmp</value>
</property>
<property>
<name>zookeeper.session.timeout</name>
<value>3600000</value>
</property>
<property>
<name>hbase.zookeeper.property.tickTime</name>
<value>180000</value>
</property>
<property>
<name>hbase.rootdir</name>
<value>hdfs://node1:9000/hbase</value>
</property>
<property>
<name>hbase.cluster.distributed</name>
<value>true</value>
</property>
<property>
<name>hbase.zookeeper.quorum</name>
<value>node1,node2,node3</value>
</property>
<!--禁止magor compaction-->
<property>
<name>hbase.hregion.majorcompaction</name>
<value>0</value>
</property>
<!--禁止split-->
<property>
<name>hbase.hregion.max.filesize</name>
<value>536870912000</value>
</property>
<!---->
<property>
<name>hbase.hstore.blockingStoreFiles</name>
<value>2100000000</value>
</property>
<property>
<name>hbase.regionserver.handler.count</name>
<value>100</value>
</property>
</configuration>
vim hbase-env.sh内容如下:
export JAVA_HOME=/export/servers/jdk1.6.0_25/
export HBASE_OPTS="-XX:+UseConcMarkSweepGC"
export HBASE_MANAGES_ZK=false
export HADOOP_HOME=/export/hadoop/
vim regionservers内容如下:
node2
node3
然后将node1 habse配置同步至node2、node3:
for i in `seq 88 89` ; do rsync -av /export/hbase/ root@192.168.172.$i:/export/ ; done
最好在node1启动整个集群hbase即可:
cd /export/hbase/;sh bin/start-hbase.sh
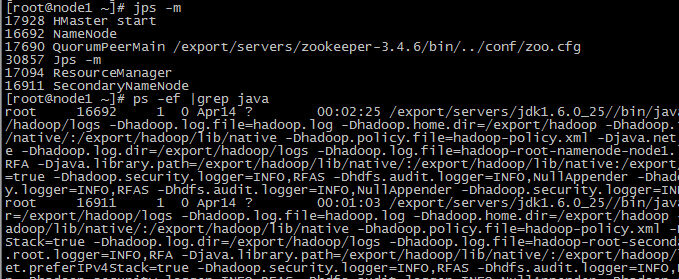
查看node1 JAVA进程信息如下:
最好查看hbase日志如下:

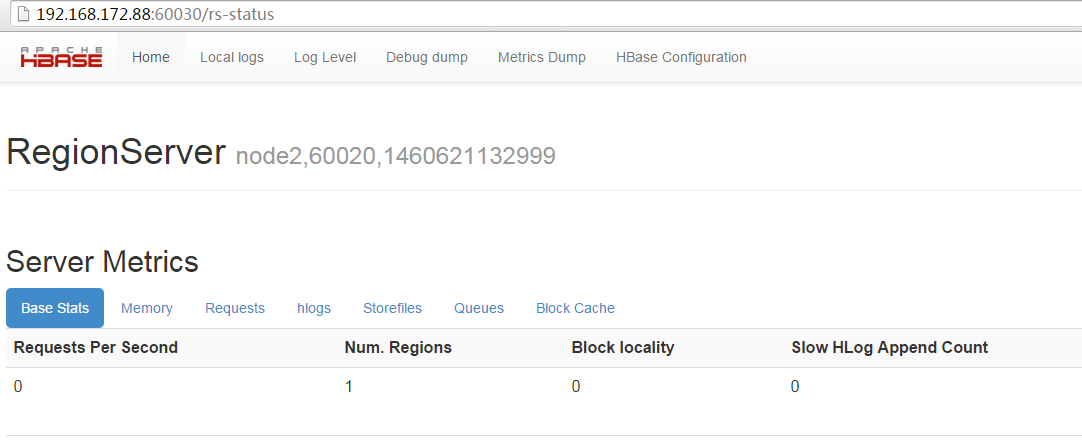
通过web查看hbase截图如下:

NODE2状态:
---------------------------------------------------------------------------
Hadoop+Hbase+Zookeeper分布式存储构建的更多相关文章
- [推荐]Hadoop+HBase+Zookeeper集群的配置
[推荐]Hadoop+HBase+Zookeeper集群的配置 Hadoop+HBase+Zookeeper集群的配置 http://wenku.baidu.com/view/991258e881c ...
- Hadoop,HBase,Zookeeper源码编译并导入eclipse
基本理念:尽可能的参考官方英文文档 Hadoop: http://wiki.apache.org/hadoop/FrontPage HBase: http://hbase.apache.org/b ...
- CentOS7搭建 Hadoop + HBase + Zookeeper集群
摘要: 本文主要介绍搭建Hadoop.HBase.Zookeeper集群环境的搭建 一.基础环境准备 1.下载安装包(均使用当前最新的稳定版本,截止至2017年05月24日) 1)jdk-8u131 ...
- Hadoop+HBase+ZooKeeper分布式集群环境搭建
一.环境说明 集群环境至少需要3个节点(也就是3台服务器设备):1个Master,2个Slave,节点之间局域网连接,可以相互ping通,下面举例说明,配置节点IP分配如下: Hostname IP ...
- prometheus 监控 hadoop + Hbase + zookeeper
1. run JMX exporter as a java agent with all the four daemons. For this I have added EXTRA_JAVA_OPTS ...
- hbase报错Could not initialize class org.apache.hadoop.hbase.protobuf.ProtobufUtil
Caused by: java.lang.RuntimeException: java.io.IOException: java.lang.reflect.InvocationTargetExcept ...
- org.apache.hadoop.hbase.master.HMasterCommandLine: Master exiting java.lang.RuntimeException: HMaster Aborted
前一篇的问题解决了,是 hbase 下面lib 包的jar问题,之前写MR的时候加错了包,替换掉了原来的包后出现另一问题:@ubuntu:/home/hadoop/hbase-0.94.6-cdh4. ...
- 大数据学习系列之七 ----- Hadoop+Spark+Zookeeper+HBase+Hive集群搭建 图文详解
引言 在之前的大数据学习系列中,搭建了Hadoop+Spark+HBase+Hive 环境以及一些测试.其实要说的话,我开始学习大数据的时候,搭建的就是集群,并不是单机模式和伪分布式.至于为什么先写单 ...
- HADOOP+SPARK+ZOOKEEPER+HBASE+HIVE集群搭建(转)
原文地址:https://www.cnblogs.com/hanzhi/articles/8794984.html 目录 引言 目录 一环境选择 1集群机器安装图 2配置说明 3下载地址 二集群的相关 ...
随机推荐
- 项目Alpha冲刺——集合
作业描述 课程: 软件工程1916|W(福州大学) 作业要求: 项目Alpha冲刺(团队) 团队名称: 火鸡堂 作业目标: 完成项目Alpha冲刺 团队信息 队名:火鸡堂 队员学号 队员姓名 博客地址 ...
- DT6.0开发之-调用信息评论
今天在做destoon6.0产品内页开发时候,用到了调取当前信息评论,所以就顺便做下笔记. 调用当前信息的评论代码: <!--{tag("table=destoot_comment&a ...
- 五.python小数据池,代码块的最详细、深入剖析
一,id,is,== 在Python中,id是什么?id是内存地址,那就有人问了,什么是内存地址呢? 你只要创建一个数据(对象)那么都会在内存中开辟一个空间,将这个数据临时加在到内存中,那么这个空间是 ...
- 树上最长不下降链 线段树合并+set
读错题了,然后写了一个树上 LIS,应该是对的吧...... code: #include <bits/stdc++.h> #define N 200005 #define LL long ...
- SVN 常用 还原项目
1.先修改本来两个文件,然后再提交到SVN 2.在日志界面,查看提交的文件,找到对应的版本号 3.找到对应的版本号(这里的版本号是1995,我提交生成的版本号 的前一个版本 才是我未作出修改的版本), ...
- 【NOIP2015】真题回顾
题目链接 神奇的幻方 按照题意模拟 信息传递 不难想到这是一个基环树的森林,找一个最小环就可以了 斗地主 毒瘤搜索题,时限不紧,但是要考虑全所有情况 需要注意的一些地方: 先枚举顺子.再枚举四带二.三 ...
- eclipse为项目设置jdk
1)在项目上右键选中properties,会进入如下界面 (2)然后点击Add Library,进入设置Library的界面 (3)选中JRE System Library进入下一界面就可以设置jdk ...
- linux修改固定IP
点击虚拟机菜单栏的编辑,选择虚拟网络编辑器 选择Vmnet8 NAT模式,查看子网ip:192.168.233.0 我们的虚拟机网络模式也需要选择NAT模式 打开虚拟机,输入:ip addr 查看当前 ...
- 【python】学习笔记之遇到的坑print输出报错
在Python3.x中,使用print时出错(SyntaxError: Missing parentheses in call to 'print')解决办法 Python2到Python3,很多基本 ...
- D3.js的v5版本入门教程(第十二章)—— D3.js中各种精美的图形
D3.js的v5版本入门教程(第十二章) D3中提供了各种制作常见图形的函数,在d3的v3版本中叫布局,通过d3.layout.xxx,来新建,但是到了v5,新建一个d3中基本的图形的方式变了(我也并 ...