
python爬虫--图片懒加载
图片懒加载
是一种反爬机制,图片懒加载是一种网页优化技术。图片作为一种网络资源,在被请求时也与普通静态资源一样,将占用网络资源,而一次性将整个页面的所有图片加载完,将大大增加页面的首屏加载时间。为了解决这种问题,通过前后端配合,使图片仅在浏览器当前视窗内出现时才加载该图片,达到减少首屏图片请求数的技术就被称为“图片懒加载”。
如何实现图片懒加载技术
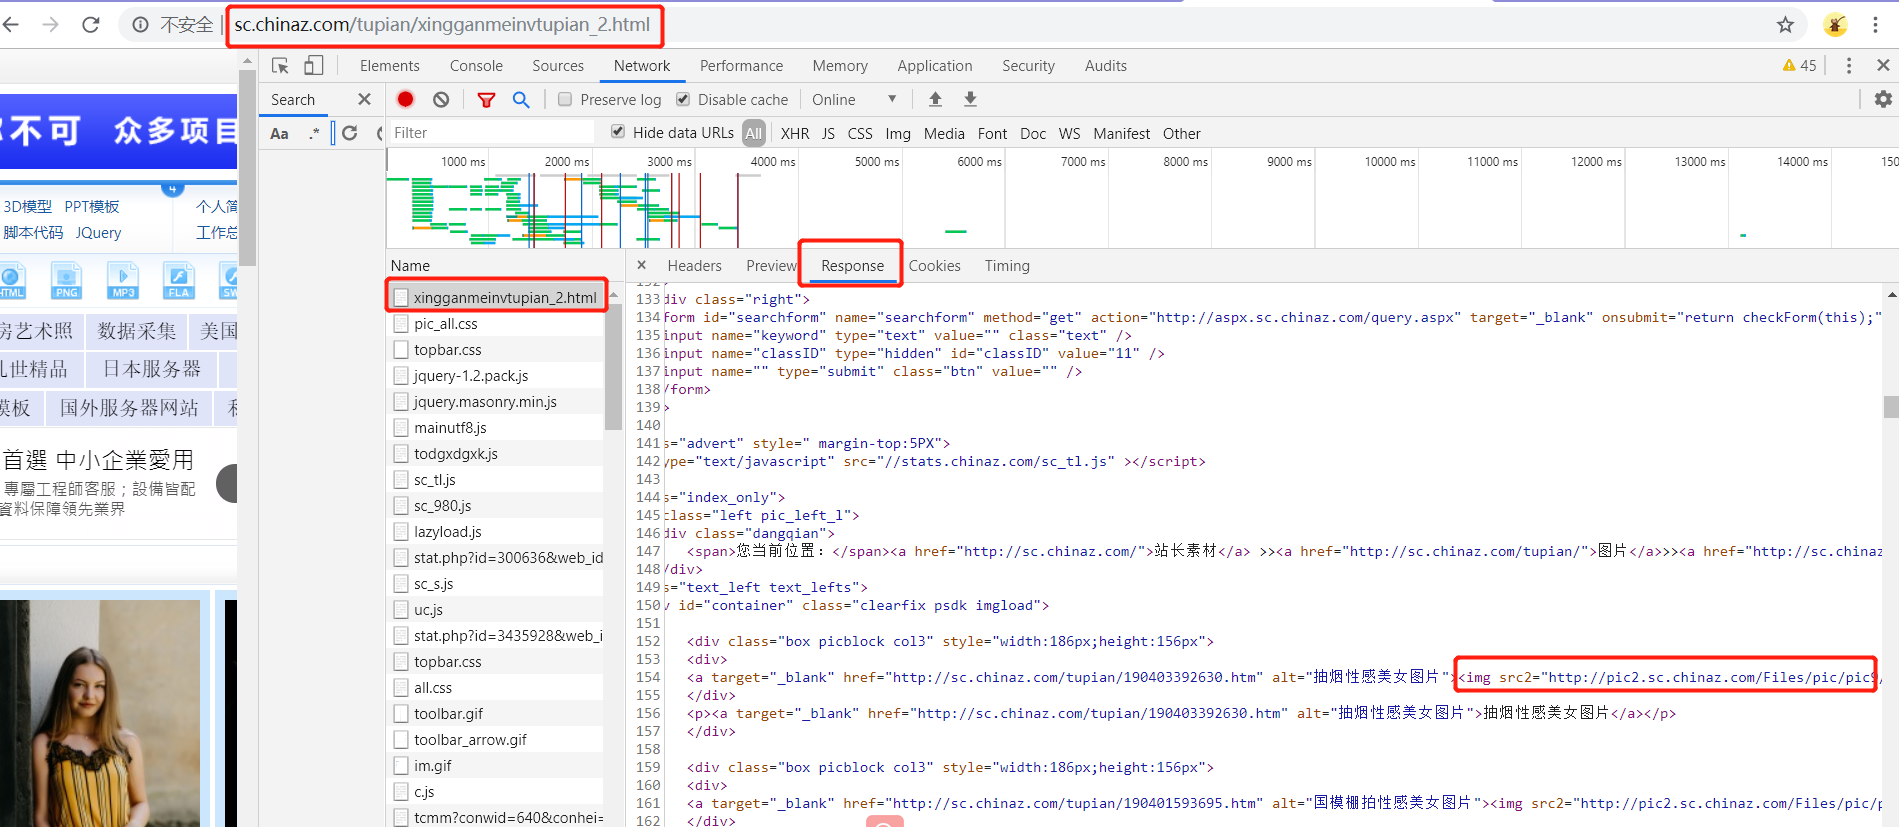
在网页源码中,在img标签中首先会使用一个“伪属性”(通常使用src2,original…)去存放真正的图片链接而并非是直接存放在src属性中。当图片出现到页面的可视化区域中,会动态将伪属性替换成src属性,完成图片的加载。
案例
爬取站长之家的图片素材
import scrapy

import requests

headers={

'USER_AGENT':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.97 Safari/537.36'

}

class ImgzzSpider(scrapy.Spider):

    name = 'imgzz'

    start_urls = ['http://sc.chinaz.com/tupian/']

    def parse(self, response):

        src = response.xpath('//*[@id="container"]/div/div[1]/a/img/@src').extract()

	    print(src) # 打印结果为空,这里的图片属性就应用的图片懒加载技术,其实图片的真正的src不是图片真正的属性

        for url in src:

            name = url.split('/')[-1]

            img = requests.get(url=url,headers=headers).content

            with open(name,'wb') as f:

                f.write(img)
分析:
正常访问时:
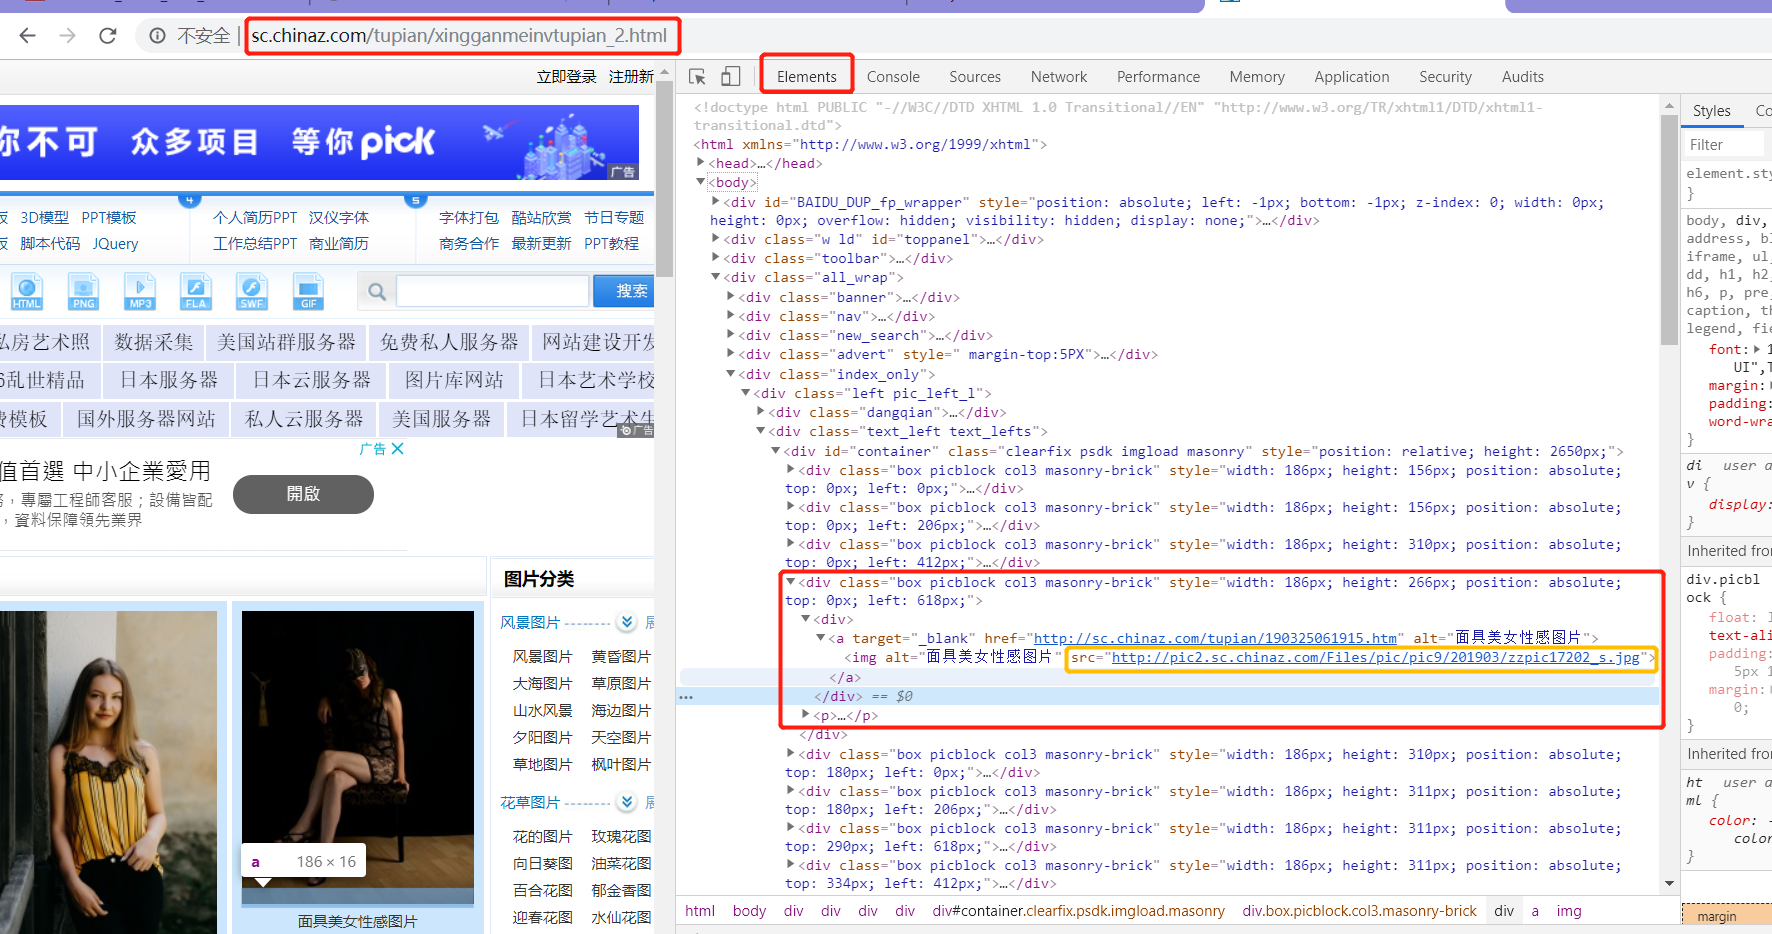
这样直接写xpath表达式定位标签的话获取的值为空
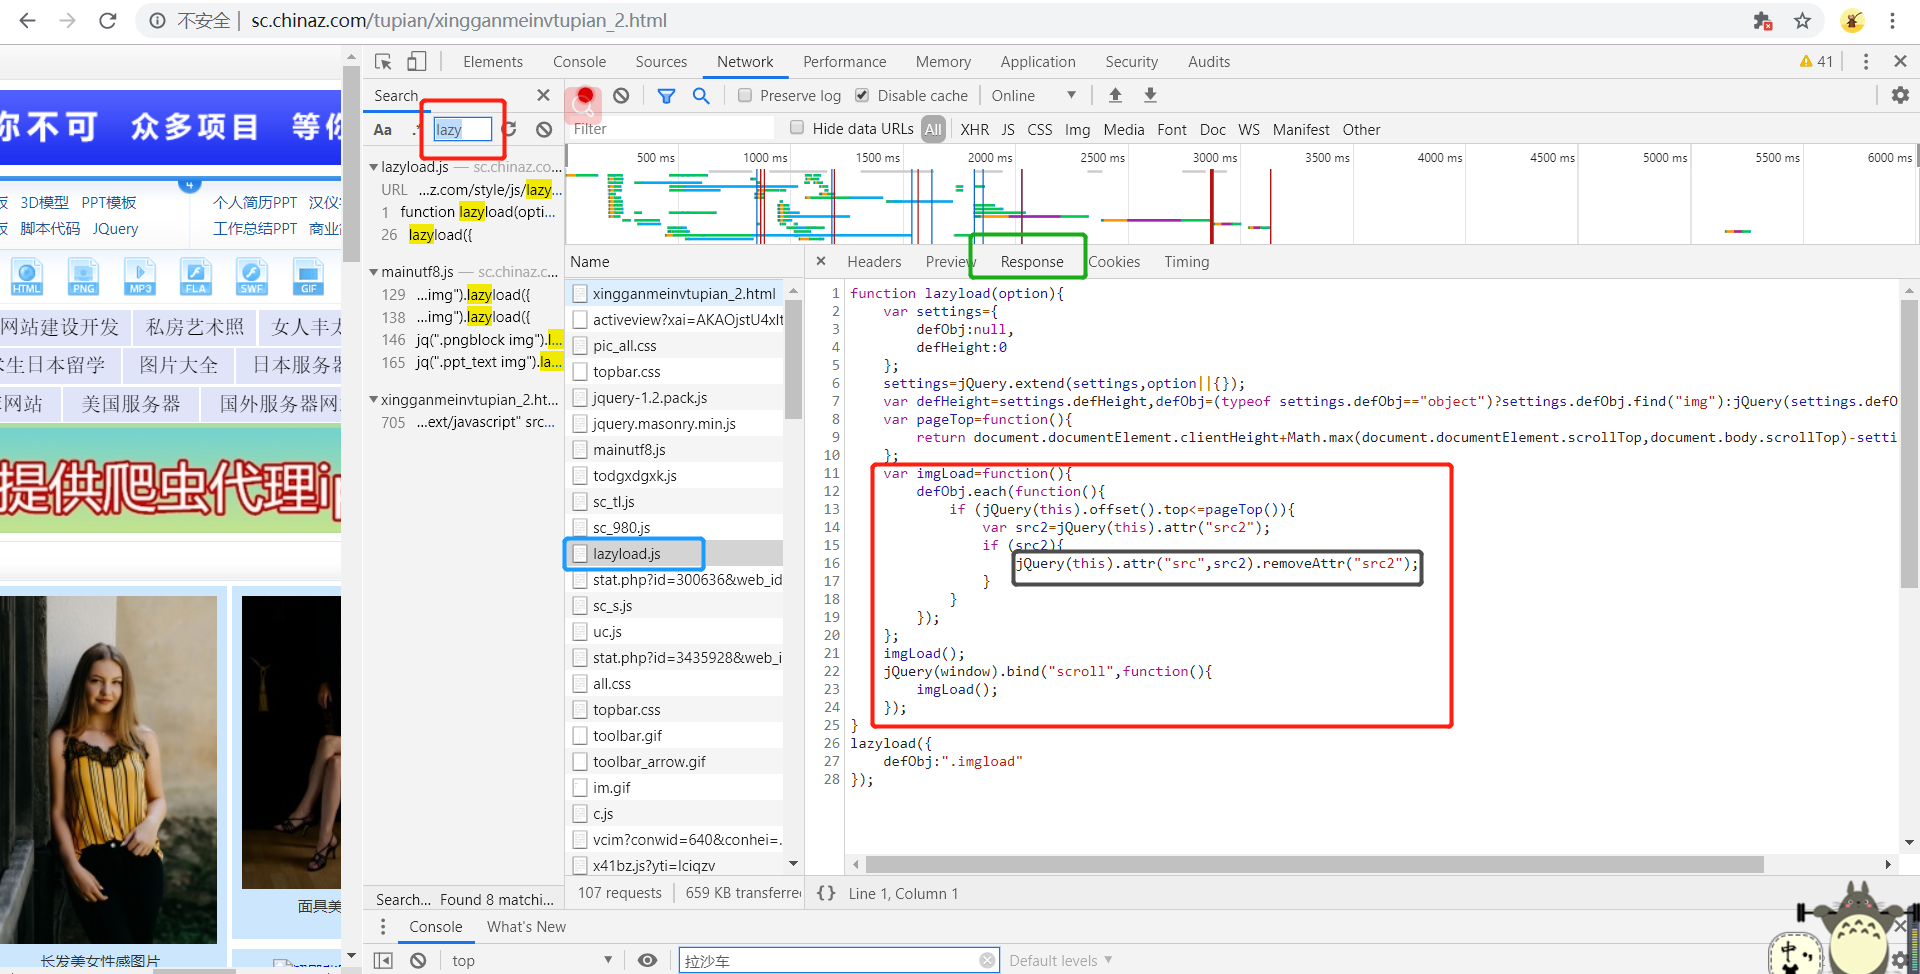
当图片出现到页面的可视化区域中,会动态将伪属性替换成src属性,完成图片的加载。通过js来完成对图片属性的替换
import scrapy

import requests

headers={

'USER_AGENT':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.97 Safari/537.36'

}

class ImgzzSpider(scrapy.Spider):

    name = 'imgzz'

    start_urls = ['http://sc.chinaz.com/tupian/']

    def parse(self, response):

        src = response.xpath('//*[@id="container"]/div/div[1]/a/img/@src2').extract() #改为图片的真正属性

	    print(src)

        for url in src:

            name = url.split('/')[-1]

            img = requests.get(url=url,headers=headers).content

            with open(name,'wb') as f:

                f.write(img)
python爬虫--图片懒加载的更多相关文章
- 08.Python网络爬虫之图片懒加载技术、selenium和PhantomJS
引入 今日概要 图片懒加载 selenium phantomJs 谷歌无头浏览器 知识点回顾 验证码处理流程 今日详情 动态数据加载处理 一.图片懒加载 什么是图片懒加载? 案例分析:抓取站长素材ht ...
- Python网络爬虫之图片懒加载技术、selenium和PhantomJS
引入 图片懒加载 selenium phantomJs 谷歌无头浏览器 知识点回顾 验证码处理流程 动态数据加载处理 一.图片懒加载 什么是图片懒加载? 案例分析:抓取站长素材http://sc.ch ...
- python爬虫之图片懒加载、selenium和phantomJS
一.什么是图片懒加载 在网页中,常常需要用到图片,而图片需要消耗较大的流量.正常情况下,浏览器会解析整个HTML代码,然后从上到下依次加载<img src="xxx"> ...
- Python爬虫之图片懒加载技术、selenium和PhantomJS
一.引入 2.概要 图片懒加载 selenium phantomJs 谷歌无头浏览器 3.回顾 验证码处理流程 一.今日详情 动态数据加载处理 1.图片懒加载 什么是图片懒加载? 案例分析:抓取站长素 ...
- 爬虫(七)图片懒加载技术、selenium和PhantomJS
动态数据加载处理 一.图片懒加载 什么是图片懒加载? 案例分析:抓取站长素材http://sc.chinaz.com/中的图片数据 #!/usr/bin/env python # -*- coding ...
- 爬虫之 图片懒加载, selenium , phantomJs, 谷歌无头浏览器
一.图片懒加载 懒加载 : JS 代码 是页面自然滚动 window.scrollTo(0,document.body.scrollHeight) (重点) bro.execute_ ...
- 爬虫之图片懒加载技术、selenium和PhantomJS
爬虫之图片懒加载技术.selenium和PhantomJS 图片懒加载 selenium phantomJs 谷歌无头浏览器 一.图片懒加载 什么是图片懒加载? 案例分析:抓取站长素材http:/ ...
- 爬虫之图片懒加载技术、selenium工具与PhantomJS无头浏览器
图片懒加载技术 selenium爬虫简单使用 2.1 selenium简介 2.2 selenium安装 2.3 selenium简单使用 2.3.1 selenium使用案例 2.3.2 selen ...
- 爬虫之图片懒加载技术及js加密
图片懒加载 图片懒加载概念: 图片懒加载是一种网页优化技术.图片作为一种网络资源,在被请求时也与普通静态资源一样,将占用网络资源,而一次性将整个页面的所有图片加载完,将大大增加页面的首屏加载时间.为了 ...
随机推荐
- bash6——循环
for fruit in apple orange pear #写死 do each ${fruit}s done fruits="apple orange pear" #输入变量 ...
- shell脚本3——调试
bash -x file.sh 这样会把执行到的语句全部打印出来 #!/bin/bash 不会打印的程序块 set -v 需要打印的程序块 set -v 不会打印的程序块
- C++学习第一天(打卡)
C++和C最大的区别可能就是添加了面向对象的编程. using namespace std 是其中oop的一个特性. using namespace std 可以使程序使用std名称空间里面的定义. ...
- Log4net 使用汇总(网络收集整理)
原帖1:http://blog.csdn.net/wanzhuan2010/article/details/7587780 原帖2:http://grim1980.blog.sohu.com/2555 ...
- Dockerfile构建私有镜像
构建第一个镜像 镜像的定制实际上就是定制每一层所添加的配置,文件.我们可以把每一层修改,安装,构建,操作的命令都写入一个脚本,这个脚本就是Dockerfile.Dockerfile是一个文本文件,其内 ...
- vsftpd架设(配置pam模块)
Vsftpd 是很安全的ftp软件 VSFTPD的目录结构 /usr/sbin/vsftpd: VSFTPD的可执行文件 /etc/rc.d/init.d/vsftpd:启动脚本 /etc/vsftp ...
- java 小程序分析:参数传递
public class Test{ public static void main (String [] ABC){ StringBuffer a = new StringBuffer(" ...
- diff()函数的使用
1.diff():返回略微迭代(lagged)的或滞后的不同(iterated diferences). > x<-cumsum(cumsum(1:10)) > x [1] 1 4 ...
- CSS 使用id属性的规则
html中的id属性是什么?本篇文章给大家带来的内容是介绍html中的id属性,让大家了解id属性的使用方法,希望对大家有所帮助. html的id属性是什么? html的id属性其实就是一个HTML元 ...
- for源码实现
for源码实现 我们知道,java的while和for基本上是实现一样的功能,这样会不会有一点缺点,同时java的迭代器显得尤为的麻烦. python的for和while就不同了,在实现迭代的功能的情 ...