
强化学习算法DQN
1 DQN的引入
由于q_learning算法是一直更新一张q_table,在场景复杂的情况下,q_table就会大到内存处理的极限,而且在当时深度学习的火热,有人就会想到能不能将从深度学习中借鉴方法,将深度学习的方法应用到强化学习中。13年,谷歌的deepmind团队就发表了关于DQN算法的论文,促进了强化学习的发展,扩展了强化学习的应用场景。
2 将深度学习应用到强化学习的挑战
将深度学习应用到强化学习上主要有两大挑战,下面具体说明这两种挑战是什么
2.1 第一个挑战是关于样本的分布:
深度学习能够收敛的一大主要原因就是数据集要求独立同分布,只有数据集独立同分布,运用深度学习训练出来的模型才能更好的拟合数据集中潜在的模型,才能得到理想的结果。但是强化学习是从reward中学习,从一系列高度相关的状态中学习,而且强化学习中的智能体随着算法学习到新的行为,数据分布可能会发生改变,存在不能收敛的结果。想要将深度学习算法应用到强化学习中就必须解决强化学习的问题,切断状态的相关性,使数据集的分布稳定。
2.2 第二个挑战是关于学习的方式:
深度学习是标准的监督式学习,在训练之前,想要训练得到的理想模型的目标就已经暗中存在,深度学习通过一次次的迭代,使算法收敛,寻到理想的模型。然而强化学习是从稀疏,有噪声,有延迟的标量的奖励信号中学习,想要将深度学习的算法应用用强化学习中就必须为强化学习设计每一步更新迭代的目标。
3 关于上述挑战的两个解决办法
3.1 解决样本分布问题
谷歌deepmind的这篇论文中介绍了一种解决样本分布问题的方法:经验重放机制(repaly mechanism)。
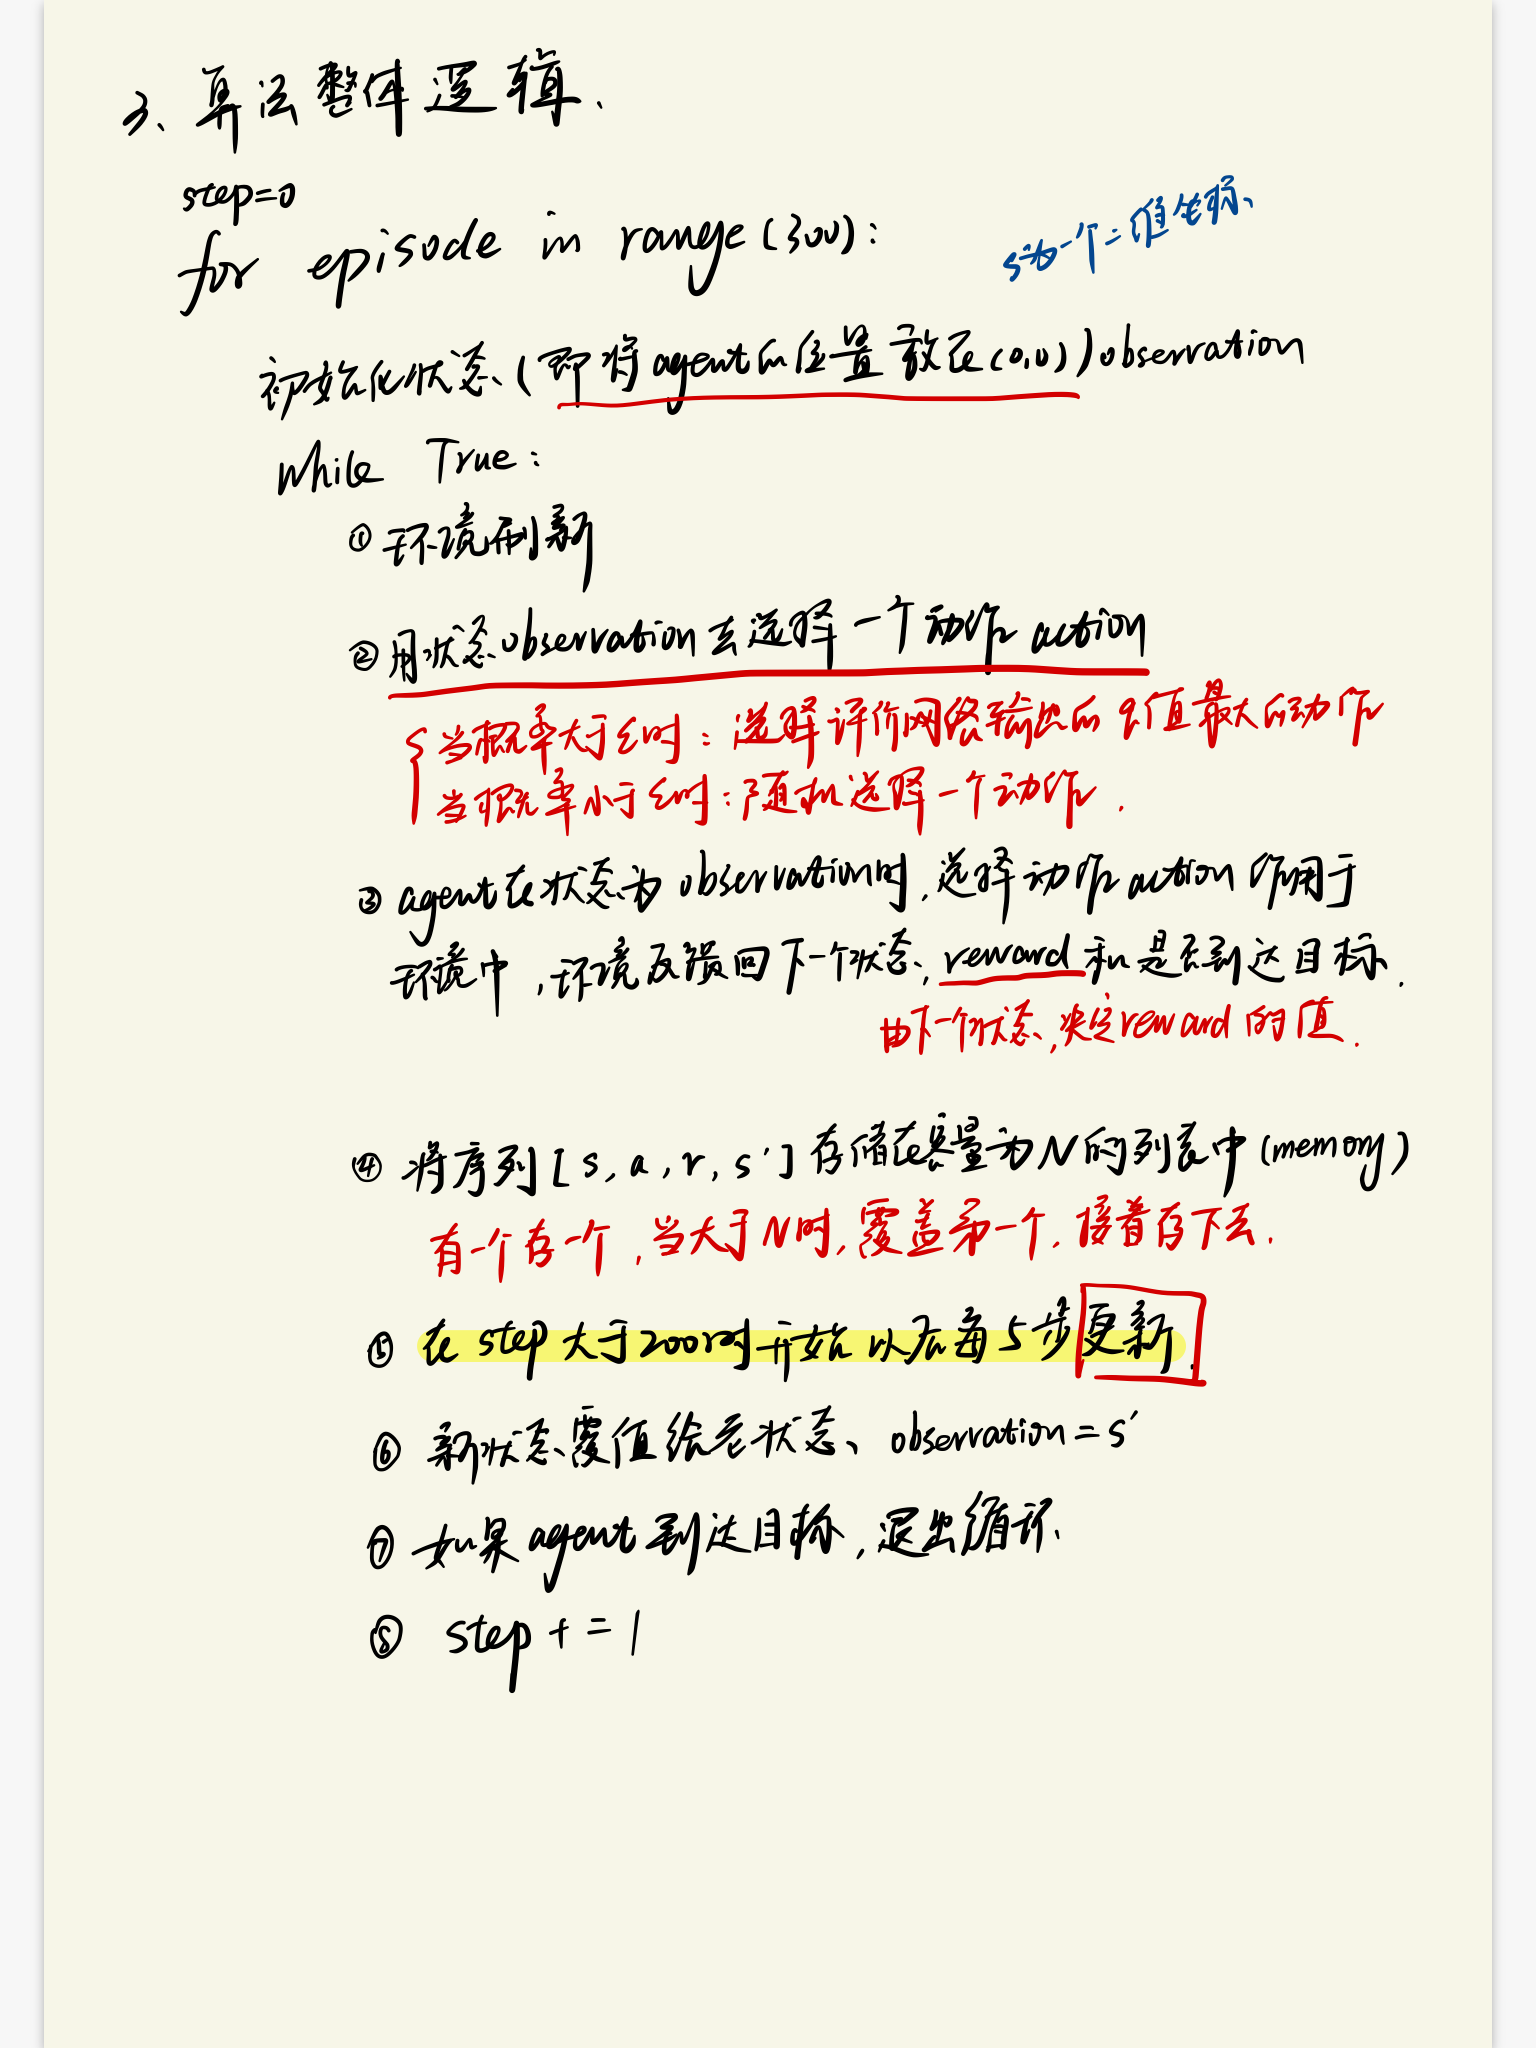
首先agent会被初始化一个状态s,将状态s输入到评价网络中(一个神经网络,后文介绍),输出每个动作的q值,agent通过q值和探索利用(exploration and exploitation)算法来选择在本状态执行的行动action,最后将s,action作用与环境中,环境会反馈给agent此状态执行action的reward和下一个状态s'。此时就到了一个序列(s, a, r, s'),其中s 为本次状态,a 为状态s时的执行的动作,r 为在状态s执行动作a环境反馈给agent的奖赏,s' 是下一个状态。一个序列(s , a, r, s')就构成了一个训练样本。
首先规定经验池的大小为N,即只有N个最新的序列存在经验池中,大于N的序列会重头覆盖经验池中的样本。在每次更新神经网络参数时就用经验池中数据。
经验池的存在,使高度相关的一系列的状态变成了一个个离散的数据样本,减小了训练的方差,同时使样本的分布趋于稳定,有利于算法的收敛,agent还能像人一样,可以从自己的历史经验中学习。
3.2 解决有监督问题
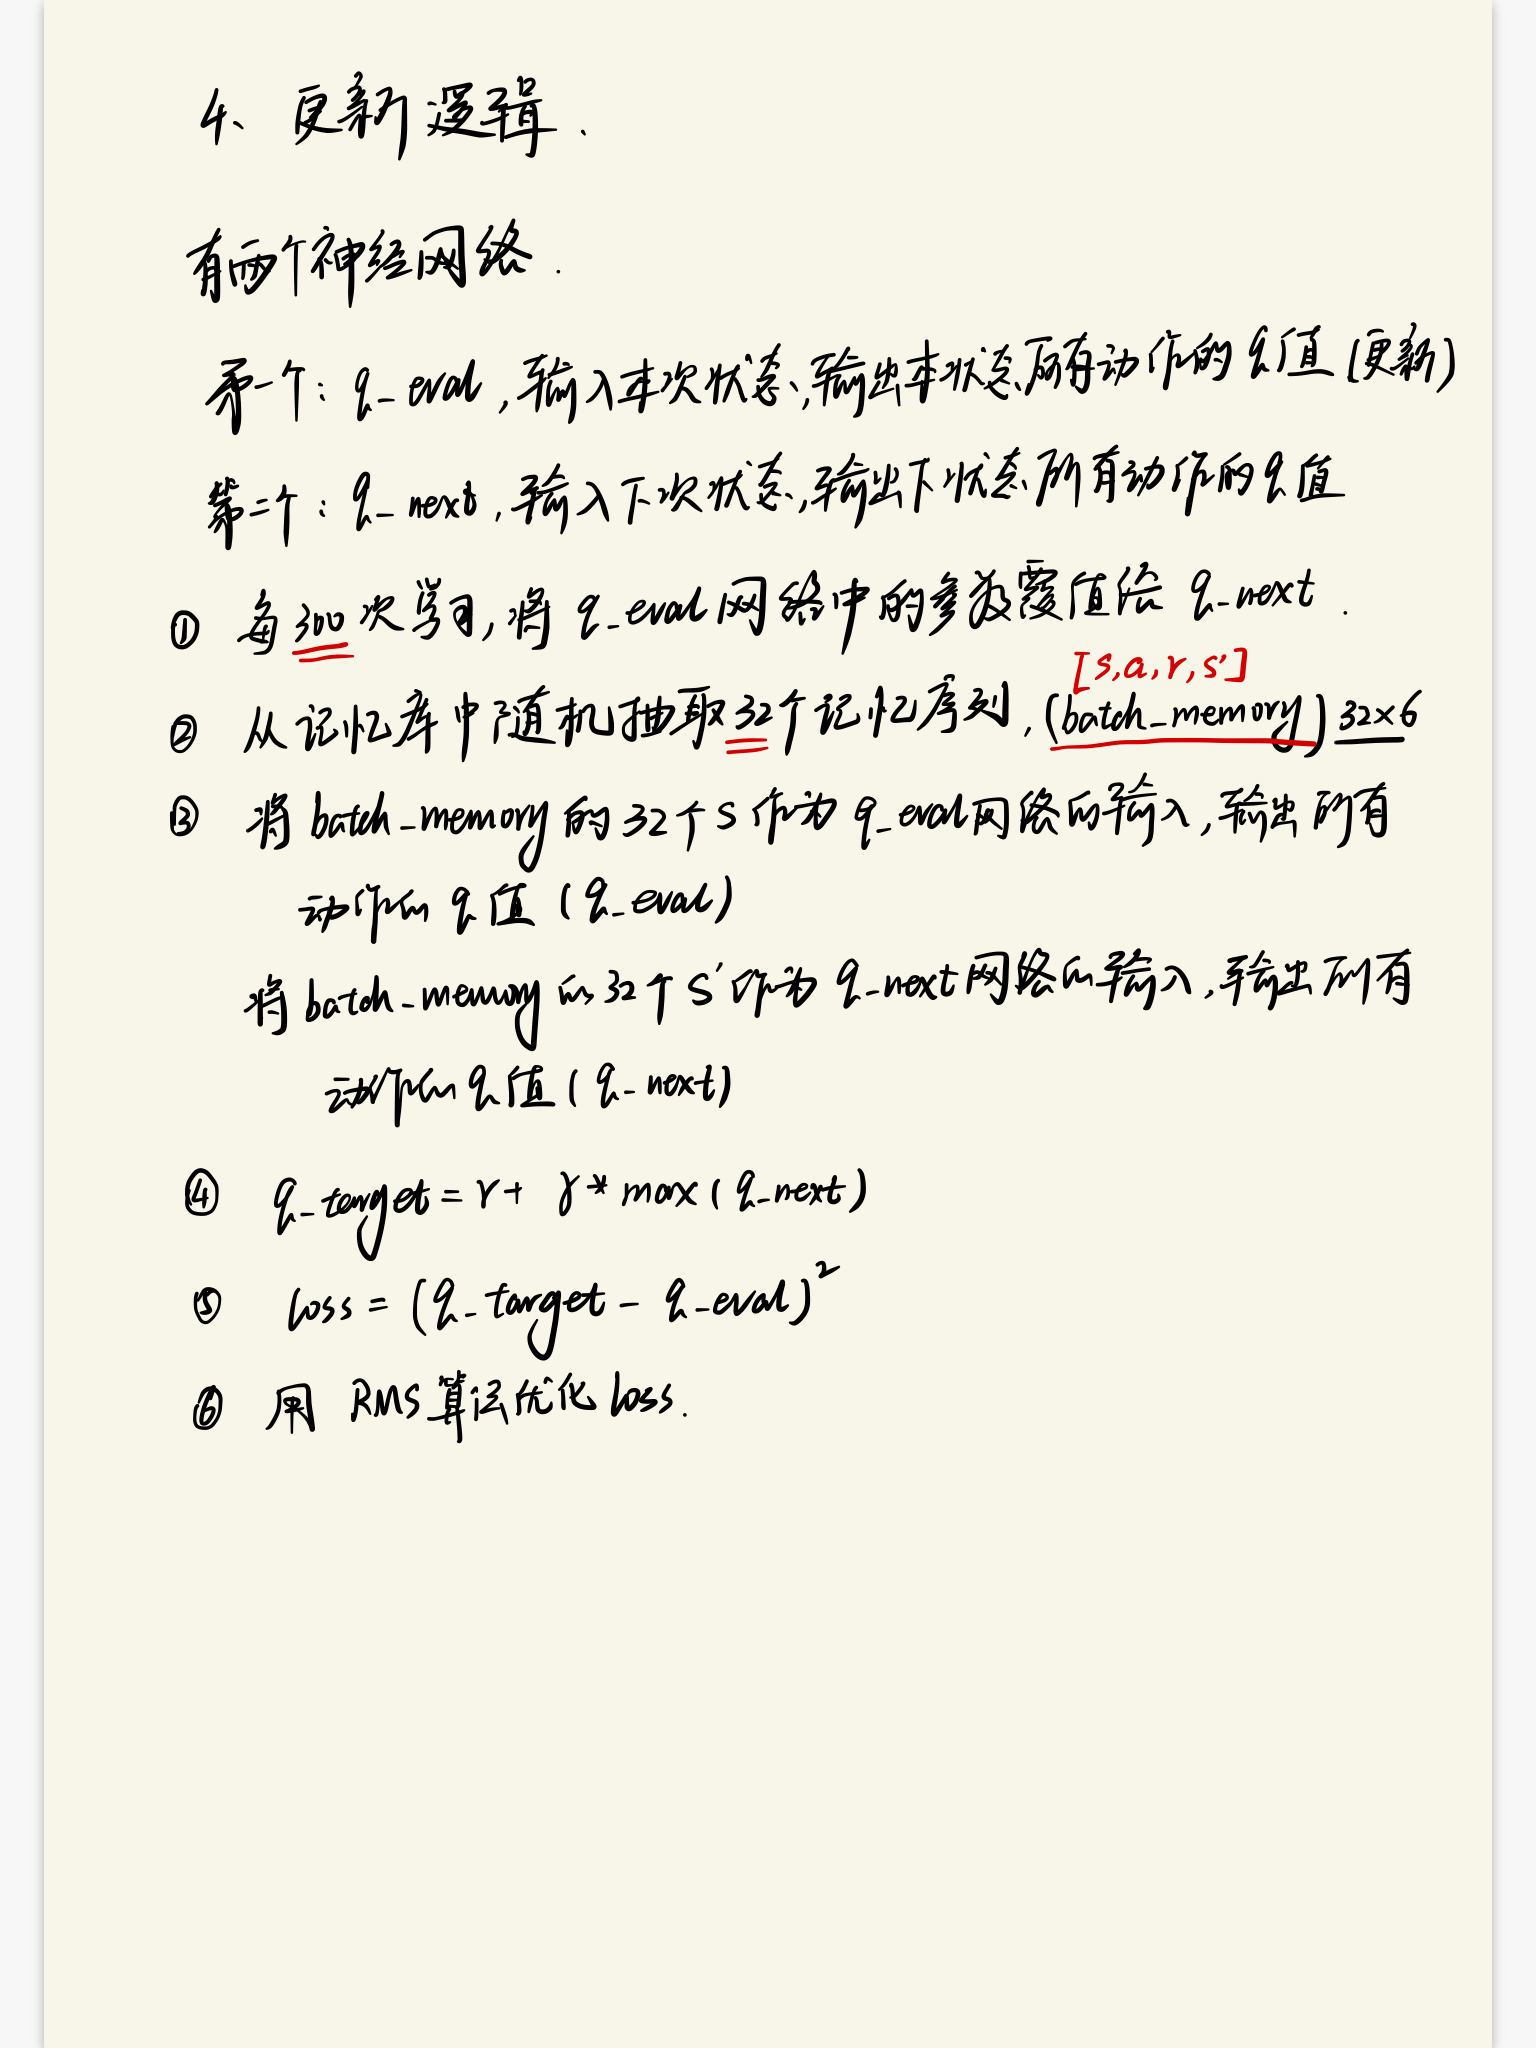
为了解决强化学习和有监督学习的深度学习之间的矛盾,这篇论文中设计了两个神经网络,
一个神经网络为预测网络:输入本次的状态,即样本序列中的第一个元素s,输出每个动作预测的q值,agent就是利用输出的每个动作的q值来决定本状态要执行的动作,本网络的参数随时更新。
另一个网络为评价网络:输入为下一个状态,即样本序列中的第四个元素s',输出为状态s'是每个动作的q值(q_next),然后利用贝尔曼方程(q_target=r+γ*max(q_next))计算出状态s时执行动作a的目标q值。
评价网络的输出经过贝尔曼方程,计算结果的目标q值可作为预测网络的label,这样就解决了有监督的深度学习和没有监督的强化学习之间的矛盾。
为了抑制状态之间相关性的问题,评价网络的参数并不会实时更新,在一定步数之后,预测网络会将自己的参数复制为评价网络。
4 算法流程
4.1 算法的整体逻辑
4.2 算法的学习逻辑
强化学习算法DQN的更多相关文章
- 一文读懂 深度强化学习算法 A3C (Actor-Critic Algorithm)
一文读懂 深度强化学习算法 A3C (Actor-Critic Algorithm) 2017-12-25 16:29:19 对于 A3C 算法感觉自己总是一知半解,现将其梳理一下,记录在此,也 ...
- 【强化学习】DQN 算法改进
DQN 算法改进 (一)Dueling DQN Dueling DQN 是一种基于 DQN 的改进算法.主要突破点:利用模型结构将值函数表示成更加细致的形式,这使得模型能够拥有更好的表现.下面给出公式 ...
- 强化学习算法Policy Gradient
1 算法的优缺点 1.1 优点 在DQN算法中,神经网络输出的是动作的q值,这对于一个agent拥有少数的离散的动作还是可以的.但是如果某个agent的动作是连续的,这无疑对DQN算法是一个巨大的挑战 ...
- 强化学习(十二) Dueling DQN
在强化学习(十一) Prioritized Replay DQN中,我们讨论了对DQN的经验回放池按权重采样来优化DQN算法的方法,本文讨论另一种优化方法,Dueling DQN.本章内容主要参考了I ...
- 强化学习(十七) 基于模型的强化学习与Dyna算法框架
在前面我们讨论了基于价值的强化学习(Value Based RL)和基于策略的强化学习模型(Policy Based RL),本篇我们讨论最后一种强化学习流派,基于模型的强化学习(Model Base ...
- 强化学习Q-Learning算法详解
python风控评分卡建模和风控常识(博客主亲自录制视频教程) https://study.163.com/course/introduction.htm?courseId=1005214003&am ...
- 强化学习(十五) A3C
在强化学习(十四) Actor-Critic中,我们讨论了Actor-Critic的算法流程,但是由于普通的Actor-Critic算法难以收敛,需要一些其他的优化.而Asynchronous Adv ...
- 强化学习(十三) 策略梯度(Policy Gradient)
在前面讲到的DQN系列强化学习算法中,我们主要对价值函数进行了近似表示,基于价值来学习.这种Value Based强化学习方法在很多领域都得到比较好的应用,但是Value Based强化学习方法也有很 ...
- ICML 2018 | 从强化学习到生成模型:40篇值得一读的论文
https://blog.csdn.net/y80gDg1/article/details/81463731 感谢阅读腾讯AI Lab微信号第34篇文章.当地时间 7 月 10-15 日,第 35 届 ...
随机推荐
- 将 SecondaryNameNode 配置到 s105 节点上
相关链接 Hadoop 完全分布式安装 0. 说明 SecondaryNameNode 的作用 参考[待补充] 在 Hadoop 完全分布式的基础之上配置 将 SecondaryNameNode ...
- Shell 脚本合集
0. 说明 Shell 脚本合集 1. xcall.sh xcall.sh 编写为了为了同时对多台服务器进行操作,编写完成之后,将其发送到 /usr/local/bin 下 #!/bin/bash ...
- mysql数据库管理工具(navicat for mysql) 10.1.7 绿色中文版
Navicat for MySQL:Navicat for MySQL 是一套专为 MySQL 设计的高性能数据库管理及开发工具.它可以用于任何版本 3.21 或以上的 MySQL 数据库服务器,并支 ...
- SQL慢查询安装过程
SQL慢查询 基本操作 打开防火墙 firewall-cmd --zone=public --add-port=3306/tcp --permanent firewall-cmd --reload 安 ...
- windows下,怎么轻易拷贝一个文件的完整路径?
1. 到目录下,复制文件 2. win+R ,打开"运行"输入框 3.ctrl+v
- WINDOWS SOCKET编程中accept出来的新连接是阻塞还是非阻塞
实践证明 SOCKET hNewSock=accept(hListenSock) 当hListenSock为阻塞模型时,hNewSock则为阻塞模型 否则 当hListenSock为非阻塞模型时,hN ...
- java使用elasticsearch分组进行聚合查询(group by)-项目中实际应用
java连接elasticsearch 进行聚合查询进行相应操作 一:对单个字段进行分组求和 1.表结构图片: 根据任务id分组,分别统计出每个任务id下有多少个文字标题 .SQL:select id ...
- Angular2学习笔记(1)——Hello World
1. 写在前面 之前基于Electron写过一个Markdown编辑器.就其功能而言,主要功能已经实现,一些小的不影响使用的功能由于时间关系还没有完成:但就代码而言,之前主要使用的是jQuery,由于 ...
- Mapreduce运行过程分析(基于Hadoop2.4)——(二)
4.3 Map类 创建Map类和map函数.map函数是org.apache.hadoop.mapreduce.Mapper类中的定义的,当处理每一个键值对的时候,都要调用一次map方法,用户须 ...
- $Gauss$消元
$Gauss$消元 今天金牌爷来问我一个高消的题目,我才想起来忘了学高消... 高斯消元用于解线性方程组,也就是形如: $\left\{\begin{matrix}a_{11}x_1+a_{12}x_ ...