
hadoop分片分析
上一篇分析了split的生成,现在接着来说具体的split具体内容及其相关的文件和类。以FileSplit(mapred包下org/apache/hadoop/mapreduce/lib/input/FileSplit.java)为例,它继承了InputSplit接口,包括以下属性:
 public class FileSplit extends InputSplit implements Writable {

   private Path file;        //分片对应的文件路径

   private long start;       //分片在文件中的偏移量

   private long length;      //分片长度

   private String[] hosts;   //所在主机列表
其中路径信息file标示了split对应的文件,其格式是这样的:hdfs://localhost:9000/home/hadoop/input/text1.txt。这个可以在debug的时候看的很清楚。另外就是hosts数组,标示了split对应的block所在的主机列表。当然有这么一种情况:就是split可能跨多个block,这时hosts表示的是哪个block所在的主机列表呢?这个问题等以后看到这部分源码的时候再说吧。
JobClient端的submitJobInternal()方法在计划和划分split的同时,生成了两个文件:job.split和job.splitmetainfo,将其放在HDFS的${mapreduce.jobtracker.staging.root.dir}/${user}/.staging/${JobId}目录下。他们的作用分别为:
job.split:表示原始分片信息,Map task初始化时使用,用以获取要处理的数据。
job.splitmetainfo:表示分片元信息, JobTracker用来构造locality的task。
下面着重解析下这两个文件:
job.split文件:
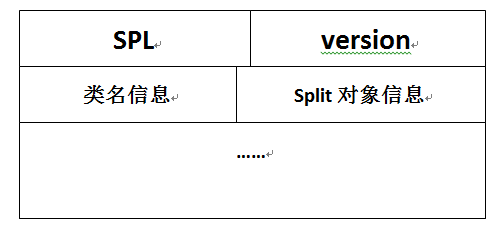
SPL :job.split文件头
version:版本信息,为1,int类型
类名信息:
类名长度:int类型,表示其后的类名由多少个字符组成(47)
类名:org.apache.hadoop.mapreduce.lib.input.FileSplit(共47个字符)
对象信息:
长度:int类型,表示其后的文件名信息由多少字符组成(49)
文件名:hdfs://localhost:9000/home/hadoop/input/text1.txt(共49个字符)
start:Long类型,表示该split的偏移量,
length:Long类型,表示分片长度
然后就是类名信息和对象信息作为一个条目,如此一直重复下去。要注意一点:图中的的边界并不一定是对齐的。
Job.splitmetainfo文件:
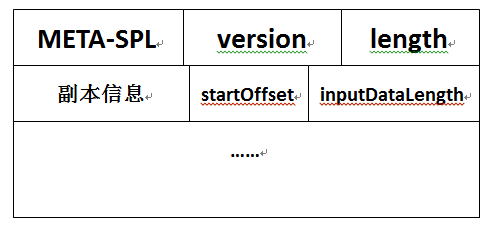
META-SPL :Job.splitmetainfo文件头
version:版本信息,为1,int类型
length:split的数目,int类型
副本信息:
副本个数:int类型
主机信息:int(表示主机名的长度),byte[](用来存储主机名) (如:8:gouyk-pc)
…… (以上边的形式重复写,因为会有多个split)
startOffset:split在job.split中的偏移量,Long
inputDataLength:分片长度, Long
然后就是副本信息和startOffset、inputDataLength作为一个条目,如此一直重复下去。同样,图中的的边界并不一定是对齐的。
下面说说关于读写split的基础类:SplitMetaInfo、TaskSplitMetaInfo和TaskSplitIndex,它们都封装在JobSplit类中。
SplitMetaInfo类代表了split的元数据信息,在生成job.split文件时被构造出来。主要属性如下:
  public static class SplitMetaInfo implements Writable {

     private long startOffset;        //该split元信息在job.split文件中的偏移量

     private long inputDataLength;    //该split的数据长度

     private String[] locations;      //该split对应的host列表
TaskSplitMetaInfo类代表了Map Task要处理的split的元信息,在JobTracker端初始化Job时读取job.splitmetainfo文件后被构造出来。并将其存入到Map Task(TaskInProgress)中。在TaskTracker端,Map Task根据TaskSplitMetaInfo从job.split文件中读取split信息。主要属性如下:
  public static class TaskSplitMetaInfo {

     private TaskSplitIndex splitIndex;   //split元信息在job.split文件中的索引

     private long inputDataLength;        //split的数据长度

     private String[] locations;          //split对应的host列表
TaskSplitIndex用于指定split在job.split中的位置。主要属性如下:
   public static class TaskSplitIndex {

     private String splitLocation;    //job.split文件所在的位置

     private long startOffset;        //split在job.split文件中的索引
本文基于hadoop1.2.1
如有错误,还请指正
参考文章:《Hadoop技术内幕 深入理解MapReduce架构设计与实现原理》 董西成
http://blog.sina.com.cn/s/blog_9d31d3870101dtx8.html
转载请注明出处:http://www.cnblogs.com/gwgyk/p/4123414.html
hadoop分片分析的更多相关文章
- Hadoop源代码分析
http://wenku.baidu.com/link?url=R-QoZXhc918qoO0BX6eXI9_uPU75whF62vFFUBIR-7c5XAYUVxDRX5Rs6QZR9hrBnUdM ...
- Hadoop日志分析系统启动脚本
Hadoop日志分析系统启动脚本 #!/bin/bash #Flume日志数据的根文件夹 root_path=/flume #Mapreduce处理后的数据文件夹 process_path=/proc ...
- Hadoop源代码分析(完整版)
Hadoop源代码分析(一) 关键字: 分布式云计算 Google的核心竞争技术是它的计算平台.Google的大牛们用了下面5篇文章,介绍了它们的计算设施. GoogleCluster:http:// ...
- 使用hadoop mapreduce分析mongodb数据
使用hadoop mapreduce分析mongodb数据 (现在很多互联网爬虫将数据存入mongdb中,所以研究了一下,写此文档) 版权声明:本文为yunshuxueyuan原创文章.如需转载请标明 ...
- hadoop 分片与分块,map task和reduce task的理解
分块:Block HDFS存储系统中,引入了文件系统的分块概念(block),块是存储的最小单位,HDFS定义其大小为64MB.与单磁盘文件系统相似,存储在 HDFS上的文件均存储为多个块,不同的是, ...
- hadoop 日志分析
1:在每一个tomcat服务器上,生成的日志目录中,在java中用定时器每天将当天的日志上传到hadoop中 (技术要点:quatz+hadoop-client)具体的目录动态的采用时间品名 2:ha ...
- Hadoop源代码分析【IO专题】
由于Hadoop的MapReduce和HDFS都有通信的需求,需要对通信的对象进行序列化.Hadoop并没有采用Java的序列化(因为Java序列化比较复杂,且不能深度控制),而是引入了它自己的系统. ...
- Hadoop学习之Hadoop案例分析
一.日志数据分析1.背景1.1 ***论坛日志,数据分为两部分组成,原来是一个大文件,是56GB:以后每天生成一个文件,大约是150-200MB之间: 每行记录有5部分组成:1.访问ip:2.访问时间 ...
- hadoop日志分析
一.项目要求 本文讨论的日志处理方法中的日志,仅指Web日志.事实上并没有精确的定义,可能包含但不限于各种前端Webserver--apache.lighttpd.nginx.tomcat等产生的用户 ...
随机推荐
- Jboss配置之数据源密码配置密文--EncryptingDataSourcePasswords
local-tx-datasource:最常用的数据源配置,该连接池的连接管理器是LocalTxConnectionManager,只支持本地事务,不适合做分布式事务.以mssql为例如下:如果密码按 ...
- Openstack+Kubernetes+Docker微服务实践之路--弹性扩容
服务上线就要顶的住压力.扛的住考验,不然挨说的还是我们这帮做事的兄弟,还记得上图这个场景吗 老办法是服务集群部署,但总归有个上限,之前跟阿里合作的时候他们有个弹性计算可以通过设置CPU的阀值来动态扩展 ...
- iphone中 input圆角bug
今天写了个简单的登录注册,在电脑手机(除了iphone)样式都没有问题,但在iphone中却出现了异常,提交的按钮变成圆角被背景渐变的效果,随后又测试两个iphone版都是一个样,断定应该是safar ...
- TLD目标跟踪算法
1. 简介 TLD目标跟踪算法是Tracking-Learning-Detection算法的简称.这个视频跟踪算法框架由英国萨里大学的一个捷克籍博士生Zdenek Kalal提出.TLD将传统的视频跟 ...
- ASP.NET MVC Jquery Validate 表单验证的多种方式
在我们日常开发过程中,前端的表单验证很重要,如果这块处理不当,会出现很多bug .但是如果处理的好,不仅bug会很少,用户体验也会得到很大的提升.在开发过程中我们可以不借助 JS 库,自己去手写 JS ...
- [git] git代理及常用命令,远程桌面代理
1.代理 公司只能内网,上外网只能用代理,坑货! 2. 更新代码命令 1)下载代码:git clone ------------ 2) 指定目录: cd 文件名 3)git add ...
- 生成yyMMddHHmmssSS时间戳代码作为唯一主键值
import java.sql.Time; import java.text.DateFormat; import java.text.ParseException; import java.text ...
- 转:OSGi 入门篇:生命周期层
OSGi 入门篇:生命周期层 前言 生命周期层在OSGi框架中属于模块层上面的一层,它的运作是建立在模块层的功能之上的.生命周期层一个主要的功能就是让你能够从外部管理应用或者建立能够自我管理的应用(或 ...
- 【java基础】面向对象的三大特征---多态
java的引用变量有两种类型,编译时类型和运行时类型,如果编译时类型和运行时类型不一致,就会出现多态. 多态分为: 运行时多态 java运行时系统根据调用该方法的实例的类型来决定选择调用哪个方法则被称 ...
- JavaScript获取浏览器类型与版本
从网上找到一段使用JavaScript判断浏览器以及浏览器版本的比较好的代码,在此记录一下: <script type="text/javascript"> var S ...