
5、爬虫之scrapy框架
一 scrapy框架简介
1 介绍
Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速、简单、可扩展的方式从网站中提取所需的数据。但目前Scrapy的用途十分广泛,可用于如数据挖掘、监测和自动化测试等领域,也可以应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫。Scrapy 是基于twisted框架开发而来,twisted是一个流行的事件驱动的python网络框架。因此Scrapy使用了一种非阻塞(又名异步)的代码来实现并发。
整体架构大致如下:
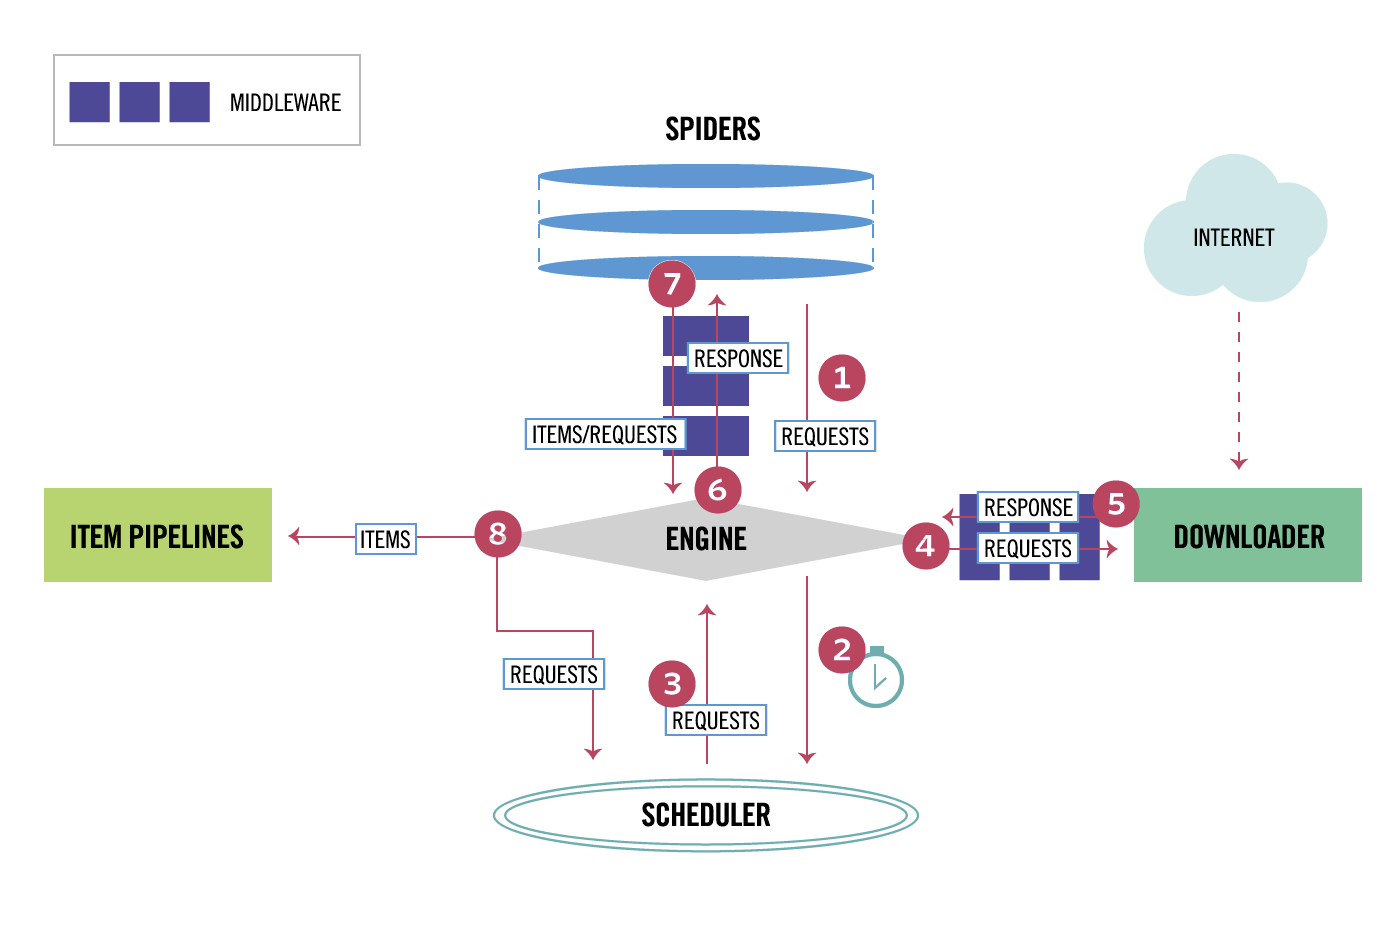
Components:
1、引擎(EGINE)
引擎负责控制系统所有组件之间的数据流,并在某些动作发生时触发事件。有关详细信息,请参见上面的数据流部分。
2、调度器(SCHEDULER)
用来接受引擎发过来的请求, 压入队列中, 并在引擎再次请求的时候返回. 可以想像成一个URL的优先级队列, 由它来决定下一个要抓取的网址是什么, 同时去除重复的网址
3、下载器(DOWLOADER)
用于下载网页内容, 并将网页内容返回给EGINE,下载器是建立在twisted这个高效的异步模型上的
4、爬虫(SPIDERS)
SPIDERS是开发人员自定义的类,用来解析responses,并且提取items,或者发送新的请求
5、项目管道(ITEM PIPLINES)
在items被提取后负责处理它们,主要包括清理、验证、持久化(比如存到数据库)等操作
下载器中间件(Downloader Middlewares)位于Scrapy引擎和下载器之间,主要用来处理从EGINE传到DOWLOADER的请求request,已经从DOWNLOADER传到EGINE的响应response,
你可用该中间件做以下几件事:
(1) process a request just before it is sent to the Downloader (i.e. right before Scrapy sends the request to the website);
(2) change received response before passing it to a spider;
(3) send a new Request instead of passing received response to a spider;
(4) pass response to a spider without fetching a web page;
(5) silently drop some requests.
6、爬虫中间件(Spider Middlewares)
位于EGINE和SPIDERS之间,主要工作是处理SPIDERS的输入(即responses)和输出(即requests)
下载
#Linux:

              pip3 install scrapy

#Windows:

              a. pip3 install wheel

              b. 下载twisted http://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted

              c. 进入下载目录,执行 pip3 install Twisted‑17.1.0‑cp35‑cp35m‑win_amd64.whl

              d. pip3 install pywin32
5、爬虫之scrapy框架的更多相关文章
- Python网络爬虫之Scrapy框架(CrawlSpider)
目录 Python网络爬虫之Scrapy框架(CrawlSpider) CrawlSpider使用 爬取糗事百科糗图板块的所有页码数据 Python网络爬虫之Scrapy框架(CrawlSpider) ...
- 爬虫06 /scrapy框架
爬虫06 /scrapy框架 目录 爬虫06 /scrapy框架 1. scrapy概述/安装 2. 基本使用 1. 创建工程 2. 数据分析 3. 持久化存储 3. 全栈数据的爬取 4. 五大核心组 ...
- Python逆向爬虫之scrapy框架,非常详细
爬虫系列目录 目录 Python逆向爬虫之scrapy框架,非常详细 一.爬虫入门 1.1 定义需求 1.2 需求分析 1.2.1 下载某个页面上所有的图片 1.2.2 分页 1.2.3 进行下载图片 ...
- 爬虫之scrapy框架
解析 Scrapy解释 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓 ...
- Python爬虫进阶(Scrapy框架爬虫)
准备工作: 配置环境问题什么的我昨天已经写了,那么今天直接安装三个库 首先第一步: ...
- 爬虫之Scrapy框架介绍
Scrapy介绍 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页内 ...
- 16.Python网络爬虫之Scrapy框架(CrawlSpider)
引入 提问:如果想要通过爬虫程序去爬取”糗百“全站数据新闻数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模块递归回调parse方法). 方法 ...
- python爬虫随笔-scrapy框架(1)——scrapy框架的安装和结构介绍
scrapy框架简介 Scrapy,Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试 ...
- Python学习---爬虫学习[scrapy框架初识]
Scrapy Scrapy是一个框架,可以帮助我们进行创建项目,运行项目,可以帮我们下载,解析网页,同时支持cookies和自定义其他功能. Scrapy是一个为了爬取网站数据,提取结构性数据而编写的 ...
随机推荐
- 关于springmvc json交互产生的406错误
产生错误的背景:springmvc使用<mvc:annotation-driven>进行配置,那么只要引入响应的json解析包就可以了.在pom中已经引入了如下: <dependen ...
- Ubuntu中root的默认密码
原文地址:http://www.cnblogs.com/xuyingying/archive/2008/10/16/1312584.html 安装完Ubuntu后忽然意识到没有设 置root密码,不知 ...
- SpringBoot学习(一)—— web项目基础搭建
首先我们在浏览器打开这个网站 https://start.spring.io/ 打开后可以看到以下页面 在这里我们可以快速搭建一个SpringBoot基础项目,填写和选择完相应的信息后,我们点击那个绿 ...
- Python和Java编程题(四)
1.题目:打印出所有的"水仙花数",所谓"水仙花数"是指一个三位数,其各位数字立方和等于该数本身. 分析:只需要对三位数的数字进行循环(100~999),判断三 ...
- MVC分部视图@Html.Partial
加载分布视图的方式: //1.以视图名使用当前文件夹下的视图(如果没有找到,则搜索 Shared 文件夹) @Html.Partial("_test") //加载对应文件 /Vie ...
- scala 基础
1.scala一些预热操作 1.1 to 是一个方法,()可以进行 参数传递,map()把每一个元素取出来进行相应的操作, print(1.to(10).map(_*10)) 结果 Vector ...
- Eclipse快捷键 10个最有用的快捷键(转载收藏)
原文连接:https://www.cnblogs.com/iamfy/archive/2012/07/11/2586869.html Eclipse中10个最有用的快捷键组合 一个Eclipse骨灰级 ...
- What are the differences between a pointer variable and a reference variable in C++?
Question: I know references are syntactic sugar, so code is easier to read and write. But what are t ...
- jQuery:SP.NET Autocomplete Textbox Using jQuery, JSON and AJAX
<%@ Page Language="C#" AutoEventWireup="true" CodeBehind="jQueryAutocomp ...
- AIMLBot (中文自动回复)文本自动回复机器人
https://github.com/chivandikwa/AIMLBot (csharp) https://github.com/gunthercox/ChatterBot (python) ht ...