
请求数据分析 xpath语法 与lxml库
前情提要:
上节学过从网上获取请求,获取返回内容,带理
获取内容之后,第二部就是获取请求的数据分析
一:xpath 语法
浏览器一般会自带xpatn 解析
这里大概讲述一下xpath 的基本操作


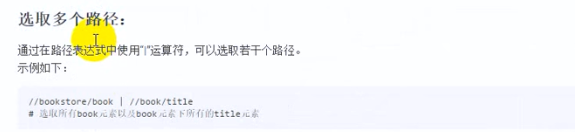

二:式例
我用的是360 浏览器...(..用了好多年了..习惯了..)
我们拿笔趣阁进行测试
https://www.biquge5200.cc/46_46254/
1>进入开发者模式
2>写xpath

>2.1
// 获取子孙节点
div div 节点
// 获取上一层下的子孙节点
dl dl 节点
// 获取上一层下的子孙节点
dd dd节点
[position()] 节点内的位置
> 比较运算符
9 第九个节点
三: lxml 解析器

# 本地使用

# from lxml import etree

# htmlElent =etree.HTML(text)

# print(type(htmlElent))  #html对象

# print(etree.tostring(htmlElent,encoding='utf-8').decode('utf-8'))

# etree.tostring 规范化并补全

#读取文件中的html

# from lxml import etree

# parser =etree.HTMLParser(encodeing=('utf-8'))  #定义解析器

# #解析器作用 补全html 和规范html

# htmlElent =etree.parse("lagou.html",parser=parser)

# # 读取本地html 文件. 传入解析器

# print(etree.tostring(htmlElent,encoding='utf-8').decode('utf-8'))
请求数据分析 xpath语法 与lxml库的更多相关文章
- 12.Python爬虫利器三之Xpath语法与lxml库的用法
LXML解析库使用的是Xpath语法: XPath 是一门语言 XPath可以在XML文档中查找信息 XPath支持HTML XPath通过元素和属性进行导航 XPath可以用来提取信息 XPath比 ...
- Python爬虫利器三之Xpath语法与lxml库的用法
前面我们介绍了 BeautifulSoup 的用法,这个已经是非常强大的库了,不过还有一些比较流行的解析库,例如 lxml,使用的是 Xpath 语法,同样是效率比较高的解析方法.如果大家对 Beau ...
- 芝麻HTTP:Python爬虫利器之Xpath语法与lxml库的用法
安装 pip install lxml 利用 pip 安装即可 XPath语法 XPath 是一门在 XML 文档中查找信息的语言.XPath 可用来在 XML 文档中对元素和属性进行遍历.XPat ...
- Xpath语法与lxml库的用法
BeautifulSoup 已经是非常强大的库了,不过还有一些比较流行的解析库,例如 lxml,使用的是 Xpath 语法,同样是效率比较高的解析方法. 1.安装 pip install lxml 2 ...
- python爬虫(8)--Xpath语法与lxml库
1.XPath语法 XPath 是一门在 XML 文档中查找信息的语言.XPath 可用来在 XML 文档中对元素和属性进行遍历.XPath 是 W3C XSLT 标准的主要元素,并且 XQuery ...
- Xpath语法与lxml库
1. Xpath 1 )什么是XPath? xpath(XML Path Language)是一门在XML和HTML文档中查找信息的语言,可用来在XML和HTML文档中对元素和属性进行遍历. 2) X ...
- xpath教程 2 - lxml库
xpath教程 2 - lxml库 这些就是XPath的语法内容,在运用到Python抓取时要先转换为xml. lxml库 lxml 是 一个HTML/XML的解析器,主要的功能是如何解析和提取 HT ...
- Python爬虫11-XML与XPath概述及lxml库的应用
GitHub代码练习地址:用lxml解析HTML,文件读取,etree和XPath的配合使用:https://github.com/Neo-ML/PythonPractice/blob/master/ ...
- python爬虫之路——初识lxml库和xpath语法
lxml库:是xml解析库,也支持html文档解析功能,实用功能:自动修正补全html代码. 使用流程:①导入lxml中的etree库,②利用etree.HTML(文件名)或etree.parse(本 ...
随机推荐
- msys2 启用windows PATH环境变量
有三种方法修改 ①msys2_shell.cmd 中取消一行的注释:set MSYS2_PATH_TYPE=inherit ②调用msys2_shell.cmd时使用-use-full-path参数 ...
- 关于对象的 width offsetwidth availWidth scrollHeight
别人总结的.自己记不住,所以留着 了 offsetWidth 包含了对象的边线的宽度width 若你不在html 代码里明确指定这个值,那它的返回值会不一样,如果设置了width 则一样. widht ...
- 替换SQL执行计划
Switching two different SQL Plan with SQL Profile in Oracle... 当SQL是业务系统动态生成的,或者是第三方系统产生的,在数据库层面分析发现 ...
- 2018.10.23 bzoj1297: [SCOI2009]迷路(矩阵快速幂优化dp)
传送门 矩阵快速幂优化dp简单题. 考虑状态转移方程: f[time][u]=∑f[time−1][v]f[time][u]=\sum f[time-1][v]f[time][u]=∑f[time−1 ...
- 2018.09.25 poj2068 Nim(博弈论+dp)
传送门 题意简述:m个石子,有两个队每队n个人循环取,每个人每次取石子有数量限制,取最后一块的输,问先手能否获胜. 博弈论+dp. 我们令f[i][j]f[i][j]f[i][j]表示当前第i个人取石 ...
- memmove、memcpy、strcpy、memset的实现
memmove.memcpy.strcpy.memset 原型为: void *memmove( void* dest, const void* src, size_t count ); char* ...
- LA 3942 && UVa 1401 Remember the Word (Trie + DP)
题意:给你一个由s个不同单词组成的字典和一个长字符串L,让你把这个长字符串分解成若干个单词连接(单词是可以重复使用的),求有多少种.(算法入门训练指南-P209) 析:我个去,一看这不是一个DP吗?刚 ...
- 事务不起作用 Closing non transactional SqlSession
In proxy mode (which is the default), only external method calls coming in through the proxy are int ...
- C/C++的Name Mangling
C语言 函数 1.void __CALLTYPE f();2.int __CALLTYPE f();3.int __CALLTYPE f(int);4.double __CALLTYPE f(int, ...
- struts2从浅至深(四)下载文件
1.创建下载文件动作类 2.配置struts 3.提供一个下载链接 4.下载页面 为什么文件名是链接名 只是以链接名显示,但文件的本身是个图片秩序改掉后缀名就可以了