
xpath教程 2 - lxml库
xpath教程 2 - lxml库
这些就是XPath的语法内容,在运用到Python抓取时要先转换为xml。
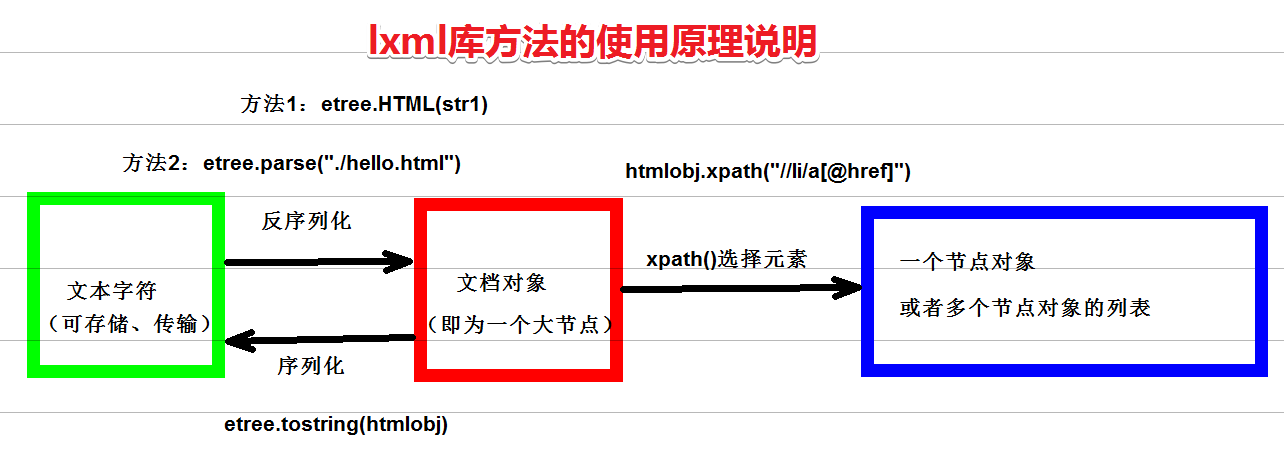
lxml库
lxml 是 一个HTML/XML的解析器,主要的功能是如何解析和提取 HTML/XML 数据。
lxml和正则一样,也是用 C 实现的,是一款高性能的 Python HTML/XML 解析器,我们可以利用之前学习的XPath语法,来快速的定位特定元素以及节点信息。
lxml python 官方文档:http://lxml.de/index.html
需要安装C语言库,可使用 pip 安装:
pip install lxml(或通过wheel方式安装)
初步使用
我们利用它来解析 HTML 代码,简单示例:
# lxml_test.py

# 使用 lxml 的 etree 库

from lxml import etree

text = '''

<div>

    <ul>

         <li class="item-0"><a href="link1.html">first item</a></li>

         <li class="item-1"><a href="link2.html">second item</a></li>

         <li class="item-inactive"><a href="link3.html">third item</a></li>

         <li class="item-1"><a href="link4.html">fourth item</a></li>

         <li class="item-0"><a href="link5.html">fifth item</a> # 注意,此处缺少一个 </li> 闭合标签

     </ul>

 </div>

'''

#利用etree.HTML,将字符串解析为HTML文档

html = etree.HTML(text)

# 按字符串序列化HTML文档

result = etree.tostring(html)

print(result)
输出结果:
<html><body>

<div>

    <ul>

         <li class="item-0"><a href="link1.html">first item</a></li>

         <li class="item-1"><a href="link2.html">second item</a></li>

         <li class="item-inactive"><a href="link3.html">third item</a></li>

         <li class="item-1"><a href="link4.html">fourth item</a></li>

         <li class="item-0"><a href="link5.html">fifth item</a></li>

</ul>

 </div>

</body></html>
lxml 可以自动修正 html 代码,例子里不仅补全了 li 标签,还添加了 body,html 标签。
文件读取:
除了直接读取字符串,lxml还支持从文件里读取内容。我们新建一个hello.html文件:
<!-- hello.html -->

<div>

    <ul>

         <li class="item-0"><a href="link1.html">first item</a></li>

         <li class="item-1"><a href="link2.html">second item</a></li>

         <li class="item-inactive"><a href="link3.html"><span class="bold">third item</span></a></li>

         <li class="item-1"><a href="link4.html">fourth item</a></li>

         <li class="item-0"><a href="link5.html">fifth item</a></li>

     </ul>

 </div>
再利用 etree.parse() 方法来读取文件。
# lxml_parse.py

from lxml import etree

# 读取外部文件 hello.html

html = etree.parse('./hello.html')

result = etree.tostring(html, pretty_print=True)

print(result)
输出结果与之前相同:
<html><body>

<div>

    <ul>

         <li class="item-0"><a href="link1.html">first item</a></li>

         <li class="item-1"><a href="link2.html">second item</a></li>

         <li class="item-inactive"><a href="link3.html">third item</a></li>

         <li class="item-1"><a href="link4.html">fourth item</a></li>

         <li class="item-0"><a href="link5.html">fifth item</a></li>

</ul>

 </div>

</body></html>
XPath实例测试
1. 获取所有的 <li> 标签
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

print type(html)  # 显示etree.parse() 返回类型

result = html.xpath('//li')

print result  # 打印<li>标签的元素集合

print len(result)

print type(result)

print type(result[0])
输出结果:
<type 'lxml.etree._ElementTree'>

[<Element li at 0x1014e0e18>, <Element li at 0x1014e0ef0>, <Element li at 0x1014e0f38>, <Element li at 0x1014e0f80>, <Element li at 0x1014e0fc8>]

5

<type 'list'>

<type 'lxml.etree._Element'>
2. 继续获取<li> 标签的所有 class属性
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

result = html.xpath('//li/@class')

print result
运行结果
['item-0', 'item-1', 'item-inactive', 'item-1', 'item-0']
3. 继续获取<li>标签下hre 为 link1.html 的 <a> 标签
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

result = html.xpath('//li/a[@href="link1.html"]')

print result
运行结果
[<Element a at 0x10ffaae18>]
4. 获取<li> 标签下的所有 <span> 标签
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

#result = html.xpath('//li/span')

#注意这么写是不对的:

#因为 / 是用来获取子元素的,而 <span> 并不是 <li> 的子元素,所以,要用双斜杠

result = html.xpath('//li//span')

print result
运行结果
[<Element span at 0x10d698e18>]
5. 获取 <li> 标签下的<a>标签里的所有 class
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

result = html.xpath('//li/a//@class')

print result
运行结果
['blod']
6. 获取最后一个 <li> 的 <a> 的 href
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

result = html.xpath('//li[last()]/a/@href')

# 谓语 [last()] 可以找到最后一个元素

print result
运行结果
['link5.html']
7. 获取倒数第二个元素的内容
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

result = html.xpath('//li[last()-1]/a')

# text 方法可以获取元素内容

print result[0].text
运行结果
fourth item
8. 获取 class 值为 bold 的标签名
# xpath_li.py

from lxml import etree

html = etree.parse('hello.html')

result = html.xpath('//*[@class="bold"]')

# tag方法可以获取标签名

print result[0].tag
运行结果
spanxpath教程 2 - lxml库的更多相关文章
- 12.Python爬虫利器三之Xpath语法与lxml库的用法
LXML解析库使用的是Xpath语法: XPath 是一门语言 XPath可以在XML文档中查找信息 XPath支持HTML XPath通过元素和属性进行导航 XPath可以用来提取信息 XPath比 ...
- Python爬虫11-XML与XPath概述及lxml库的应用
GitHub代码练习地址:用lxml解析HTML,文件读取,etree和XPath的配合使用:https://github.com/Neo-ML/PythonPractice/blob/master/ ...
- Xpath语法与lxml库
1. Xpath 1 )什么是XPath? xpath(XML Path Language)是一门在XML和HTML文档中查找信息的语言,可用来在XML和HTML文档中对元素和属性进行遍历. 2) X ...
- Python爬虫利器三之Xpath语法与lxml库的用法
前面我们介绍了 BeautifulSoup 的用法,这个已经是非常强大的库了,不过还有一些比较流行的解析库,例如 lxml,使用的是 Xpath 语法,同样是效率比较高的解析方法.如果大家对 Beau ...
- 芝麻HTTP:Python爬虫利器之Xpath语法与lxml库的用法
安装 pip install lxml 利用 pip 安装即可 XPath语法 XPath 是一门在 XML 文档中查找信息的语言.XPath 可用来在 XML 文档中对元素和属性进行遍历.XPat ...
- Xpath语法与lxml库的用法
BeautifulSoup 已经是非常强大的库了,不过还有一些比较流行的解析库,例如 lxml,使用的是 Xpath 语法,同样是效率比较高的解析方法. 1.安装 pip install lxml 2 ...
- python爬虫(8)--Xpath语法与lxml库
1.XPath语法 XPath 是一门在 XML 文档中查找信息的语言.XPath 可用来在 XML 文档中对元素和属性进行遍历.XPath 是 W3C XSLT 标准的主要元素,并且 XQuery ...
- 请求数据分析 xpath语法 与lxml库
前情提要: 上节学过从网上获取请求,获取返回内容,带理 获取内容之后,第二部就是获取请求的数据分析 一:xpath 语法 浏览器一般会自带xpatn 解析 这里大概讲述一下xpath 的基本操作 二: ...
- python爬虫之路——初识lxml库和xpath语法
lxml库:是xml解析库,也支持html文档解析功能,实用功能:自动修正补全html代码. 使用流程:①导入lxml中的etree库,②利用etree.HTML(文件名)或etree.parse(本 ...
随机推荐
- iText7生成pdf
1 官网 http://developers.itextpdf.com/itext-java 2 form中加入表格 http://developers.itextpdf.com/content/be ...
- WP8.1学习系列(第十一章)——中心控件Hub开发指南
在本文中 先决条件 什么是中心控件? 添加中心控件 将分区添加到中心 添加交互式分区头用于导航 将展示磁贴添加到中心 使用窄应用中的垂直中心 借助中心使用语义式缩放视图 摘要和后续步骤 重要的 API ...
- 【Linux】 Centos7 NC探测端口命令
linux centos7 测试端口的连通性, 分别测试TCP端口与UDP端口 1 这个需要Linux服务器里边支持nc命令,检查NC 是否安装 2 安装nc yum install nc - ...
- java基础---->java注解的使用(一)
注解是众多引入到Java SE5中的重要的语言变化之一.它为我们在代码中添加信息提供了一种形式化的方法,使我们可以在稍后某个时刻非常方便的使用这些数据.今天我们就开始学习一下java中注解的知识. j ...
- echarts - 特殊需求实现方案汇总
五分钟上手echarts echarts中 设置x||y轴文案.提示文字等为固定字数,超出显示"..." 关于echarts下钻功能的一些总结.js echarts - 特殊需求实 ...
- MFC控件CTabCtrl关联变量
1.先建立一个对话框MFC应用程序,然后在工具箱里面把Tab Control控件放到对话框中的合适位置上. 再在对话框类中,将该控件绑定一个变量 用两种方法: 1 ) 自己定义成员变量 CTabCtr ...
- sencha touch 常见问题解答(26-50)
26.sencha touch在华为.红米等部分手机下hide事件失效,msgbox无法关闭怎么办 答:请看http://www.cnblogs.com/cjpx00008/p/3535557.htm ...
- C# DataTbale详细操作
1.创建DataTable对象 DataTable dt = new DataTable("Table_AX"); 2.为DataTable创建列 //方式一(我觉得这种好) dt ...
- 23种设计模式之状态模式(State)
状态模式是一种对象的行为型模式,允许一个对象在其内部状态改变时改变它的行为,对象看起来似乎修改了它的类.状态模式封装了状态的转换过程,但是它需要枚举可能的状态,因此,需要事先确定状态种类,这也导致在状 ...
- 优秀的第二外语学习网站:Lang-8
想要找native speaker帮你提高自己的写作能力么? 目前了解到的这方面最好的网站:http://lang-8.com 在这个网站上,你可以随便写一些句子或文章,然后就会有native spe ...