
【转载】漫谈HADOOP HDFS BALANCER
Hadoop的HDFS集群非常容易出现机器与机器之间磁盘利用率不平衡的情况,比如集群中添加新的数据节点。当HDFS出现不平衡状况的时候,将引发很多问题,比如MR程序无法很好地利用本地计算的优势,机器之间无法达到更好的网络带宽使用率,机器磁盘无法利用等等。可见,保证HDFS中的数据平衡是非常重要的。
在Hadoop中,包含一个Balancer程序,通过运行这个程序,可以使得HDFS集群达到一个平衡的状态,使用这个程序的命令如下:
sh $HADOOP_HOME/bin/start-balancer.sh –t 10%
这个命令中-t参数后面跟的是HDFS达到平衡状态的磁盘使用率偏差值。如果机器与机器之间磁盘使用率偏差小于10%,那么我们就认为HDFS集群已经达到了平衡的状态。
Hadoop的开发人员在开发Balancer程序的时候,遵循了以下几点原则:
1. 在执行数据重分布的过程中,必须保证数据不能出现丢失,不能改变数据的备份数,不能改变每一个rack中所具备的block数量。
2. 系统管理员可以通过一条命令启动数据重分布程序或者停止数据重分布程序。
3. Block在移动的过程中,不能暂用过多的资源,如网络带宽。
4. 数据重分布程序在执行的过程中,不能影响name node的正常工作。
基于这些基本点,目前Hadoop数据重分布程序实现的逻辑流程如下图所示:
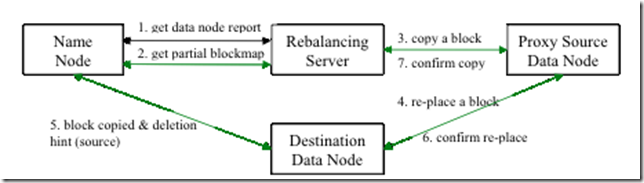
Rebalance程序作为一个独立的进程与name node进行分开执行。
1 Rebalance Server从Name Node中获取所有的Data Node情况:每一个Data Node磁盘使用情况。
2 Rebalance Server计算哪些机器需要将数据移动,哪些机器可以接受移动的数据。并且从Name Node中获取需要移动的数据分布情况。
3 Rebalance Server计算出来可以将哪一台机器的block移动到另一台机器中去。
4,5,6 需要移动block的机器将数据移动的目的机器上去,同时删除自己机器上的block数据。
7 Rebalance Server获取到本次数据移动的执行结果,并继续执行这个过程,一直没有数据可以移动或者HDFS集群以及达到了平衡的标准为止。
Hadoop现有的这种Balancer程序工作的方式在绝大多数情况中都是非常适合的。
现在我们设想这样一种情况:
1 数据是3份备份。
2 HDFS由2个rack组成。
3 2个rack中的机器磁盘配置不同,第一个rack中每一台机器的磁盘空间为1TB,第二个rack中每一台机器的磁盘空间为10TB。
4 现在大多数数据的2份备份都存储在第一个rack中。
在这样的一种情况下,HDFS级群中的数据肯定是不平衡的。现在我们运行Balancer程序,但是会发现运行结束以后,整个HDFS集群中的数据依旧不平衡:rack1中的磁盘剩余空间远远小于rack2。
这是因为Balance程序的开发原则1导致的。
简单的说,就是在执行Balancer程序的时候,不会将数据中一个rack移动到另一个rack中,所以就导致了Balancer程序永远无法平衡HDFS集群的情况。
针对于这种情况,可以采取2中方案:
1 继续使用现有的Balancer程序,但是修改rack中的机器分布。将磁盘空间小的机器分叉到不同的rack中去。
2 修改Balancer程序,允许改变每一个rack中所具备的block数量,将磁盘空间告急的rack中存放的block数量减少,或者将其移动到其他磁盘空间富余的rack中去。
更多关于Hadoop的文章,可以参考:http://www.cnblogs.com/gpcuster/tag/Hadoop/
【转载】漫谈HADOOP HDFS BALANCER的更多相关文章
- 【转】HADOOP HDFS BALANCER介绍及经验总结
转自:http://www.aboutyun.com/thread-7354-1-1.html 集群平衡介绍 Hadoop的HDFS集群非常容易出现机器与机器之间磁盘利用率不平衡的情况,比如集群中添加 ...
- HADOOP HDFS BALANCER介绍及经验总结(转)
1.集群执行balancer命令,依旧不平衡的原因是什么?该如何解决? 2.尽量不在NameNode上执行start-balancer.sh的原因是什么? 集群平衡介绍 Hadoop的HDFS集群非常 ...
- Hadoop记录-HDFS balancer配置
HDFS balancer配置(可通过CM配置)dfs.datanode.balance.max.concurrent.moves 并行移动的block数量,默认5 dfs.datanode.bala ...
- Hadoop HDFS负载均衡
Hadoop HDFS负载均衡 转载请注明出处:http://www.cnblogs.com/BYRans/ Hadoop HDFS Hadoop 分布式文件系统(Hadoop Distributed ...
- Hadoop HDFS 中的一些常用命令
转载自:hadoop HDFS常用文件操作命令 命令基本格式: hadoop fs -cmd < args > 1.ls hadoop fs -ls / 列出hdfs文件系统根目录下的目录 ...
- Hadoop HDFS 用户指南
This document is a starting point for users working with Hadoop Distributed File System (HDFS) eithe ...
- sudo -u hdfs hdfs balancer出现异常 No lease on /system/balancer.id
16/06/02 20:34:05 INFO balancer.Balancer: namenodes = [hdfs://dlhtHadoop101:8022, hdfs://dlhtHadoop1 ...
- hadoop错误FATAL org.apache.hadoop.hdfs.server.namenode.NameNode Exception in namenode join java.io.IOException There appears to be a gap in the edit log
错误: FATAL org.apache.hadoop.hdfs.server.namenode.NameNode Exception in namenode join java.io.IOExcep ...
- Hadoop HDFS分布式文件系统 常用命令汇总
引言:我们维护hadoop系统的时候,必不可少需要对HDFS分布式文件系统做操作,例如拷贝一个文件/目录,查看HDFS文件系统目录下的内容,删除HDFS文件系统中的内容(文件/目录),还有HDFS管理 ...
随机推荐
- Java泛型深入理解
泛型的优点: 泛型的主要优点就是让编译器保留參数的类型信息,执行类型检查,执行类型转换(casting)操作,编译器保证了这些类型转换(casting)的绝对无误. /******* 不使用泛型类型 ...
- ImageLoader配置(凝视)
/** * 配置ImageLoader */ private void configImageLoader() { File discCacheDir = StorageUtils.getOwnCac ...
- 自学Python4.1-文件操作
文件操作 操作文件时,一般需要经历如下步骤: 打开文件 操作文件 关闭文件(非必须) 一.打开文件 open('文件路径', '模式') 打开文件时,需要指定文件路径和以何等方式打开文件,打 ...
- 【java】实例化对象的3种方式:new、clone、反射
实例化对象的3种方式:new.clone.反射
- 637. Average of Levels in Binary Tree
Given a non-empty binary tree, return the average value of the nodes on each level in the form of an ...
- 理解new构造函数和apply以及call
今天在看设计模式的时候,遇到一些挺低级的东西,搞不懂,顾查阅资料整理记录一番. 先了解一下new构造函数的过程: function func(){ console.log('do'); } var f ...
- 7、树莓派编程;gpio编程;led闪烁
本博文仅作本人操作过程的记录,留作备忘.自强不息 QQ12226981 1.树莓派接口对照,一定要找到对应的引脚,不要接错了.我画上箭头. 2.安装 下载地址,https://git.drogon.n ...
- Spring Error : No unique bean of type [org.apache.ibatis.session.SqlSessionFactory] is defined
报错信息: Injection of autowired dependencies failed; nested exception is org.springframework.beans.fa ...
- ELK开机启动 service文件内容
为了实现ELK的3部分开机启动,可以添加各项服务对应的service文件,再通过systemctl enable XXX实现ELK所有服务开机启动. Elasticsearch elasticsear ...
- asp.net mvc ajax提交模型到控制器
http://blog.csdn.net/loongsking/article/details/53224473 function btn_submit() { var data = n ...