
Mapreduce中maptask过程详解
一、Maptask并行度与决定机制
1.一个job任务的map阶段的并行度默认是由该任务的大小决定的;
2.一个split切分分配一个maprask来并行处理;
3.默认情况下,split切分的大小等于blocksize大小;
4.切片不是mapper类中对单词的切片,而是对每一个处理文件的单独切片。
eg. 默认情况下,一个maptask处理的文件大小为128M,比如一个400M的数据文件,就需要4个maptask并行来处理,而500M的数据文件也是需要4个maptask。
二、Maptask运行机制
1.读数据文件:执行类Driver通过InputFormat类读取文件中的数据;
2.mapper阶段:通过文件的大小决定了maptask的数量,然后mapper进行逻辑运行(读数据、切分、封装);
3.OutputCollector阶段:mapper方法通过OutputCollector接口将KV对写入到环形缓冲区中(这个过程不需要我们处理我们);
4.溢写阶段:环形缓冲区默认的大小为100M,当环形缓冲区中数据量到达阈值的80%的时候发生溢写,溢写的过程中会保证数据KV对使用默认的分区和排序(HashPartitioner分区、字典排序,而环形缓冲区大小和阈值的大小都是可以通过配置来修改的);
5.归并排序:将溢写的数据进行合并排序。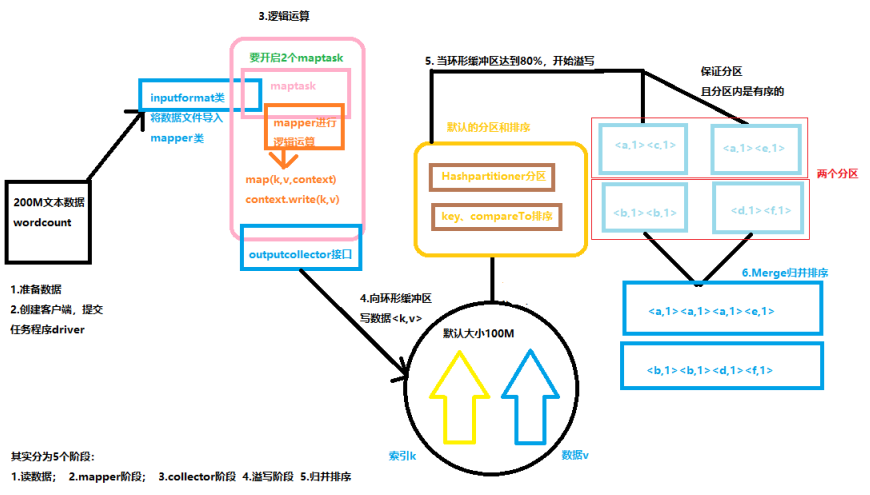
三、MR的小文件优化案例
当许多个小文件上传到HDFS集群上时,每个小文件都将会占用一个blocksize的大小(128M),而且在对它们进行MR计算时,一个文件就会开启一个maptask,这样会浪费很多的资源,下面有两种解决方案:
1.在文件上传到HDFS集群前,先将文件进行合并成一个大的文件,再上传到HDFS集群进行存储和计算;
2.若文件已经上传到HDFS集群,需要直接进行计算时,
可以再Driver类中设置输入流之前设置InputFormatClass属性为CombinerTextInputFormat(它的默认为TextInputFormat),
原理是:CombineTextInputFormat类可以将多个小文件交给一个split切片,然后交给一个maptask来处理,即再Driver类中设置输入流FileInputFormat前加入代码:
job.setInputFormatClass(CombinerTextInputFormat.class);

CombinerTextInputFormat.setMaxInputSplitSize(job,4194304);    //设置切片最大值为4M

CombinerTextInputFormat.setMinInputSplitSize(job,3145725);    //设置切片最大值为3M
表示大小在3M~4M的文件会被方法一个切片中,那么如果有无数的小文件,一个maptask中大概会有28~42个小文件一起处理。
四、自定义分区Partitioner
在MR程序中,默认分区为HashPartitioner,以下为源码:
public class HashPartitioner<K, V> extends Partitioner<K, V> {

    public HashPartitioner() {

    }

    public int getPartition(K key, V value, int numReduceTasks) {

        return (key.hashCode() & 2147483647) % numReduceTasks;

    }

}
HashPartitioner继承了父类Partitioner,其中getPartition方法返回int值0(注释:分区数量决定了reducetask的数量,不分区reducetask值为1,所以一直返回int值0,也就只会产生一个结果文件!!!)
而如果我们想要进行自定义分区,就要重新定义一个分区类继承Partitioner类:
public class FlowPartitioner extends Partitioner<Text,FlowBean> {

    @Override

    public int getPartition(Text key, FlowBean value, int i) {

        //获取用来分区的电话号码前三位

        String phoneNum = key.toString().substring(0, 3);

        //设置分区逻辑

        int partitionNum = 4;

        if ("135".equals(phoneNum)){

            return 0;

        }else if ("137".equals(phoneNum)){

            return 1;

        }else if ("138".equals(phoneNum)){

            return 2;

        }else if ("139".equals(phoneNum)){

            return 3;

        }

        return partitionNum;

    }

}
我在流量统计案例中也写了该分区类,然后再Driver类中的InputFormat类之前加入设置的自定义分区代码:
job.setPartitionClass(PhoneNumPartitioner.class);

job.setNumReduceTasks(5);		(注意:输出文件数量要大于partitioner分区的数量)
总结:MR程序运算过程中,决定maptask个数的有块大小(blocksize)、数据文件大小、文件输入方式(小文件优化);而决定reducetask个数的是分区(无分区时reducetask个数为1,生成一个结果文件)。
Mapreduce中maptask过程详解的更多相关文章
- Android中mesure过程详解
我们在编写layout的xml文件时会碰到layout_width和layout_height两个属性,对于这两个属性我们有三种选择:赋值成具体的数值,match_parent或者wrap_conte ...
- Hadoop学习之路(二十三)MapReduce中的shuffle详解
概述 1.MapReduce 中,mapper 阶段处理的数据如何传递给 reducer 阶段,是 MapReduce 框架中 最关键的一个流程,这个流程就叫 Shuffle 2.Shuffle: 数 ...
- MapReduce的shuffle过程详解
[学习笔记] 结果分析:shuffle的英文是洗牌,混洗的意思,洗牌就是越乱越好的意思.当在集群的情况下是这样的,假如有三个map节点和三个reduce节点,一号reduce节点的数据会来自于三个ma ...
- MapReduce:Shuffle过程详解
1.Map任务处理 1.1 读取HDFS中的文件.每一行解析成一个<k,v>.每一个键值对调用一次map函数. <0,hello you> & ...
- Hadoop Mapreduce的shuffle过程详解
1.map task读取数据时默认调用TextInputFormat的成员RecoreReader,RecoreReader调用自己的read()方法,进行逐行读取,返回一个key.value; 2. ...
- MapReduce过程详解(基于hadoop2.x架构)
本文基于hadoop2.x架构详细描述了mapreduce的执行过程,包括partition,combiner,shuffle等组件以及yarn平台与mapreduce编程模型的关系. mapredu ...
- Hadoop MapReduce执行过程详解(带hadoop例子)
https://my.oschina.net/itblog/blog/275294 摘要: 本文通过一个例子,详细介绍Hadoop 的 MapReduce过程. 分析MapReduce执行过程 Map ...
- Hadoop Mapreduce分区、分组、二次排序过程详解[转]
原文地址:Hadoop Mapreduce分区.分组.二次排序过程详解[转]作者: 徐海蛟 教学用途 1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2) ...
- Hadoop学习之Mapreduce执行过程详解
一.MapReduce执行过程 MapReduce运行时,首先通过Map读取HDFS中的数据,然后经过拆分,将每个文件中的每行数据分拆成键值对,最后输出作为Reduce的输入,大体执行流程如下图所示: ...
随机推荐
- Magento 2 Plugin - Interceptor - Magento 2插件 - 拦截器-插件开发
Magento 2 Plugin - Interceptor - Magento 2插件 - 拦截器 Magento 2 Plugin is a technical plugin for your b ...
- Markdown初入门(使用Typora编辑)
标题 使用#来实现标题的大小控制 # h1 标题1 ## h2 标题2 ### h3 标题3 #### h4 标题4 ##### h5 标题5 ###### h6 标题6 标题一 标题二 标题三 标题 ...
- mysql ssh 跳板机(堡垒机???)连接服务器
跳板机(Jump Server),也称堡垒机,是一类可作为跳板批量操作远程设备的网络设备,是系统管理员或运维人员常用的操作平台之一. 正常的登录流程 使用ssh命令登录跳板机: 登录跳板机成功后,在跳 ...
- 【Noip2015】斗地主
题目 #include<bits/stdc++.h> using namespace std; int pai[20],T; //pai[]统计牌的数量 int n; int ans; v ...
- POJ - 3616 Milking Time (动态规划)
Bessie is such a hard-working cow. In fact, she is so focused on maximizing her productivity that sh ...
- Python判断自定义的参数格式是否正确
import argparse def args_validation(valid_list, valid_value): assert valid_value in valid_list, 'inv ...
- C#图片操作公共库
存一下,以后找起来方便 包括图片加载.压缩.base64等 public static class ImageFun { #region 图片 public static EncoderParamet ...
- JavaScript 的正则也有单行模式了
正则表达式最早是由 Ken Thompson 于 1970 年在他改进过的 QED 编辑器里实现的,正则里最简单的元字符 “.” 在当时所匹配的就是除换行符外的任意字符: "." ...
- VIM --使用进阶 -- 插件篇 -- YouCompleteMe -- nerdtree
系统:ubuntu: 资源:https://github.com/ 其他:想了解都要哪些好用的插件,推荐大家读 http://blog.csdn.net/mergerly/article/detail ...
- Linux负载查询定位工具
1 uptime命令,负载查询命令 02:34:03 // 当前时间up 2 days, 20:14 // 系统运行时间1 user // 正在登录用户数 而最后三个数字呢,依次则是过去 1 分钟.5 ...