
hadoop集群安装_实战
spark1.6.2+ hadoop2.6.2
词频统计完整案例:http://blog.csdn.net/zythy/article/details/17852579
hadoop学习:http://www.cnblogs.com/admln/category/618480.html
hadoop提交作业:http://weixiaolu.iteye.com/blog/1402919
所以,如果要永久修改RedHat的hostname,就修改/etc/sysconfig/network文件,将里面的HOSTNAME这一行修改成HOSTNAME=NEWNAME,其中NEWNAME就是你要设置的hostname。
1.机器准备:
关闭防火墙:
service iptables stop
service iptables status
10.112.29.177 vm-10-112-29-177 namenode
10.112.29.172 vm-10-112-29-172 datanode
10.112.29.174 vm-10-112-29-174 datanode
2.无密码登录:
生成master公钥:
- cd ~/.ssh (进入用户目录下的隐藏文件.ssh)
- ssh-keygen -t rsa (用rsa生成密钥)
- cp id_rsa.pub authorized_keys (把公钥复制一份,并改名为authorized_keys,这步执行完,应该ssh localhost可以无密码登录本机了,可能第一次要密码)
- scp authorized_key root@vm-10-112-29-172:~/.ssh (把重命名后的公钥通过ssh提供的远程复制文件复制到从机vm-10-112-29-172上面)
- chmod 600 authorized_keys (更改公钥的权限,也需要在从机vm-10-112-29-172中执行同样代码)
- ssh vm-10-112-29-172 (可以远程无密码登录vm-10-112-29-172这台机子了,注意是ssh不是sudo ssh。第一次需要密码,以后不再需要密码)
方法2:
cat id_rsa.pub >> authorized_keys
scp root@master:~/.ssh/id_dsa.pub ~/.ssh/master_dsa.pub
cat~/.ssh/master_dsa.pub >> ~/.ssh/authorized_keys
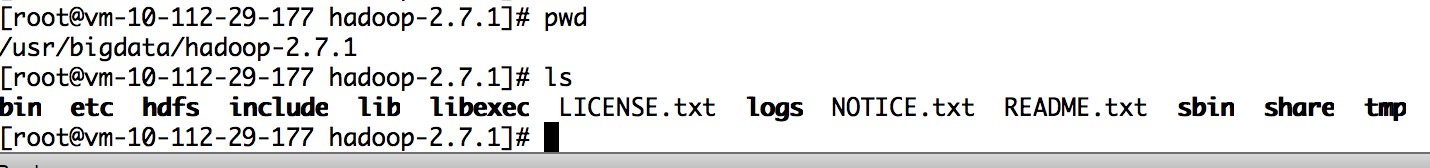
3.安装目录下创建数据存放的文件夹,tmp、hdfs、hdfs/data、hdfs/name
4.
修改/usr/bigdata/hadoop-2.7.1/etc/hadoop下的配置文件
修改core-site.xml,加上
    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://vm-10-112-29-177:9000</value>

    </property>

    <property>

        <name>hadoop.tmp.dir</name>

        <value>file:/usr/bigdata/hadoop-2.7.1/tmp</value>

    </property>

    <property>

        <name>io.file.buffer.size</name>

        <value>131702</value>

     </property>
5.修改hdfs-site.xml,加上
<property>

    <name>dfs.namenode.name.dir</name>

    <value>file:/usr/bigdata/hadoop-2.7.1/hdfs/namenode</value>

</property>

<property>

    <name>dfs.datanode.data.dir</name>

    <value>file:/usr/bigdata/hadoop-2.7.1/hdfs/datanode</value>

</property>

<property>

    <name>dfs.replication</name>

    <value>3</value>

</property>

<property>

    <name>dfs.namenode.secondary.http-address</name>

    <value>vm-10-112-29-177:9001</value>

</property>

<property>

     <name>dfs.webhdfs.enabled</name>

     <value>true</value>

</property>
6.修改mapred-site.xml,加上
<property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

</property>

<property>

        <name>mapreduce.jobhistory.address</name>

        <value>vm-10-112-29-177:10020</value>

</property>

<property>

        <name>mapreduce.jobhistory.webapp.address</name>

        <value>vm-10-112-29-177:19888</value>

</property>
7.修改yarn-site.xml,加上
<property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

</property>

<property>

        <name>yarn.nodemanager.auxservices.mapreduce.shuffle.class</name>

        <value>org.apache.hadoop.mapred.ShuffleHandler</value>

</property>

<property>

        <name>yarn.resourcemanager.address</name>

        <value>vm-10-112-29-177:8032</value>

</property>

<property>

        <name>yarn.resourcemanager.scheduler.address</name>

        <value>vm-10-112-29-177:8030</value>

</property>

<property>

        <name>yarn.resourcemanager.resource-tracker.address</name>

        <value>vm-10-112-29-177:8031</value>

</property>

<property>

        <name>yarn.resourcemanager.admin.address</name>

        <value>vm-10-112-29-177:8033</value>

</property>

<property>

        <name>yarn.resourcemanager.webapp.address</name>

        <value>vm-10-112-29-177:8088</value>

</property>

<property>

        <name>yarn.nodemanager.resource.memory-mb</name>

        <value>2048</value>

</property>
<property>
<name>yarn.nodemanager.resource.cpu-vcores</name>
<value>2</value>
</property>
注意:2048,2 设置过小,nodemanager启动失败 或者log中显示无法分配必要的资源 提交作业有可能一直 accpeted状态
8.
配置/user/bigdata/hadoop-2.7.1/etc/hadoop目录下hadoop-env.sh、yarn-env.sh的JAVA_HOME,否则启动时会报error
export JAVA_HOME=/usr/java/jdk1.7.0_80
9.
配置/user/bigdata/hadoop-2.7.1/etc/hadoop目录下slaves
加上你的从服务器,
vm-10-112-29-172
vm-10-112-29-174
配置成功后,将hadhoop复制到各个从服务器上
scp -r /user/bigdata/hadoop-2.7.1 root@vm-10-112-29-172:/user/bigdata/
scp -r /user/bigdata/hadoop-2.7.1 root@vm-10-112-29-174:/user/bigdata/
scp /usr/bigdata/hadoop-2.6.2/etc/hadoop/yarn-site.xml root@vm-10-112-29-174:/usr/bigdata/hadoop-2.6.2/etc/hadoop
10.
主服务器上执行bin/hdfs namenode -format
进行初始化
sbin目录下执行 ./start-all.sh
可以使用jps查看信息
停止的话,输入命令,sbin/stop-all.sh
11.
这时可以浏览器打开10.112.29.177:8088查看集群信息啦
到此配置就成功啦,开始你的大数据旅程吧。。。
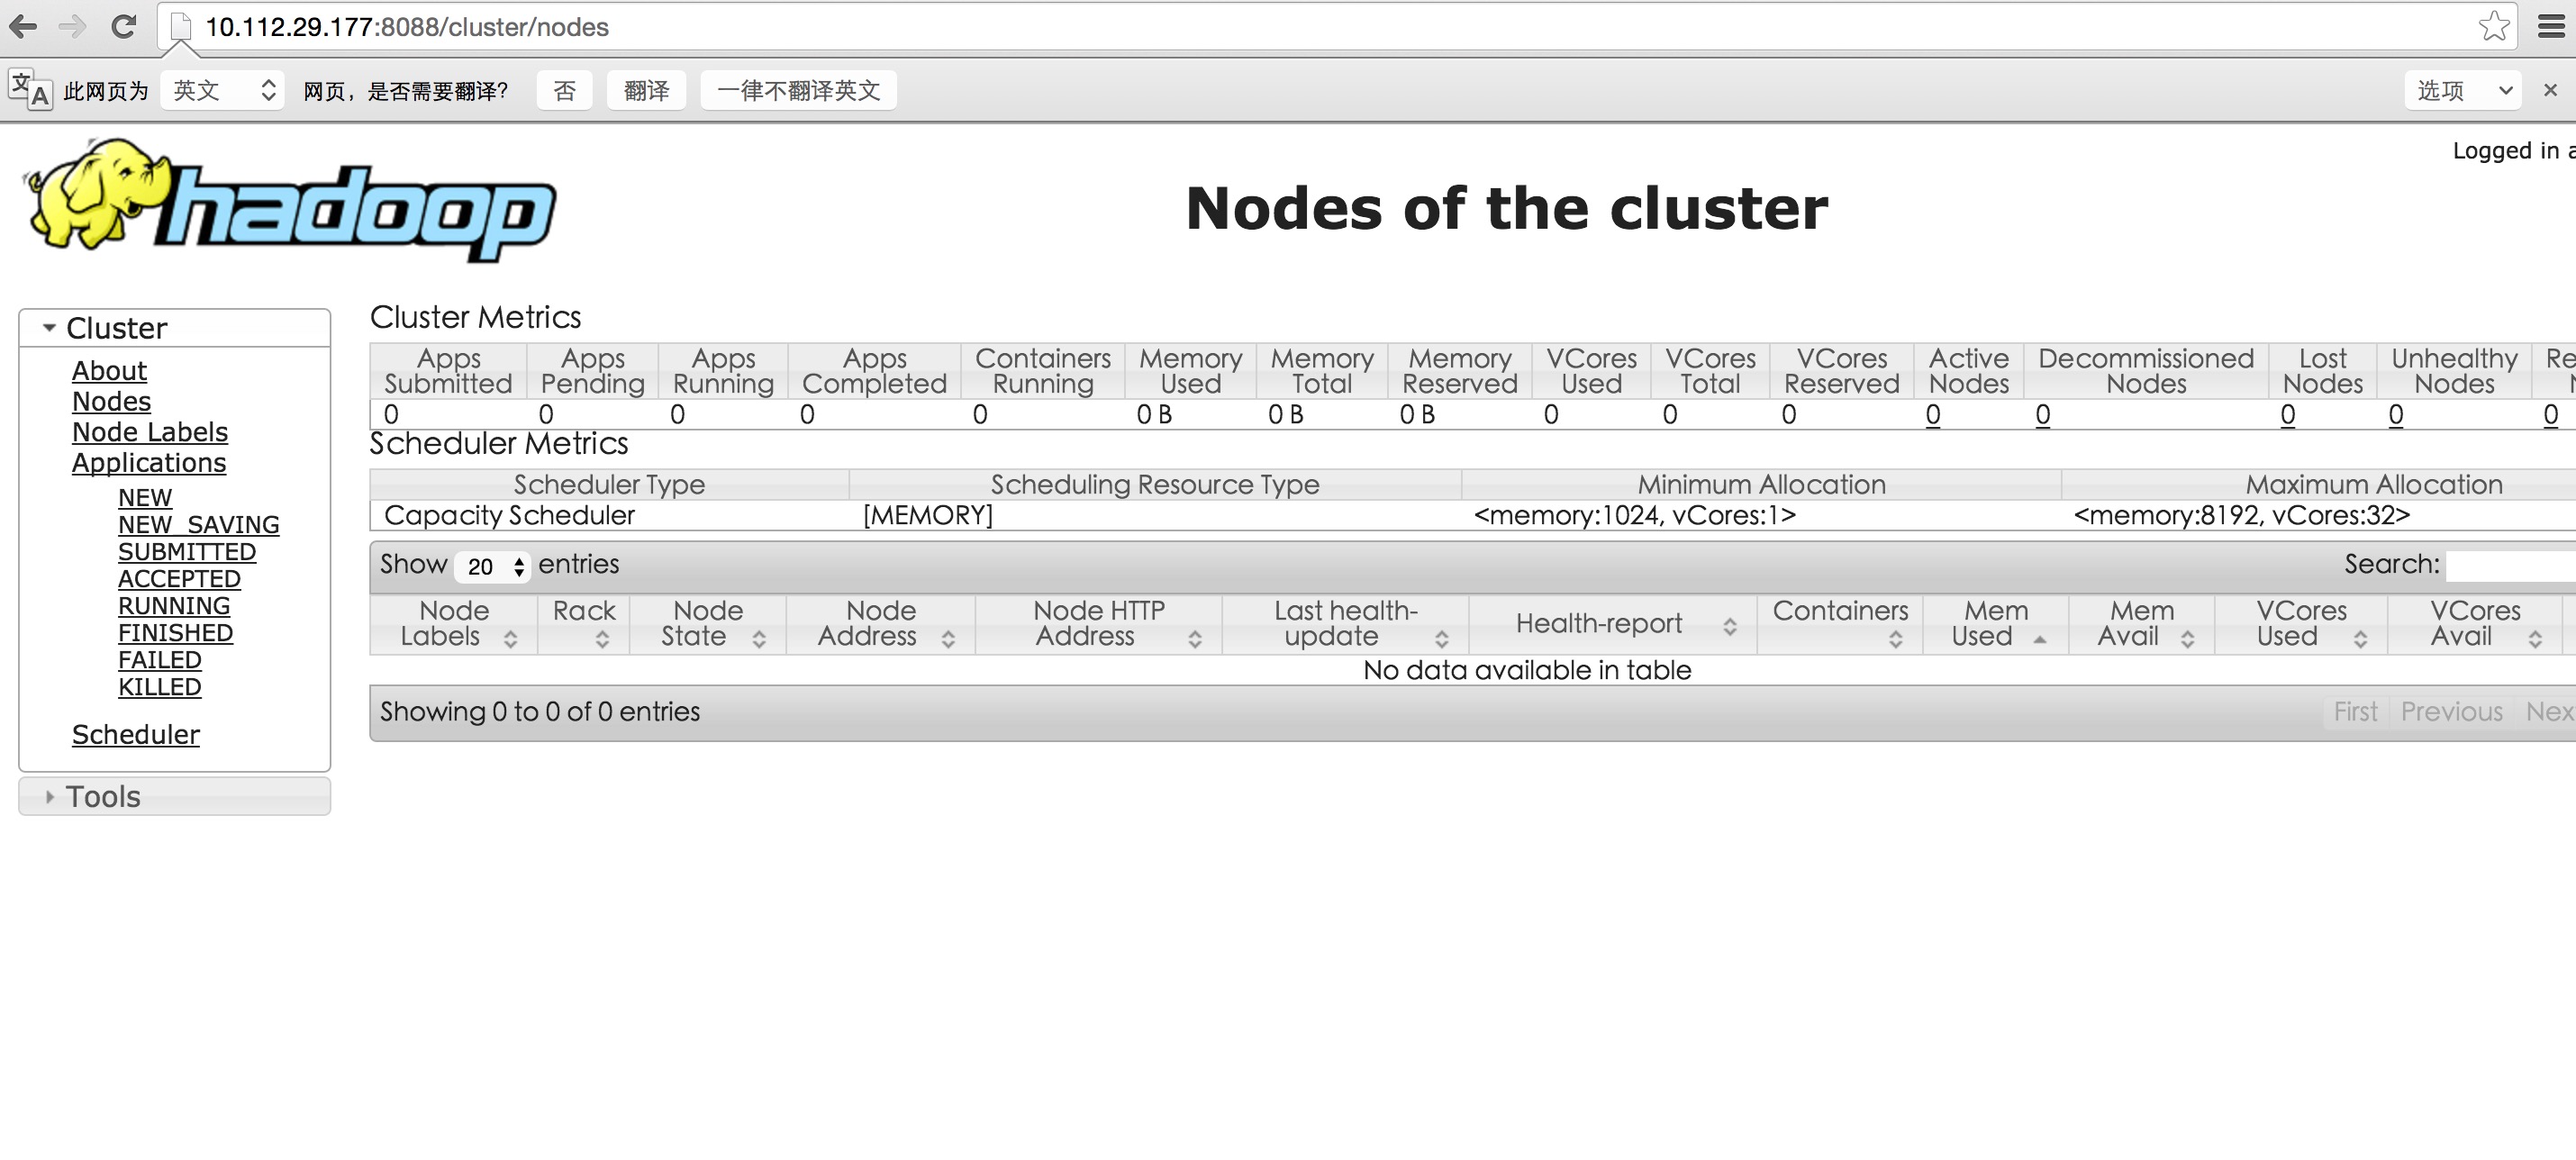
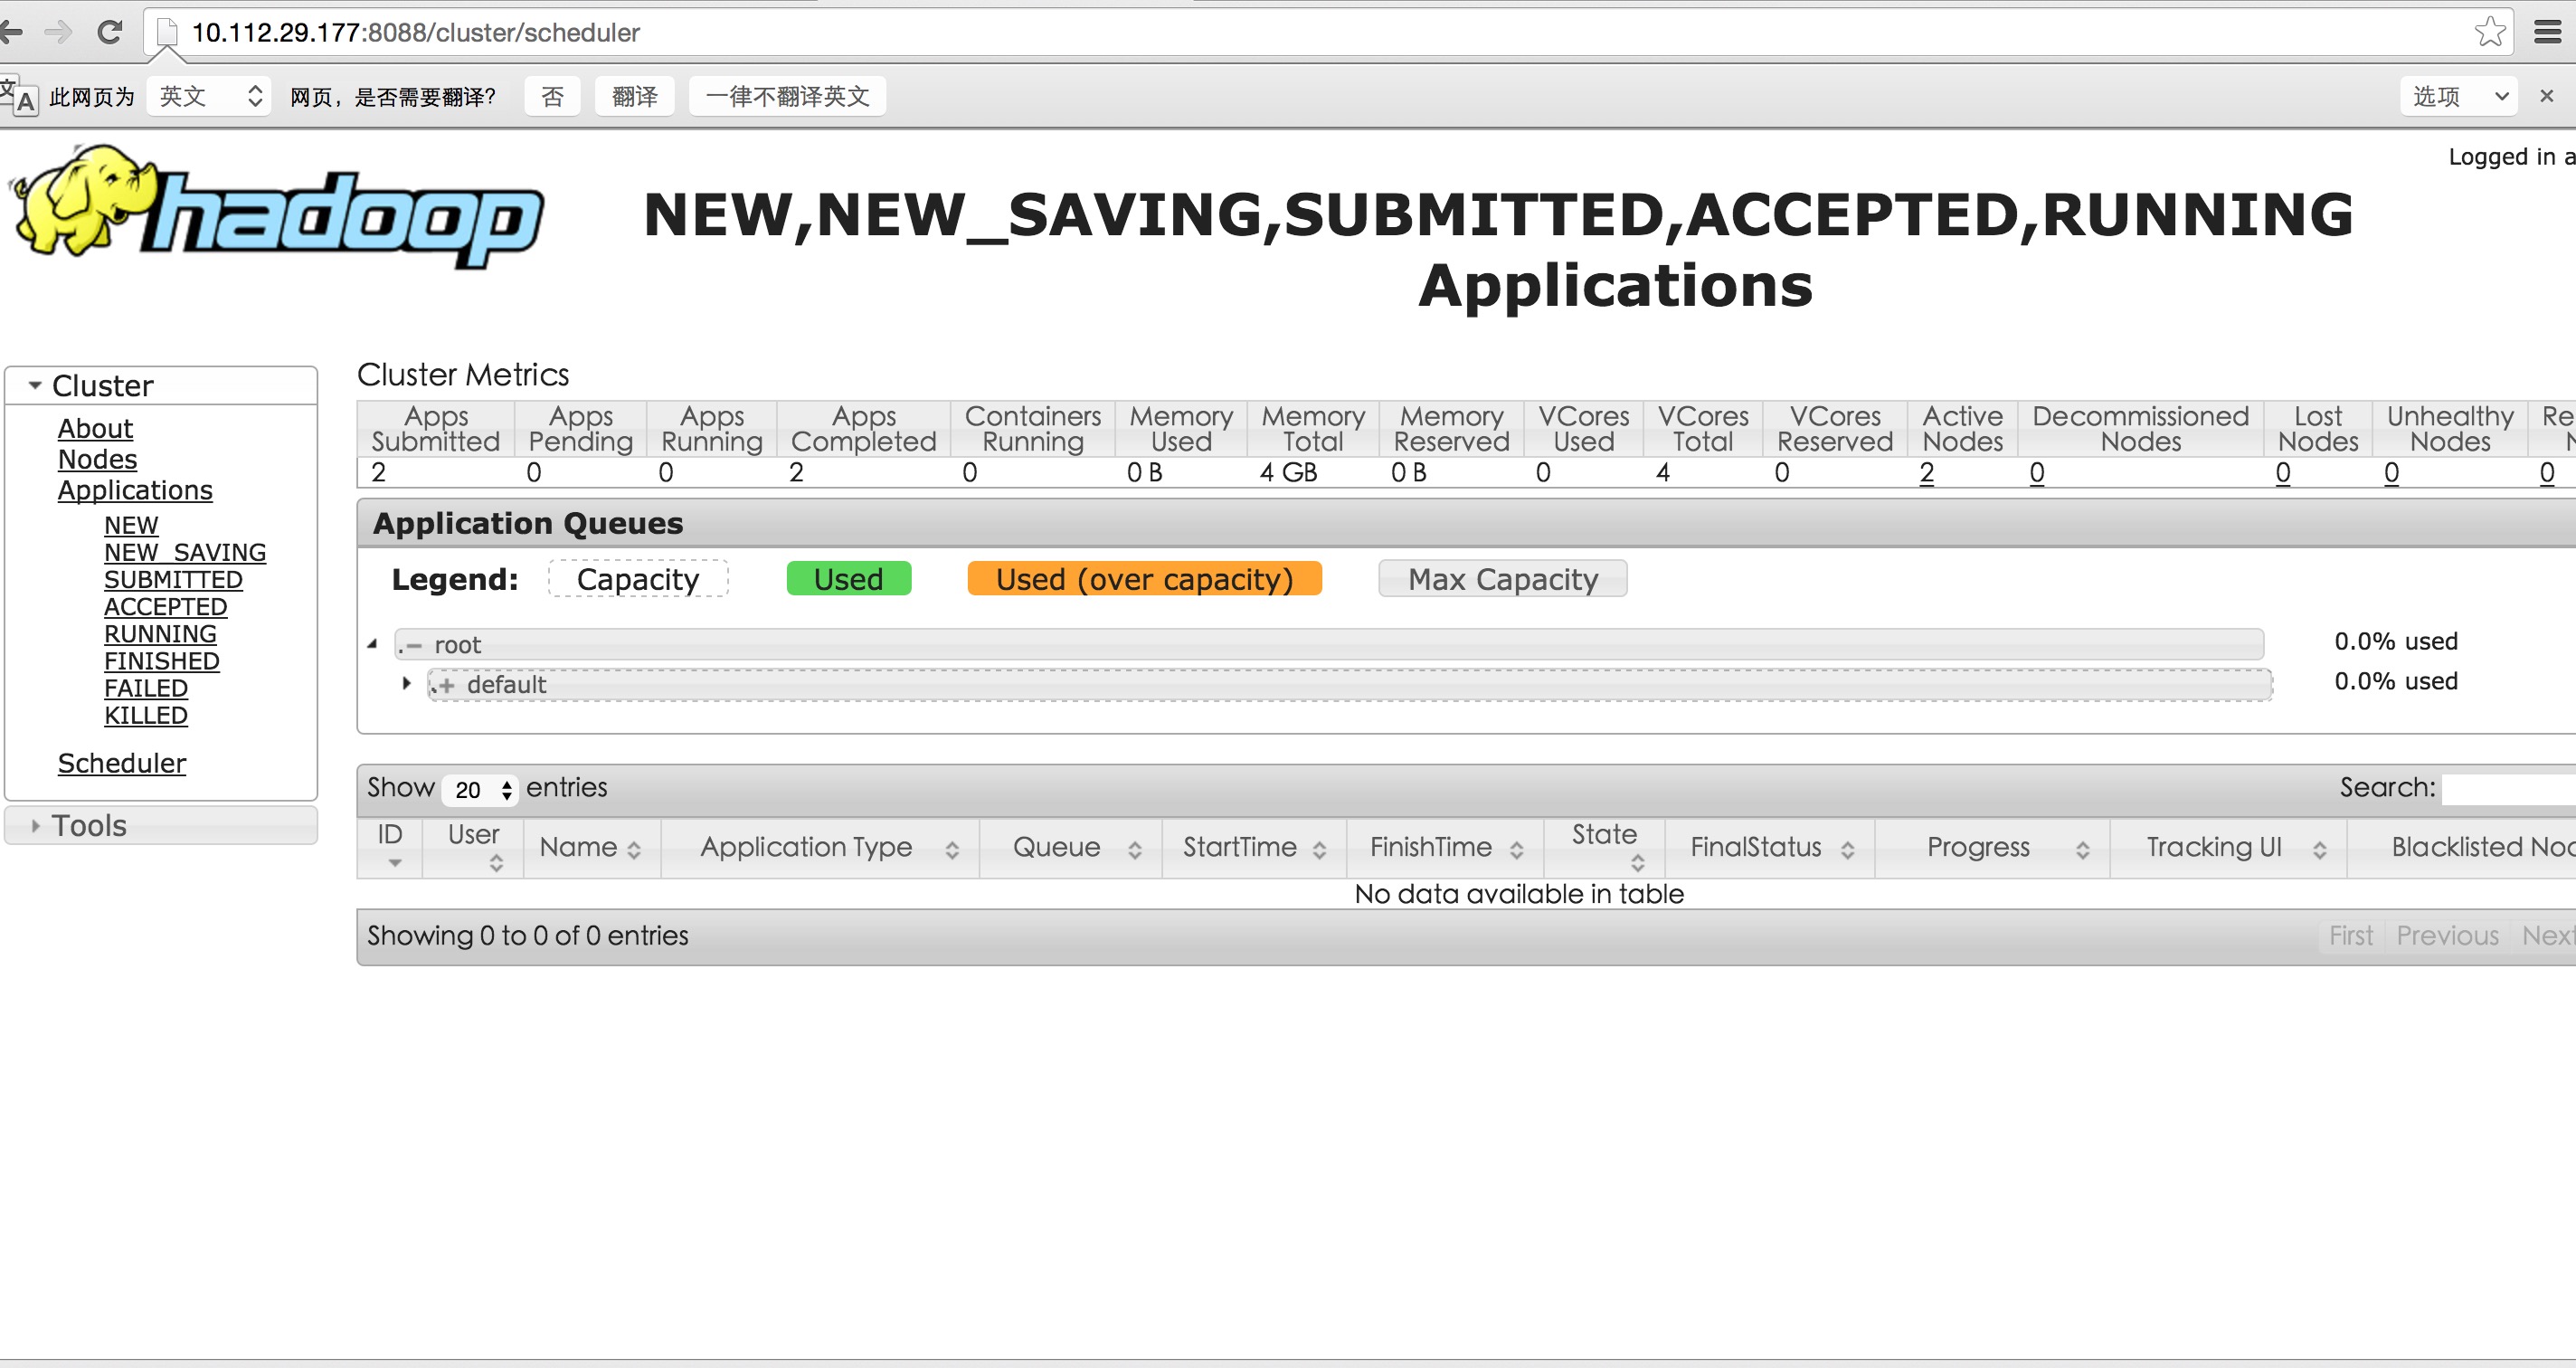
解决nodemanager 启动问题以后:
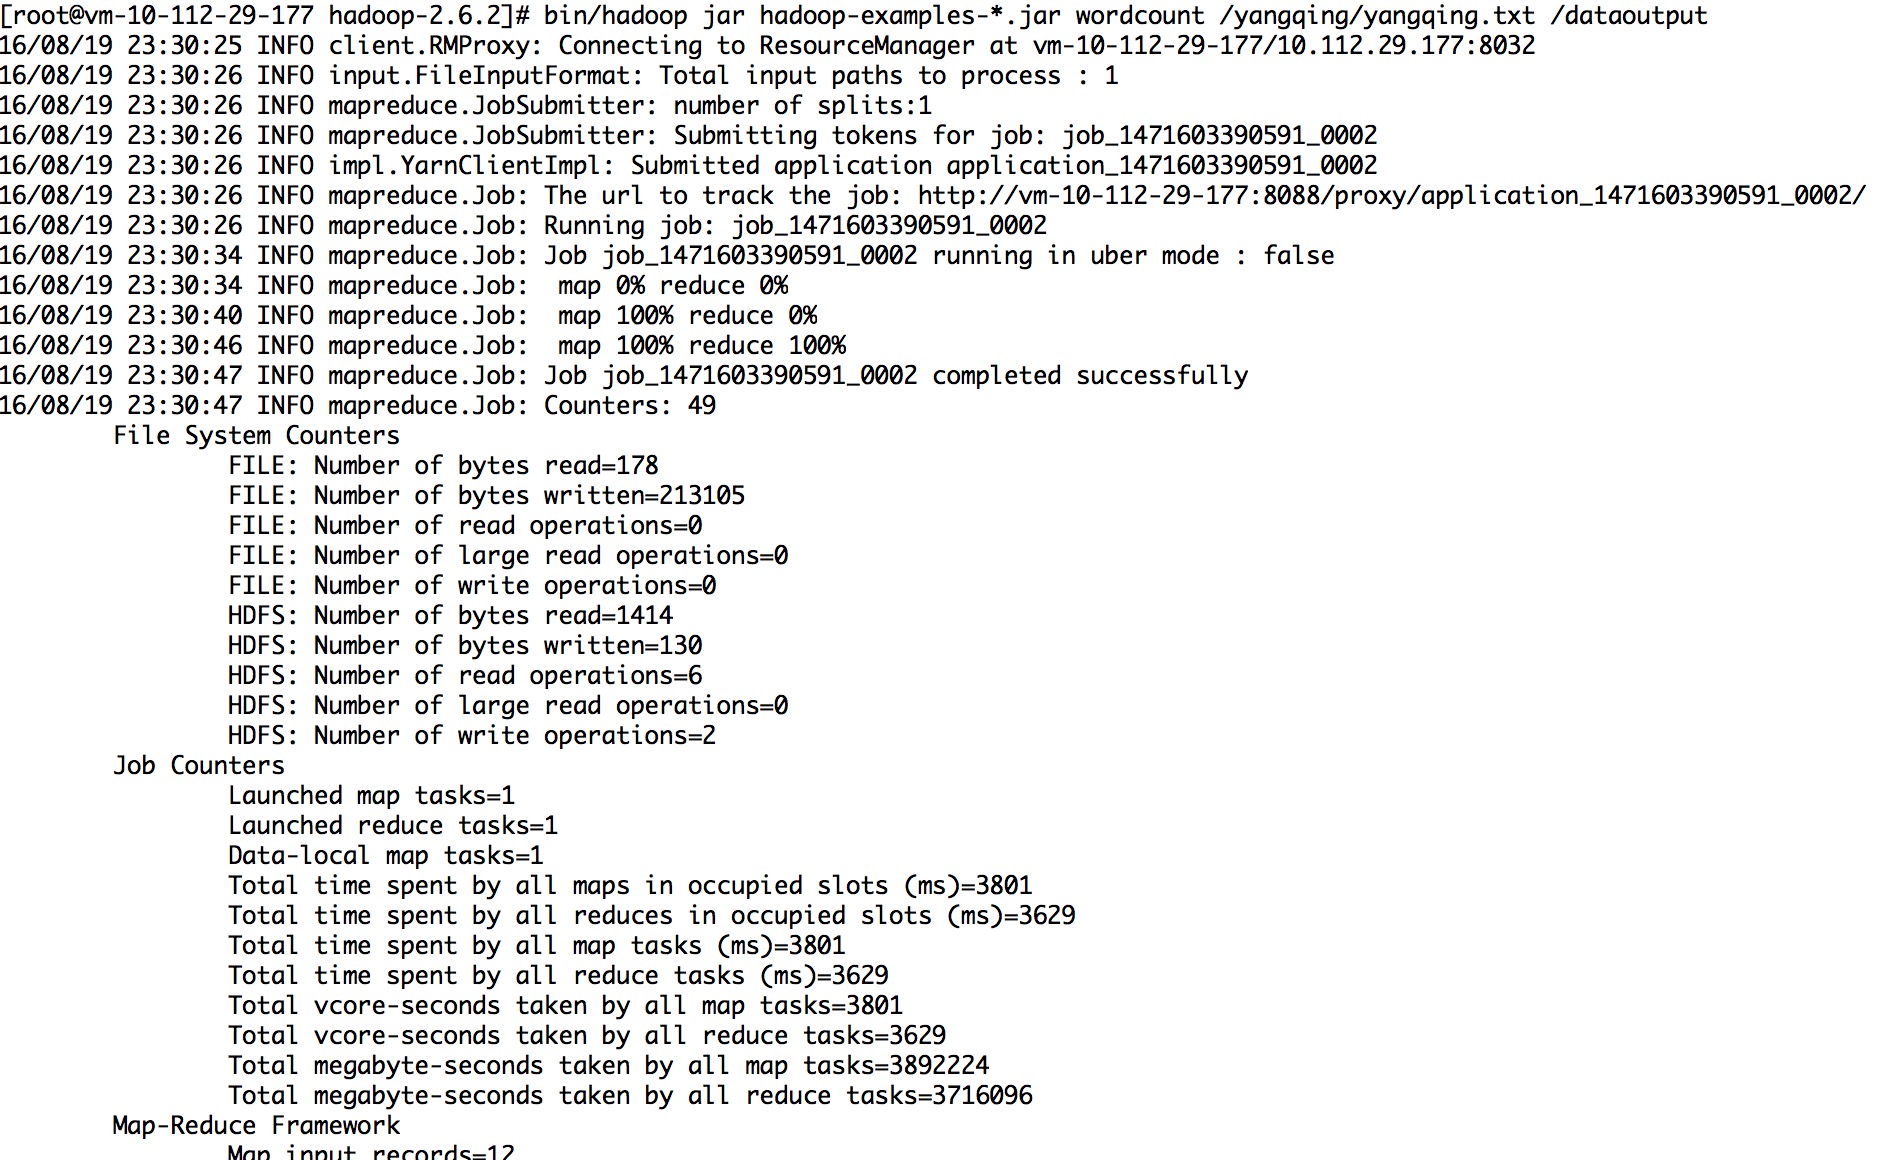
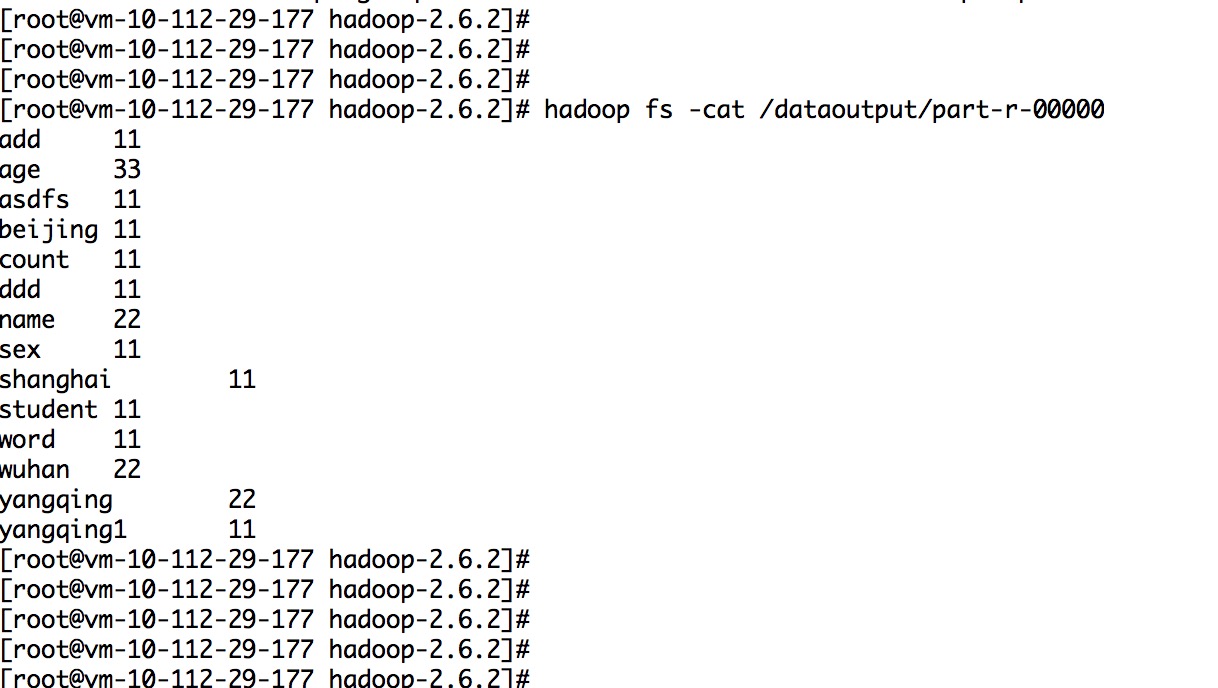
10.实例代码:
http://blog.csdn.net/ylchou/article/details/9264899
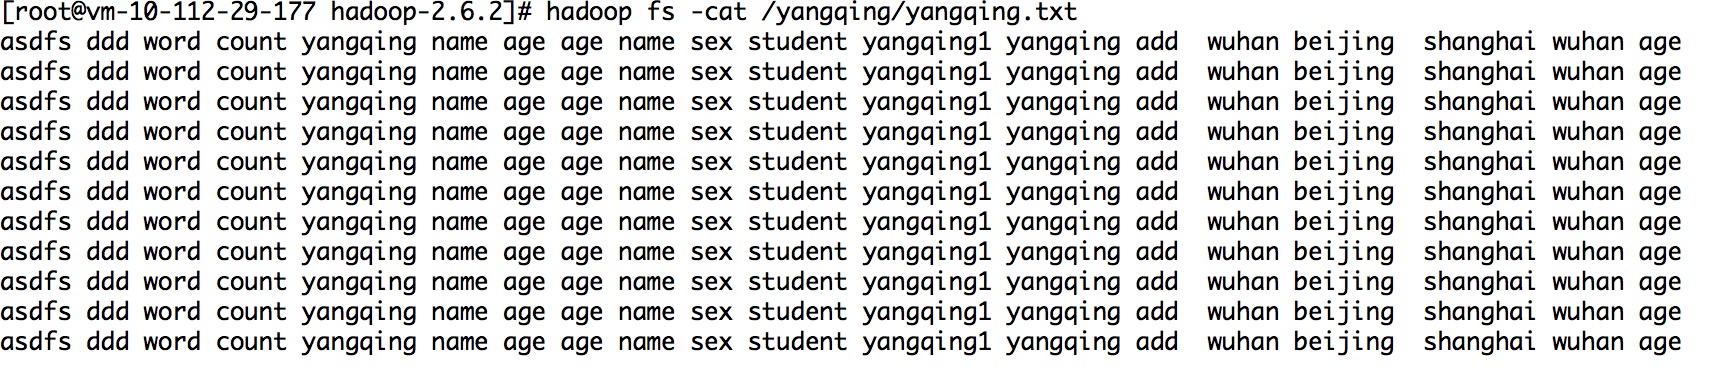
sh bin/hadoop fs -mkdir /tttt

 bin/hadoop fs -put /root/test/tttt.txt /tttt

scp -r /usr/bigdata/hadoop-2.6.2 root@vm-10-112-29-174:/usr/bigdata/
hadoop集群安装_实战的更多相关文章
- Apache Hadoop 集群安装文档
简介: Apache Hadoop 集群安装文档 软件:jdk-8u111-linux-x64.rpm.hadoop-2.8.0.tar.gz http://www.apache.org/dyn/cl ...
- 1.Hadoop集群安装部署
Hadoop集群安装部署 1.介绍 (1)架构模型 (2)使用工具 VMWARE cenos7 Xshell Xftp jdk-8u91-linux-x64.rpm hadoop-2.7.3.tar. ...
- Apache Hadoop集群安装(NameNode HA + SPARK + 机架感知)
1.主机规划 序号 主机名 IP地址 角色 1 nn-1 192.168.9.21 NameNode.mr-jobhistory.zookeeper.JournalNode 2 nn-2 ).HA的集 ...
- Apache Hadoop集群安装(NameNode HA + YARN HA + SPARK + 机架感知)
1.主机规划 序号 主机名 IP地址 角色 1 nn-1 192.168.9.21 NameNode.mr-jobhistory.zookeeper.JournalNode 2 nn-2 192.16 ...
- 2 Hadoop集群安装部署准备
2 Hadoop集群安装部署准备 集群安装前需要考虑的几点硬件选型--CPU.内存.磁盘.网卡等--什么配置?需要多少? 网络规划--1 GB? 10 GB?--网络拓扑? 操作系统选型及基础环境-- ...
- Hadoop集群安装配置教程_Hadoop2.6.0_Ubuntu/CentOS
摘自:http://www.powerxing.com/install-hadoop-cluster/ 本教程讲述如何配置 Hadoop 集群,默认读者已经掌握了 Hadoop 的单机伪分布式配置,否 ...
- hadoop集群安装故障解决
nodemanager进程解决:http://blog.csdn.net/baiyangfu_love/article/details/13504849 编译安装:http://blog.csdn.n ...
- linux hadoop 集群安装步骤
http://blog.csdn.net/xjavasunjava/article/details/12013677 1,时间同步hadoop集群的每台机器的时间不能相差太大. 安装集群前最好进行一下 ...
- hadoop集群安装
首现非常感谢 虾皮(http://www.cnblogs.com/xia520pi/archive/2012/05/16/2503949.html) 安装过程是参照他的<Hadoop集群(第5期 ...
随机推荐
- 数据结构(Java描述)之线性表
基础概念 数据结构:是相互之间存在一种或多种关系的数据元素的集合. 逻辑结构和物理结构 关于数据结构,我们可以从逻辑结构和物理结构这两个维度去描述 逻辑结构是数据对象中数据元素之间的关系,是从逻辑意义 ...
- 利用setns()将进程加入一个新的network namespace
1.首先使用docker创建一个容器,并获取该容器的network namespace monster@monster-Z:~$ docker run -itd --name test ubuntu ...
- BZOJ 3531: [Sdoi2014]旅行 [树链剖分]
3531: [Sdoi2014]旅行 Time Limit: 20 Sec Memory Limit: 512 MBSubmit: 1685 Solved: 751[Submit][Status] ...
- Strust2初之体验
Struts2的第一个案例 首先我们需要引入架包 entity: package cn.happy.entity; /** * Entity Object * @author Happy * */ p ...
- 前端MVC学习总结——AngularJS验证、过滤器
前端MVC学习总结--AngularJS验证.过滤器 目录 一.验证 二.过滤器 2.1.内置过滤器 2.1.1.在模板中使用过滤器 2.1.2.在脚本中调用过滤函数 2.2.自定义过滤器 三.指令( ...
- [No000076]用Eclipse编写python(配置PyDev插件)
下载,安装python解释器 地址:https://www.python.org/downloads/ 下载,安装java jdk 地址:http://www.oracle.com/technetwo ...
- 配置Jenkins使用Gitlab的代码库进行构建
1. 首先确认Jenkins上安装了Git plugin, 以及Subversion plugin Manage Jenkins -> Plugin Manager -> Availabl ...
- 给大家推荐一款高大上的代码高亮插件(sublime,github风格)——highlight.js
经常在一些大神博客里面看到非常好看的高亮代码,有sublime风格,GitHub风格等等.毫无疑问,好的高亮代码插件可以不仅仅让你的博文显得更高大上,更重要的是舒适的阅读体验.经过我在网上的一番搜罗, ...
- .NET跨平台之旅:借助ASP.NET 5 Beta5的新特性显示CLR与操作系统信息
今天在 MSDN 博客上看到了 ASP.NET 5 Beta5 的发布消息(详见 ASP.NET 5 Beta5 Now Available),从中知道了 2 个新特性: 1. DNX: New IR ...
- Dijkstra的双栈算术表达式的求值算法
例如需要计算 ( 1 + ( ( 2 + 3 ) * ( 4 * 5 ) ) ) 我们以字符串的形式输入该表达式,利用两个栈来完成这个操作,其中一个栈保存运算符,一个栈保存操作数,过程是这样的: 表 ...