
python2爬取国家统计局全国省份城市区街道信息
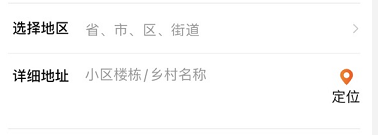
工作中,再次需要python,发现python用得好 ,真的可以节省很多人力,先说我的需求,需要做一个类似像支付宝添加收货地址时,选择地区的功能,需要详细到街道信息,也就是4级联动,如右图。首先需要的就是级联的数据,许是百度能力太差,找不到想要的,或者想要的需要积分才能下载,没有积分,只能干巴巴看着,好无奈,想起国家统计局有这个,以前在那里下载过,是一个表格,现在也忘记放哪里了,在它的官网找了好久,都没找到,后来是如何找到这个链接的也忘记了:http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2020/index.html,找到链接,第一个想到的就是pathon,于是决定靠自己丰衣足食。最后的代码如下,才70多行,咋一下不难,但也花费了我2天时间,脑袋有时候还是不够清晰。
 1 # -*-coding:utf-8 -*-

 2 import urllib2,urllib

 3 from selenium import webdriver

 4 import time

 5 import sys

 6 reload(sys)

 7 sys.setdefaultencoding('utf-8')

 8 import os

 9

10 def writeData(tasklist):

11     conf = 'ck.txt'

12     file = open("%s/%s" % (os.path.abspath(os.path.dirname(__file__)), conf),"a+")

13     file.write(tasklist)

14     file.close()

15

16 chrome = webdriver.Chrome()

17 chrome.get("http://www.stats.gov.cn/tjsj/tjbz/tjyqhdmhcxhfdm/2020/index.html")

18 time.sleep(10)

19 href=[]

20 href1=[]

21 href2=[]

22 href3=[]

23 href4=[]

24 href5=[]

25 href6=[]

26 text=[]

27 text3=[]

28 text5=[]

29

30 href1=chrome.find_elements_by_css_selector('.provincetr td a')[30:]

31 # 省份和其对于的下一级链接

32 for q in href1:

33     href.append(q.get_attribute('href'))

34     text.append(q.get_attribute('innerHTML'))

35 for h,t in zip(href,text):

36     # if t.find("上海市")<0:

37     #     continue

38     if h=='':continue

39     chrome.get(h)

40     time.sleep(3)

41     writeData(t)

42     href2=chrome.find_elements_by_css_selector(".citytr :nth-child(2) a")

43     #城市和其对应的下一级链接

44     timer=0

45     while timer<len(href2):

46         q1=chrome.find_elements_by_css_selector(".citytr :nth-child(2) a")[timer]

47         timer+=1

48         href3=q1.get_attribute('href')

49         text3=q1.get_attribute('innerHTML')

50         if href3=='':continue

51         chrome.get(href3)

52         time.sleep(3)

53         href4=chrome.find_elements_by_css_selector(".countytr :nth-child(2) a")

54         #区和其对应的下一级链接

55         timer7=0

56         while timer7<len(href4):

57             print timer7

58             print len(href4)

59             q2=chrome.find_elements_by_css_selector(".countytr :nth-child(2) a")[timer7]

60             timer7+=1

61             href5=q2.get_attribute('href')

62             text5=q2.get_attribute('innerHTML')

63             if href5=='':continue

64             chrome.get(href5)

65             time.sleep(3)

66             href6=chrome.find_elements_by_css_selector(".towntr :nth-child(2) a")

67             #街道信息

68             timer6=0

69             while timer6<len(href6):

70                 q3=chrome.find_elements_by_css_selector(".towntr :nth-child(2) a")[timer6]

71                 timer6+=1

72                 writeData(t+"   "+text3+"   "+text5+"   "+q3.get_attribute('innerHTML')+"\n")

73             chrome.back()

74         chrome.back()

75     chrome.back()

76
下面说说我遇到的主要问题,记录下来,免得下次又踩坑。
1.用for in循环遍历,报错:element is not attached to the page document,发现是chrome.get打开另一个页面之后,再回来就会报这边错误,原来是页面刷新之后,需要重新获取一下元素,一开始我是用了3个for in 遍历的,发现不行,就改为了while,在while重新获取一次元素,获取元素依次增一。
2.爬到的数据有缺失,发现是变量timer,timer7,timer6,在每个while循环前,需要复位为0。
3.大概爬到三分一的时候,需要填入图片中的数字才可以继续打开页面,页面做了反爬,很多网站都会有所限制,接下来的爬取,很多时候需要人工干预,改变爬取的起点,让程序继续爬取剩下的数据
4,。我用的是txt保存爬到的数据,我一开始是打算用excel的,但是安装xlwt失败,报编码问题,安装包的时候,经常遇到这个问题,也不知道怎么搞
爬完之后,得到的文件有2M多,的确是蛮大的。有5万多行呢。

python2爬取国家统计局全国省份城市区街道信息的更多相关文章
- 使用java爬取国家统计局的12位行政区划代码
前言: 本文基于j2ee的原始url进行都写,解析指定内容时也是使用很傻的形式去查找指定格式的字符串来实现的. 更优雅的方式是可以使用apache的HttpClient和某些文档模型将HTML字符串构 ...
- Python 2.7 爬取51job 全国java岗位
一页有50条数据一共2000页 分页是get分页 #!/usr/bin/python # encoding: utf-8 import requests import threading from ...
- 使用requests+pyquery爬取dd373地下城跨五最新商品信息
废话不多说直接上代码: 可以使用openpyel库对爬取的信息写入Execl表格中代码我就不上传了 import requests from urllib.parse import urlencode ...
- 网络爬虫之scrapy爬取某招聘网手机APP发布信息
1 引言 过段时间要开始找新工作了,爬取一些岗位信息来分析一下吧.目前主流的招聘网站包括前程无忧.智联.BOSS直聘.拉勾等等.有段时间时间没爬取手机APP了,这次写一个爬虫爬取前程无忧手机APP岗位 ...
- 利用Python爬虫爬取指定天猫店铺全店商品信息
本编博客是关于爬取天猫店铺中指定店铺的所有商品基础信息的爬虫,爬虫运行只需要输入相应店铺的域名名称即可,信息将以csv表格的形式保存,可以单店爬取也可以增加一个循环进行同时爬取. 源码展示 首先还是完 ...
- Python爬取前程无忧网站上python的招聘信息
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 我姓刘却留不住你的心 PS:如有需要Python学习资料的小伙伴可以 ...
- 爬取前程无忧网站上python的招聘信息。
本文获取的字段有为职位名称,公司名称,公司地点,薪资,发布时间 创建爬虫项目 scrapy startproject qianchengwuyou cd qianchengwuyou scrapy g ...
- Python爬取网址中多个页面的信息
通过上一篇博客了解到爬取数据的操作,但对于存在多个页面的网址来说,使用上一篇博客中的代码爬取下来的资料并不完整.接下来就是讲解该如何爬取之后的页面信息. 一.审查元素 鼠标移至页码处右键,选择检查元素 ...
- 他爬取了B站所有番剧信息,发现了这些……
本文来自「楼+ 之数据分析与挖掘实战 」第 4 期学员 -- Yueyec 的作业.他爬取了B站上所有的番剧信息,发现了很多有趣的数据- 关键信息:最高播放量 / 最强up主 / 用户追番数据 / 云 ...
随机推荐
- Flutter DraggableScrollableSheet 可滚动对象的容器
文档 Example import 'package:flutter/material.dart'; void main() => runApp(MyApp()); class MyApp ex ...
- C++算法代码——选举学生会
题目来自:https://www.luogu.com.cn/problem/P1271 题目描述 学校正在选举学生会成员,有 n(n\le 999)n(n≤999) 名候选人,每名候选人编号分别从 1 ...
- java 判断是否存在路径,不存在自动创建(兼容 window 和 linux)
1 private void createPath(String path){ 2 String os = System.getProperty("os.name"); 3 Str ...
- 维格表2月更新:智能图表上线,唤醒全量工作数据堪比AI
你是否曾经想过,你的维格表数据有朝一日变化出如科幻电影般的数据图表? 你是否感到厌倦,对当前的后台系统密密麻麻的数据累觉不爱? 你是否一直期待,拥有一个专属大数据 BI 看板,让你的规划如有神助,挥斥 ...
- Linux进程管理工具Supervisor的安装配置
目录 Linux进程管理工具Supervisor的安装配置 简介 安装Python包管理工具 安装Supervisor 配置 配置文件参数说明 配置进程管理 启动supervisor 控制进程 交互终 ...
- Linux下安装mysql-5.7.28详细步骤
一.下载Mysql 下载地址:https://downloads.mysql.com/archives/community/ 二.环境配置 检测系统是否自带Mysql # rmp -qa|grep m ...
- Tawk.to工具使用攻略--如何让访客通过tawk.to联系时先填写邮箱、联系方式等信息
Tawk.to工具使用攻略--如何让访客通过tawk.to联系时先填写邮箱.联系方式等信息 您在使用tawk.to的时候,是否遇到当访客联系您时,您未能及时查看到tawk.to的消息,后续想要再联系访 ...
- 代码小知识之UUID
1.生成UUID(UUID保证对在同一时空中的所有机器都是唯一的,UUID的唯一缺陷在于生成的结果串会比较长.UUID 来作为数据库数据表主键是非常不错的选择,保证每次生成的UUID 是唯一的) UU ...
- MYSQL bin_log 开启及数据恢复
参考博客: A:https://www.jianshu.com/p/55b0d52edca2 B:https://www.cnblogs.com/martinzhang/p/3454358.html ...
- SpringBoot整合Mongodb4.0
本品文章只做学习使用: 安装mongodb推荐博客:https://www.jianshu.com/p/a75e26e5f635 1:如何在外网环境下开放mongodb 服务器版本:centos7.6 ...