
centos7安装Scala、Spark(伪分布式)
centos7安装spark(伪分布式)
spark是由scala语言开发的,首先需要安装scala.
Scala安装
下载scala-2.11.8,(与spark版本要对应)
命令:wget https://downloads.lightbend.com/scala/2.11.8/scala-2.11.8.tgz
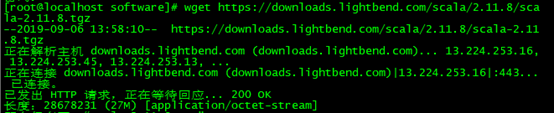
解压到文件夹并配置环境变量
vim /etc/profile
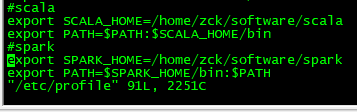
#scala
export SCALA_HOME=/home/zck/software/scala
export PATH=$PATH:$SCALA_HOME/bin
使配置文件生效
测试:scala -version

配置伪分布式spark;
解压到文件夹并配置环境变量
vim /etc/profile
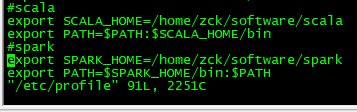
末尾添加以下内容
#spark
export SPARK_HOME=/home/zck/software/spark
export PATH=$SPARK_HOME/bin:$PATH测试
修改配置文件spark/conf/spark-env.sh
加入内容
export JAVA_HOME=/home/zck/software/jdk
export SCALA_HOME=/home/zck/software/scala
export HADOOP_HOME=/home/zck/software/hadoop
export HADOOP_CONF_DIR=/home/zck/software/hadoop/etc/hadoop
export SPARK_MASTER_IP=192.168.13.101
export SPARK_MASTER_PORT=7077
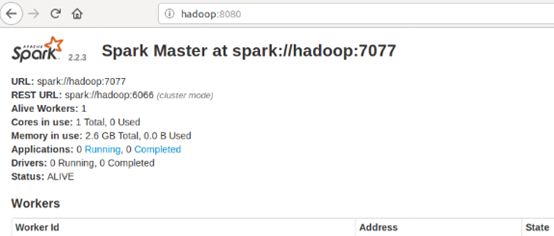
启动spark服务
进入spark文件夹,sbin/start-all.sh

然后再去浏览器看看
Spark yarn模式配置
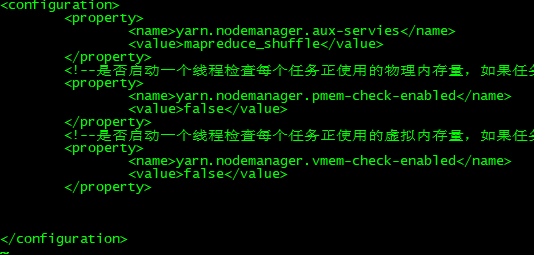
1、修改hadoop配置文件yarn-site.xml,添加如下内容:
<!--是否启动一个线程检查每个任务正使用的物理内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
<name>yarn.nodemanager.pmem-check-enabled</name>
<value>false</value>
</property>
<!--是否启动一个线程检查每个任务正使用的虚拟内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value>
</property>
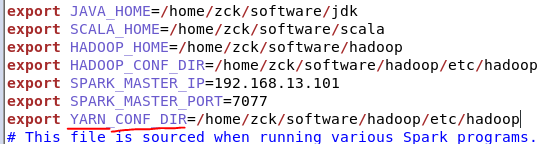
2、修改spark-env.sh,添加如下配置:
export YARN_CONF_DIR=/opt/module/hadoop-2.7.2/etc/hadoop
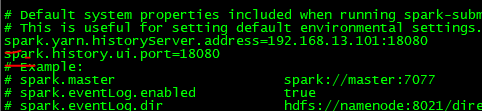
3、日志配置
修改配置文件spark-defaults.conf
添加如下内容:
spark.yarn.historyServer.address=hadoop102:18080
spark.history.ui.port=18080
4、重启spark历史服务
sbin/stop-history-server.sh
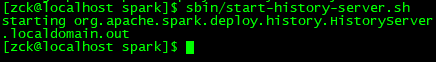
sbin/start-history-server.sh
Spark几种模式对比
|
模式 |
Spark安装机器数 |
需启动的进程 |
所属者 |
|
Local |
1 |
无 |
Spark |
|
Standalone |
3 |
Master及Worker |
Spark |
|
Yarn |
1 |
Yarn及HDFS |
Hadoop |
centos7安装Scala、Spark(伪分布式)的更多相关文章
- ZooKeeper:win7上安装单机及伪分布式安装
zookeeper是一个为分布式应用所设计的分布式的.开源的调度服务,它主要用来解决分布式应用中经常遇到的一些数据管理问题,简化分布式应用,协调及其管理的难度,提高性能的分布式服务. 本章的目的:如何 ...
- Hadoop的HDFS和MapReduce的安装(三台伪分布式集群)
一.创建虚拟机 1.从网上下载一个Centos6.X的镜像(http://vault.centos.org/) 2.安装一台虚拟机配置如下:cpu1个.内存1G.磁盘分配20G(看个人配置和需求,本人 ...
- 大数据:Hadoop(JDK安装、HDFS伪分布式环境搭建、HDFS 的shell操作)
所有的内容都来源与 Hadoop 官方文档 一.Hadoop 伪分布式安装步骤 1)JDK安装 解压:tar -zxvf jdk-7u79-linux-x64.tar.gz -C ~/app 添加到系 ...
- Hadoop安装教程_伪分布式
文章更新于:2020-04-09 注1:hadoop 的安装及单机配置参见:Hadoop安装教程_单机(含Java.ssh安装配置) 注2:hadoop 的完全分布式配置参见:Hadoop安装教程_分 ...
- Mac环境下安装配置Hadoop伪分布式
伪分布式需要修改5个配置文件(hadoop2.x的配置文件$HADOOP_HOME/etc/hadoop) 第一个:hadoop-env.sh #vim hadoop-env.sh #第25行,由于新 ...
- 第5章 选举模式和ZooKeeper的集群安装 5-2 单机伪分布式安装zookeeper集群
先搭建伪分布式集群,再去搭建真分布式集群.有些的人的电脑内存.性能比较低,所以在搭建真实的一个分布式环境的话,可能会相对来说比较卡,所以两种都会做一下,首先会在单机上搭建一个集群.单机上的集群主要就是 ...
- Spark学习之路 (五)Spark伪分布式安装
一.JDK的安装 JDK使用root用户安装 1.1 上传安装包并解压 [root@hadoop1 soft]# tar -zxvf jdk-8u73-linux-x64.tar.gz -C /usr ...
- Spark学习之路 (五)Spark伪分布式安装[转]
JDK的安装 JDK使用root用户安装 上传安装包并解压 [root@hadoop1 soft]# tar -zxvf jdk-8u73-linux-x64.tar.gz -C /usr/local ...
- spark伪分布式安装
一,在官网下载对应的版本http://spark.apache.org/downloads.html 二在linux中解压下来的spark包 三:配置环境变量 (1)在/etc/profi ...
随机推荐
- Mybatis一对一和一对多配置
作者:夕下奕林 问题描述 现在有三张数据表,表名为orders,orderdetail,items,分别表示订单,订单详情,商品. 其中一个订单包含多个订单详情,表示订单中的不同个具体的商品,订单详情 ...
- [Python自学] day-21 (1) (请求信息、html模板继承与导入、自定义模板函数、自定义分页)
一.路由映射的参数 1.映射的一般使用 在app/urls.py中,我们定义URL与视图函数之间的映射: from django.contrib import admin from django.ur ...
- 【方法】移动端H5如何调用相册和相机上传图片、音频、视频
在移动端上传图片方法很简单,使用HTML5中的input:file供文件上传. <一>常用属性值: 1.accept:规定文件上传来提交的文件类型,此属性只能和type:file配合使用 ...
- 虚拟机里的nginx启动不了的问题
问题: 之前使用虚拟机nginx一直都是正常的, 就在昨天重新配置了一下nginx(其实只注释了反向代理,别的都没动), 重启nginx, 却报错pid为空. 无法启动nginx. 而且重启之前 ...
- 北京清北 综合强化班 Day3
括号序列(bracket) Time Limit:1000ms Memory Limit:128MB 题目描述 LYK有一个括号序列,但这个序列不一定合法. 一个合法的括号序列如下: ()是合法的 ...
- XGBoost的优点
1. Gradient boosting(GB) Gradient boosting的思想是迭代生多个(M个)弱的模型,然后将每个弱模型的预测结果相加,后面的模型Fm+1(x)基于前面学习模型的Fm( ...
- 基于熵的方法计算query与docs相似度
一.简单总结 其实相似度计算方法也是老生常谈,比如常用的有: 1.常规方法 a.编辑距离 b.Jaccard c.余弦距离 d.曼哈顿距离 e.欧氏距离 f.皮尔逊相关系数 2.语义方法 a.LSA ...
- 2016 Multi-University Training Contest 2 部分题解
1009,直接贪心,只要让后面的尽量小,第一位和第二位尽量大即可. 1011,直接统计奇数的字母的个数,然后用偶数的个数平均分配到它们上面即可.代码如下: #include <stdio.h&g ...
- [51nod1789] 跑得比谁都快
题面 题解 设\(f[i]\)为根节点到\(i\)的最小耗时 设\(S\)为\(i\)的祖先集合, 可以得到 \[ f[i] = min(f[j] + (i - j)^p),j \in S \] 对于 ...
- MySQL所谓的脏页和“抖”一下是什么联系?
在我们平时经常用到的sql更新语句,之前是认为只要sql执行,当前sql的操作会立马执行到服务器磁盘上并返回,但是后来我才知道,事实并非如此,在了解事实之前,首先可能需要先了解什么是redo log, ...