
爬虫实践---悦音台mv排行榜与简单反爬虫技术应用
由于要抓取的是悦音台mv的排行榜,这个排行榜是实时更新的,如果要求不停地抓取,这将有可能导致悦音台官方采用反爬虫的技术将ip给封掉。所以这里要应用一些反爬虫相关知识。
目标网址:http://vchart.yinyuetai.com/vchart/trends?area=ML
网站结构:
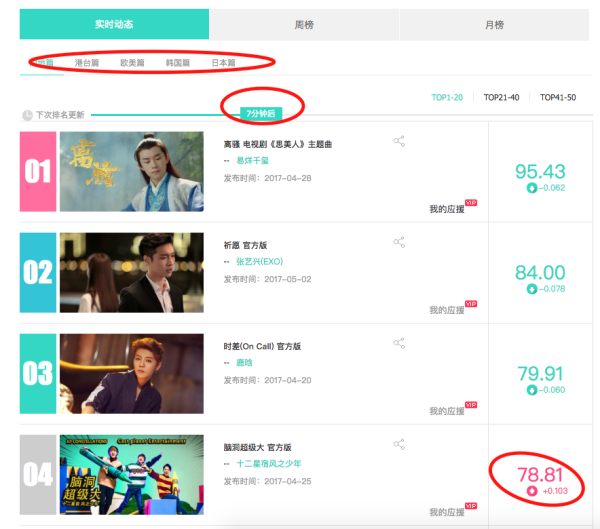
上面红线圈出来的地方都是需要注意的小细节:
首先 排行榜分为,内地、港台、欧美、韩国、日本五个地区
分别将其点开能够观察到url的变化为在最尾部加了一个参数:area=地区参数
很容易的就能知道参数列表:['ML','HT','US','JP','KR'] 分别对应着内地、香港、欧美、日本、以及韩国。发现这个规律之后,只要通过简单的对url的变化就能多次请求,筛选出想要的信息。
其次 可以发现,有的mv分数是呈现上升趋势,有的mv的分数是成下降趋势,这在网页的代码结构稍有不同。
最后,可以看到 这里mv的排行榜数据是实时更新的,所以爬虫程序要不停的在后台运行才能保证获得的数据是最新的,这样就会引起官方人员的注意,他们的反爬虫技术有可能就会将爬虫的IP封掉。
完整代码:
import requests

from bs4 import BeautifulSoup

import random

def get_html(url):

    try:

        r = requests.get(url,timeout=30)

        r.raise_for_status

        r.encoding = 'utf-8'

        return r.text

    except:

        return 'error'

def get_agent():

    '''

    模拟header的user-agent字段,

    返回一个随机的user-agent字典类型的键值对

    '''

    agents = ['Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1; Trident/5.0;',

              'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.6; rv,2.0.1) Gecko/20100101 Firefox/4.0.1',

              'Opera/9.80 (Macintosh; Intel Mac OS X 10.6.8; U; en) Presto/2.8.131 Version/11.11',

              'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_7_0) AppleWebKit/535.11 (KHTML, like Gecko) Chrome/17.0.963.56 Safari/535.11',

              'Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; 360SE)']

    fakeheader = {}

    fakeheader['User-agent'] = agents[random.randint(0, len(agents))]

    return fakeheader

def get_proxy():

    '''

    简单模拟代理池

    返回一个字典类型的键值对,

    '''

    proxy = ["http://116.211.143.11:80",

             "http://183.1.86.235:8118",

             "http://183.32.88.244:808",

             "http://121.40.42.35:9999",

             "http://222.94.148.210:808"]

    fakepxs = {}

    fakepxs['http'] = proxy[random.randint(0, len(proxy))]

    return fakepxs

def get_content(url):

    # 先打印一下表头

    if url[-2:] == 'ML':

        print('内地排行榜')

    elif url[-2:] == 'HT':

        print('香港排行榜')

    elif url[-2:] == 'US':

        print('欧美排行榜')

    elif url[-2:] == 'KR':

        print('韩国排行榜')

    else:

        print('日本排行榜')

    html = get_html(url)

    soup = BeautifulSoup(html,'lxml')

    li_list = soup.find_all('li',class_='vitem J_li_toggle_date ')

    for li in li_list:

        content = {}

        try:

            # 判断分数升降

            if li.find('h3',class_='desc_score'):

                content['分数'] = li.find('h3',class_='desc_score').text

            else:

                content['分数'] = li.find('h3',class_='asc_score').text

            content['排名'] = li.find('div',class_='top_num').text

            content['名字'] = li.find('a',class_='mvname').text

            content['发布时间'] = li.find('p',class_='c9').text[5:]

            content['歌手'] = li.find('a',class_='special').text

        except:

            return None

        print(content)

def main():

    base_url = 'http://vchart.yinyuetai.com/vchart/trends?area='

    suffix = ['ML','HT','US','JP','KR']

    for suff in suffix:

        url = base_url + suff

        print()

        get_content(url)

if __name__ == '__main__':

    main()
输出结果:

爬虫实践---悦音台mv排行榜与简单反爬虫技术应用的更多相关文章
- 大众点评评论数据抓取 反爬虫措施有css文字映射和字体库反爬虫
大众点评评论数据抓取 反爬虫措施有css文字映射和字体库反爬虫 大众点评的反爬虫手段有那些: 封ip,封账号,字体库反爬虫,css文字映射,图形滑动验证码 这个图片是滑动验证码,访问频率高的话,会出 ...
- Python3 网络爬虫:漫画下载,动态加载、反爬虫这都不叫事
一.前言 作者:Jack Cui 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做案例的人,却不知道如何去学习更加高深的知识.那 ...
- Python 有道翻译 爬虫 有道翻译API 突破有道翻译反爬虫机制
py2.7 #coding: utf-8 import time import random import hashlib import requests while(1): url = 'http: ...
- 简单的抓取淘宝关键字信息、图片的Python爬虫|Python3中级玩家:淘宝天猫商品搜索爬虫自动化工具(第一篇)
Python3中级玩家:淘宝天猫商品搜索爬虫自动化工具(第一篇) 淘宝改字段,Bugfix,查看https://github.com/hunterhug/taobaoscrapy.git 由于Gith ...
- 【Python3爬虫】常见反爬虫措施及解决办法(一)
这一篇博客,是关于反反爬虫的,我会分享一些我遇到的反爬虫的措施,并且会分享我自己的解决办法.如果能对你有什么帮助的话,麻烦点一下推荐啦. 一.UserAgent UserAgent中文名为用户代理,它 ...
- 爬虫---Beautiful Soup 反反爬虫事例
前两章简单的讲了Beautiful Soup的用法,在爬虫的过程中相信都遇到过一些反爬虫,如何跳过这些反爬虫呢?今天通过知乎网写一个简单的反爬中 什么是反爬虫 简单的说就是使用任何技术手段,阻止别人批 ...
- 极验反爬虫防护分析之slide验证方式下图片的处理及滑动轨迹的生成思路
本文要分享的内容是去年为了抢鞋而分析 极验(GeeTest)反爬虫防护的笔记,由于篇幅较长(为了多混点CB)我会按照我的分析顺序,分成如下四个主题与大家分享: 极验反爬虫防护分析之交互流程分析 极验反 ...
- 大型企业都在用的Python反爬虫手段,破了它!
SVG 映射反爬虫 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做案例的人,却不知道如何去学习更加高深的知识.那么针对这三类人 ...
- python爬虫实践(二)——爬取张艺谋导演的电影《影》的豆瓣影评并进行简单分析
学了爬虫之后,都只是爬取一些简单的小页面,觉得没意思,所以我现在准备爬取一下豆瓣上张艺谋导演的“影”的短评,存入数据库,并进行简单的分析和数据可视化,因为用到的只是比较多,所以写一篇博客当做笔记. 第 ...
随机推荐
- HTML5之contenteditable属性
HTML5之contenteditable属性 1.功能说明 (1)功能:允许用户编辑元素中的内容 (2)说明:是一个布尔值,false是不能编辑,true为可编辑 2.分析实例 (1)content ...
- MySQL查询所有数据库表出错
1.错误描述 1 queries executed, 0 success, 1 errors, 0 warnings 查询:show tables 错误代码: 1046 No database sel ...
- vue全局配置----小白基础篇
今天学习vue全局配置.希望帮助我们去了解vue的全局配置,快速开发. Vue.config是vue的全局配置对象.包含Vue的所有全局属性: silent:boolean(默认值:false)--- ...
- 关于这个该死的报错:TypeError - 'undefined' is not a function (evaluating '_getTagName(currWindow).toLowerCase()')
在利用Selenium爬取页面信息的时候突然报错,第一条信息爬取的时候还好好的,第二条就不行了. 请参考网上的爬取代码: # coding=utf-8"""Created ...
- Java并发系列[7]----CountDownLatch源码分析
CountDownLatch(闭锁)是一个很有用的工具类,利用它我们可以拦截一个或多个线程使其在某个条件成熟后再执行.它的内部提供了一个计数器,在构造闭锁时必须指定计数器的初始值,且计数器的初始值必须 ...
- Drying POJ - 3104
It is very hard to wash and especially to dry clothes in winter. But Jane is a very smart girl. She ...
- 论文笔记(8):BING: Binarized Normed Gradients for Objectness Estimation at 300fps
译文: <基于二值化赋范梯度特征的一般对象估计> 摘要: 通过训练通用的对象估计方法来产生一组候选对象窗口,能够加速传统的滑动窗口对象检测方法.我们观察到一般对象都会有定义完好的封闭轮廓, ...
- 【xsy2115】Delight for a Cat
Time Limit: 1000 ms Memory Limit: 512 MB Description 从前,有一只懒猫叫CJB.每个小时,这只猫要么在睡觉,要么在吃东西,但不能一边睡觉一边吃东 ...
- 使用Ant打包Web前台程序
概述 本文通过一个简单的Web项目作为例子描述如何用ANT完成Web前台程序的打包工作.包含文件拷贝.编译.打包三部分:完成这三部就可以得到一个War了,放到Tomcat下就可以运行了. ANT的安装 ...
- 如何修改Jmeter配置使能支持更大并发
Jmeter做并发测试时,报错 java.lang.OutOfMemoryError:gc overhead limit exceeded. 原因是jmeter默认分配内存的参数很小,256M吧.故而 ...