
爬虫---Beautiful Soup 反反爬虫事例
前两章简单的讲了Beautiful Soup的用法,在爬虫的过程中相信都遇到过一些反爬虫,如何跳过这些反爬虫呢?今天通过知乎网写一个简单的反爬中
什么是反爬虫
简单的说就是使用任何技术手段,阻止别人批量获取自己网站信息的一种方式。关键也在于批量。
反反爬虫机制
- 增加请求头---headers为了模拟更真实的用户场景
- 更改IP地址---网站会根据你的IP对网站访问频密,判断你是否属于爬虫
- ua限制---UA是用户访问网站时候的浏览器标识,其反爬机制与ip限制类似
- 模拟帐号登录----通过request模拟登录进行访问网站
- cookies的限制---网站页面每次请求的cookies不同
爬取知乎热榜
1.首先打开需要爬取的网站
2.分析网站的html,标签为’a‘,属性为target="_blank"
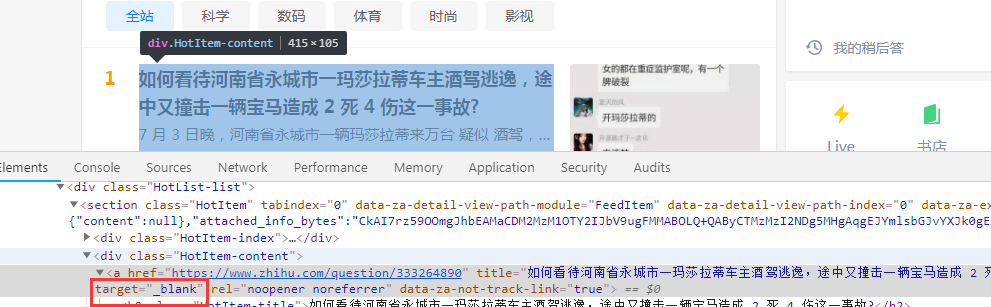
3.通过request方式进行请求网站
4.首先我们先不携带任何的反反爬虫机制进行访问
# coding:utf-8

import requests

from  bs4 import BeautifulSoup

url = 'https://www.zhihu.com/hot'

html = requests.get(url,verify = False).content.decode('utf-8') # verify = False表示请求https

soup = BeautifulSoup(html,'html.parser')

name = soup.find_all('a',target="_blank")

for i in name:

    print(i)
结果发现请求为空
5.从F12中提取出完整的请求头(也可以通过fiddler进行查看)
- 请求地址的host
- 请求的cookies
- 请求的User-Agent
# coding:utf-8

import requests

from  bs4 import BeautifulSoup

url = 'https://www.zhihu.com/hot'

# 添加请求头

headers={

    "host":"www.zhihu.com",

    "cookie":'_zap=482b5934-4878-4c78-84f9-893682c32b07; d_c0="ALCgSJhlsQ6PTpmYqrf51G'

             'HhiwoTIQIlS1w=|1545203069"; _xsrf=XrStkKiqUlLxzwMIqRDc01J7jikO4xby; q_c1=94622'

             '462a93a4238aafabad8c004bc41|1552532103000|1548396224000; __utma=51854390.1197068257.'

             '1552532107.1552532107.1552532107.1; __utmz=51854390.1552532107.1.1.utmcsr=zhihu.com|utmccn=(r'

             'eferral)|utmcmd=referral|utmcct=/; __utmv=51854390.100--|2=registration_date=20190314=1^3=entry_da'

             'te=20190125=1; z_c0="2|1:0|10:1552535646|4:z_c0|92:Mi4xcFRlN0RnQUFBQUFBc0tCSW1HV3hEaVlBQUFCZ0FsVk5Ya'

             'DUzWFFBWExTLXVpM3llZzhMb29QSmRtcjlKR3pRaTBB|03a1fa3d16c98e1688cdb5f6ba36082585d72af2f54597e370f05207'

             'cd3a873f"; __gads=ID=27a40a1873146c19:T=1555320108:S=ALNI_MYb5D7sBKFhvJj32HBQXgrhyC6xxQ; tgw_l7_route=7'

             '3af20938a97f63d9b695ad561c4c10c; tst=h; tshl=',

    "User-Agent":"Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.81 Safari/537.36",

}

html = requests.get(url,headers=headers,verify = False).content.decode('utf-8') # verify = False表示请求https

soup = BeautifulSoup(html,'html.parser')

name = soup.find_all('a',target="_blank")

for i in name:

    print(i.get_text())
执行后发现成功的把热榜下的一些信息请求出来
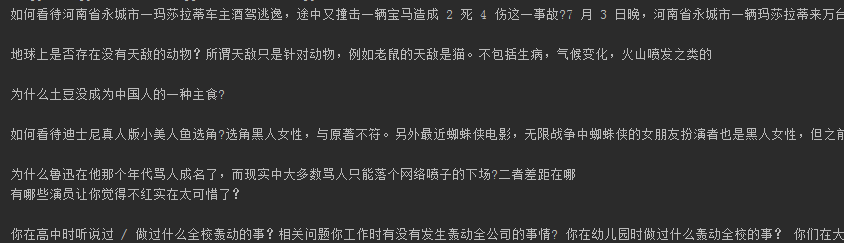
喜欢的小伙伴可以自己手动试一试。
爬虫---Beautiful Soup 反反爬虫事例的更多相关文章
- 使用Beautiful Soup编写一个爬虫 系列随笔汇总
这几篇博文只是为了记录学习Beautiful Soup的过程,不仅方便自己以后查看,也许能帮到同样在学习这个技术的朋友.通过学习Beautiful Soup基础知识 完成了一个简单的爬虫服务:从all ...
- 爬虫---Beautiful Soup 通过添加不同的IP请求
上一篇爬虫写了如何应付反爬的一些策略也简单的举了根据UA的例子,今天写一篇如何根据不同IP进行访问豆瓣网获取排行版 requests添加IP代理 如果使用代理的话可以通过requests中的方法pro ...
- 爬虫---Beautiful Soup 初始
我们在工作中,都会听说过爬虫,那么什么是爬虫呢? 什么是网络爬虫 爬虫基本原理 所谓网络爬虫就是一个自动化数据采集工具,你只要告诉它要采集哪些数据,丢给它一个 URL,就能自动地抓取数据了.其背后的基 ...
- 爬虫-Beautiful Soup模块
阅读目录 一 介绍 二 基本使用 三 遍历文档树 四 搜索文档树 五 修改文档树 六 总结 一 介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通 ...
- 爬虫---Beautiful Soup 爬取图片
上一篇简单的介绍Beautiful Soup 的基本用法,这一篇写下如何爬取网站上的图片,并保存下来 爬取图片 1.找到一个福利网站:http://www.xiaohuar.com/list-1-1. ...
- 100天搞定机器学习|Day21 Beautiful Soup
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 网络爬虫: 从allitebooks.com抓取书籍信息并从amazon.com抓取价格(1): 基础知识Beautiful Soup
开始学习网络数据挖掘方面的知识,首先从Beautiful Soup入手(Beautiful Soup是一个Python库,功能是从HTML和XML中解析数据),打算以三篇博文纪录学习Beautiful ...
- [转]python下很帅气的爬虫包 - Beautiful Soup 示例
原文地址http://blog.csdn.net/watsy/article/details/14161201 先发一下官方文档地址.http://www.crummy.com/software/Be ...
- Python爬虫利器:Beautiful Soup
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.使用它来处理HTML页面就像JavaScript代码操作HTML DOM树一样方便.官方中文文档地址 1. 安 ...
随机推荐
- 在python的虚拟环境venv中使用gunicorn
昨天遇到的问题,一个服务器上有好几个虚拟机环境. 我active进一个虚拟环境,安装了新的三方库之后, 使用gunicorn启动django服务, 但还是死活提示没有安装这个三方库. 一开始没有找到原 ...
- grep: /usr/include/php/main/php.h: No such file or directory
异常 grep: /usr/include/php/main/php.h: No such file or directory grep: /usr/include/php/Zend/zend_mod ...
- if选择结构
if的语法规则: if(布尔表达式){java语句} //只有一个java语句的时候可以省略大括号不建议这么写但是别人写的代码能看懂 if的写法有4种: if(){} if(){}else{} if( ...
- 关于join的使用
一.join的作用 join() 定义在Thread.java中.join() 的作用:让“主线程”等待“子线程”结束之后才能继续运行. // 主线程 public class Father exte ...
- 实验1c语言的开发环境使用和数据类型,运算符,表达式
#include<stdio.h> int main() { printf("); ; } /*求两个整数的乘积*/ #include<stdio.h> int pr ...
- Unity编辑器扩展学习 转载
https://www.xuanyusong.com/archives/category/unity/unity3deditor 1 using UnityEngine; public class T ...
- 第02组 Beta冲刺(2/5)
队名:無駄無駄 组长博客 作业博客 组员情况 张越洋 过去两天完成了哪些任务 数据库实践 提交记录(全组共用) 接下来的计划 加快校园百科的进度 还剩下哪些任务 学习软工的理论课 学习代码评估.测试 ...
- [NewLife.XCode]实体工厂(拦截处理实体操作)
NewLife.XCode是一个有10多年历史的开源数据中间件,支持nfx/netcore,由新生命团队(2002~2019)开发完成并维护至今,以下简称XCode. 整个系列教程会大量结合示例代码和 ...
- Oracle 存储过程包(Package、Package Body)
初出茅庐,不知原来存储过程还可以写得如此复杂,而且还竟然可以调试! 好吧,得整理一下存储过程的一些语法,以备以后用到时可以查阅. 使用数据库:Oracle 数据库工具:PL/SQL Developer ...
- 关于 NuGet 本地仓库、.NET Core 引用等实战