
4.2:Scrapy爬虫
使用Scrapy框架对网站的内容进行爬取
在桌面处打开终端,并在终端中输入:
scrapy startproject bitNews

cd bitNews/bitNews
修改items文件的内容,输入vim items.py按 i 进行编辑,将其中的代码修改为:
# -*- coding: utf-8 -*-

import scrapy

class BitnewsItem(scrapy.Item):

    # define the fields for your item here like:

    name = scrapy.Field()

    pass
按shift+zz 退出。在终端输入:
scrapy genspider bitnews "www.bit.edu.cn"

cd spiders

vim bitnews.py
修改代码为下图所示:
# -*- coding: utf-8 -*-

import scrapy

from bitNews.items import BitnewsItem

class BitnewsSpider(scrapy.Spider):

    name = 'bitnews'

    allowed_domains = ['www.bit.edu.cn']

    start_urls = ['http://www.bit.edu.cn/xww/jdgz/index.htm']

    def parse(self, response):

        items=[]

        div = response.xpath("//div[@class='new_con']")

        for each in div.xpath("ul/li"):

            item=BitnewsItem()

            item['name']=each.xpath('a/text()').extract()

            items.append(item)

        pass

        return items
保存退出之后,在终端输入:cd ..
修改settings.py:vim settings.py
找到ROBOTSTXT_OBEY的值改为False:并添加设置如下:
ROBOTSTXT_OBEY=False
FEED_EXPORT_ENCODING = "UTF-8"
保存退出后,终端输入:
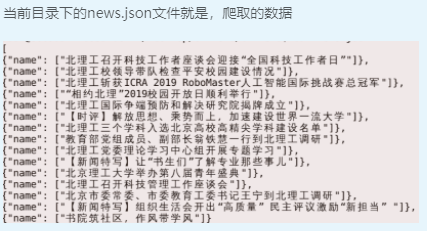
scrapy crawl bitnews -o news.json
4.2:Scrapy爬虫的更多相关文章
- scrapy爬虫结果插入mysql数据库
1.通过工具创建数据库scrapy
- Python之Scrapy爬虫框架安装及简单使用
题记:早已听闻python爬虫框架的大名.近些天学习了下其中的Scrapy爬虫框架,将自己理解的跟大家分享.有表述不当之处,望大神们斧正. 一.初窥Scrapy Scrapy是一个为了爬取网站数据,提 ...
- Linux搭建Scrapy爬虫集成开发环境
安装Python 下载地址:http://www.python.org/, Python 有 Python 2 和 Python 3 两个版本, 语法有些区别,ubuntu上自带了python2.7. ...
- Scrapy 爬虫
Scrapy 爬虫 使用指南 完全教程 scrapy note command 全局命令: startproject :在 project_name 文件夹下创建一个名为 project_name ...
- [Python爬虫] scrapy爬虫系列 <一>.安装及入门介绍
前面介绍了很多Selenium基于自动测试的Python爬虫程序,主要利用它的xpath语句,通过分析网页DOM树结构进行爬取内容,同时可以结合Phantomjs模拟浏览器进行鼠标或键盘操作.但是,更 ...
- 同时运行多个scrapy爬虫的几种方法(自定义scrapy项目命令)
试想一下,前面做的实验和例子都只有一个spider.然而,现实的开发的爬虫肯定不止一个.既然这样,那么就会有如下几个问题:1.在同一个项目中怎么创建多个爬虫的呢?2.多个爬虫的时候是怎么将他们运行起来 ...
- 如何让你的scrapy爬虫不再被ban之二(利用第三方平台crawlera做scrapy爬虫防屏蔽)
我们在做scrapy爬虫的时候,爬虫经常被ban是常态.然而前面的文章如何让你的scrapy爬虫不再被ban,介绍了scrapy爬虫防屏蔽的各种策略组合.前面采用的是禁用cookies.动态设置use ...
- 如何让你的scrapy爬虫不再被ban
前面用scrapy编写爬虫抓取了自己博客的内容并保存成json格式的数据(scrapy爬虫成长日记之创建工程-抽取数据-保存为json格式的数据)和写入数据库(scrapy爬虫成长日记之将抓取内容写入 ...
- scrapy爬虫成长日记之将抓取内容写入mysql数据库
前面小试了一下scrapy抓取博客园的博客(您可在此查看scrapy爬虫成长日记之创建工程-抽取数据-保存为json格式的数据),但是前面抓取的数据时保存为json格式的文本文件中的.这很显然不满足我 ...
- 【图文详解】scrapy爬虫与动态页面——爬取拉勾网职位信息(2)
上次挖了一个坑,今天终于填上了,还记得之前我们做的拉勾爬虫吗?那时我们实现了一页的爬取,今天让我们再接再厉,实现多页爬取,顺便实现职位和公司的关键词搜索功能. 之前的内容就不再介绍了,不熟悉的请一定要 ...
随机推荐
- 彻底掌握Makefile(二)
彻底掌握Makefile(二) 前言 在前面的文章彻底掌握Makefile(一)当中,我们简要的介绍了一些常见的makefile使用方法,在本篇文章当中我们将继续介绍一些makefile当中的常见用法 ...
- Docker 容器日志管理
Docker 日志分为两类: Docker 引擎日志(也就是 dockerd 运行时的日志), 容器的日志,容器内的服务产生的日志. 一 .Docker 引擎日志 Docker 引擎日志一般是交给了 ...
- 十大 CI/CD 安全风险(三)
在上一篇文章,我们了解了依赖链滥用和基于流水线的访问控制不足这两大安全风险,并给出缓解风险的安全建议.本篇文章将着重介绍 PPE 风险,并提供缓解相关风险的安全建议与实践. Poisoned Pipe ...
- TF-GNN踩坑记录(三)
引言 Batch size问题 在Tensorflow-GNN中使用batch size除了需要注意上面的链接问题之外,最近我在调试的发现,使用了merge_batch_to_components() ...
- 代码块及final关键字的使用
1.代码块的作用:用来初始化类.对象 2.代码块如果有修饰的话,只能使用static. 3.分类:静态代码块 vs 非静态代码块 4.静态代码块 内部可以有输出语句 随着类的加载而执行,而且只执行一次 ...
- Mysql索引(究极无敌细节版)
参考了: https://www.jianshu.com/p/ace3cd6526c4 推荐up主https://space.bilibili.com/377905911 推荐书籍<mysql是 ...
- 42.JSON Web Token认证
JSON Web Token认证介绍 简称JWT认证,一般用于用户认证 JWT是一种相当新的标准,可用于基于token的身份验证 与内置的TokenAuthentication方案不同,JWT不需要使 ...
- 事件循环Event Loop
在 事件循环 期间的某个时刻,运行时会从最先进入队列的消息开始处理队列中的消息.被处理的消息会被移出队列,并作为输入参数来调用与之关联的函数.正如前面所提到的,调用一个函数总是会为其创造一个新的栈帧. ...
- 一、Vue.js介绍
一.介绍 Vue (读音 /vjuː/,类似于 view) 是一套用于构建用户界面的渐进式框架.与其它大型框架不同的是,Vue 被设计为可以自底向上逐层应用.Vue 的核心库只关注视图层,不仅易于上手 ...
- linux重置密码
方法一: 进入grub菜单界面 按e键 在linux开头的行按ctrl+e 或者end跳到行尾,输入rd.break 按ctrl+x mount -o remount,rw /sysroot chro ...