
numpy简单入门
声明:本文大量参考https://www.dataquest.io/mission/6/getting-started-with-numpy(建议阅读原文)
读取文件
有一个名为world_alcohol.csv的文件,文件格式如下
|
Year,WHO region,Country,Beverage Types,Display Value 1986,Western Pacific,Viet Nam,Wine,0 1986,Americas,Uruguay,Other,0.5 1985,Africa,Cte d'Ivoire,Wine,1.62 |
文件内容的含义:(这是一份全球的饮料消耗记录表,第一列的意思是记录的年份,第二列指的是饮料的出产地,第三列指的是饮料的消耗地,第四列指的是饮料的类型,第五列指的是饮料的每人平均消耗量)
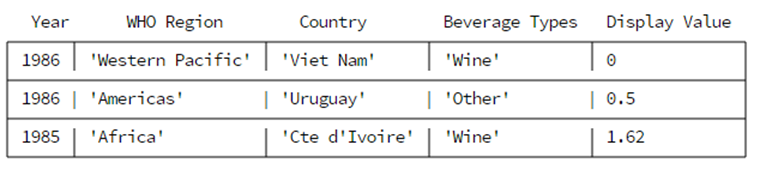
现在使用numpy的genfromtxt()函数来读取该文件,delimiter参数是用来指定每一行用来分隔数据的分隔符
import numpy

world_alcohol = numpy.genfromtxt('world_alcohol.csv', delimiter=',')

print(world_alcohol)
此时读取到的内容如下:
|
[[ nan nan nan nan nan] [ 1.98600000e+03 nan nan nan 0.00000000e+00] [ 1.98600000e+03 nan nan nan 5.00000000e-01] ..., [ 1.98600000e+03 nan nan nan 2.54000000e+00] [ 1.98700000e+03 nan nan nan 0.00000000e+00] [ 1.98600000e+03 nan nan nan 5.15000000e+00]] |
这是因为numpy在读取元素时,默认是按照float格式来读取的,对于不能转换为float类型的数据会读取为nan(not a number),对于留空的数据则显示为na(not available),为了正确的读取数据,可以通过增加参数:
- dtype参数用来指定读取数据的格式,这里的U75表示将每一个数据都读取为75个byte的unicode数据格式
- skip_header参数用来跳过文件的第一行
- delimiter参数用来指定每行数据的分隔符
import numpy

world_alcohol = numpy.genfromtxt('world_alcohol.csv', dtype='U75', skip_header=True, delimiter=',')

print(world_alcohol)
数组
可以通过array()函数来创建一个数组,在这里向量指的是变量只有一个列表,矩阵指的是具有多个列表的列表
创建一个向量:vector = numpy.array([10, 20, 30])
创建一个矩阵:matrix = numpy.array([[5,10,15],[20,25,30],[35,40,45]])
数组的属性:
- shape属性描述了该数组的结构
- dtype属性描述了元素的数据类型
|
print(vector.shape) 输出结果: (3,) 这是一个元组,表示vector变量是一个只有一行的向量,具有3个元素 print(matrix.shape) 输出结果: (3,3)表示matrix变量是一个3 × 3的矩阵,具有3行3列共9个元素 |
|
print(vector.shape) 输出结果: int64 |
数据类型大致有以下几种:
- bool -- 布尔类型,True或者False
- int -- 整型,分为int16, int32, int64,后面的数字表明数值的长度
- float -- 浮点型,分为float16, float32, float64,后面的数字表明数值的长度
- string -- 字符串类型,分为string或者unicode,它们的差异在于存储字符的方式
索引和分片
谨记一点:数组的索引是从0开始的
matrix = numpy.array([

       [5,10,15],

       [20,25,30],

       [35,40,45]

       ])

print(matrix[1][1])  # 两种方式都可以索引数据,输出结果都是25,注意这里索引的是第二行第二个

print(matrix[1,1])
可以类似于使用切片来操作数据(将切片操作符 : 理解为‘全部’)
print(matrix[:,0]) # 输出全部行,第一列的数据 [ 5 20 35]

print(matrix[0,:]) # 输出第一行,全部列的数据 [ 5 10 15]

print(matrix[:,0:2]) # 输出全部行,前2列的数据[  [5, 10],  [20, 25],  [35, 40]  ]

print(matrix[1:3,:]) # 输出第2和第3行的全部列的数据 [  [20, 25, 30],  [35, 40, 45]  ]

print(matrix[1:3,1]) # 输出第2,3行的第1列数据 [ [10],  [25] ]
数组比较
将数组与一个值相比较的时候,实际上是把数组内的每个值都与该值比较,然后返回一个布尔值列表
vector = numpy.array([5, 10, 15, 20])

vector == 10

返回的是:[False, True, False, False]
对于矩阵也如此
matrix = numpy.array([

                    [5, 10, 15],

                    [20, 25, 30],

                    [35, 40, 45]

                 ])

matrix == 25

结果如下:[

    [False, False, False],

    [False, True,  False],

    [False, False, False]

]
数组比较中还可以使用多条件
vector = numpy.array([5, 10, 15, 20])

equal_to_ten_and_five = (vector == 10) & (vector == 5)

输出:[False, False, False, False]

equal_to_ten_or_five = (vector == 10) | (vector == 5)

输出:[True, True, False, False]
数组比较的最大用处是
一、用来选择数组或矩阵中的元素
matrix = numpy.array([

                [5, 10, 15],

                [20, 25, 30],

                [35, 40, 45]

             ])

    second_column_25 = (matrix[:,1] == 25)

print(matrix[second_column_25, :])

作用:提取出matrix中第二列中等于25的所有行,结果为[20, 25, 30]
二、替换元素
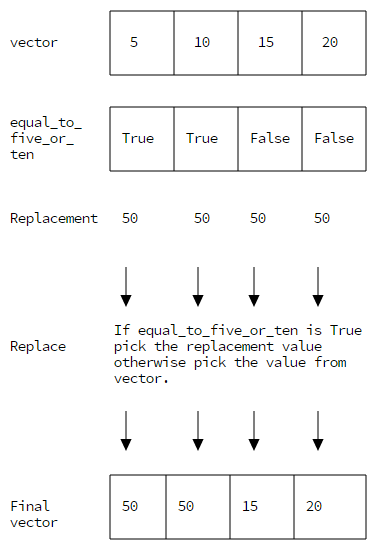
vector = numpy.array([5, 10, 15, 20])

equal_to_ten_or_five = (vector == 10) | (vector == 5)

vector[equal_to_ten_or_five] = 50

print(vector)

输出:[50, 50, 15, 20]
原理如下:
常用于替换空元素
譬如将world_alcohol中的第五列中的留空的数据都替换为字符串0:
is_value_empty = world_alcohol[:, 4] == ' '

world_alcohol[is_value_empty, 4] = '0'
数据类型转换
通过使用astype()函数来转换一个数组的数据类型
vector = numpy.array(["1", "2", "3"])

vector = vector.astype(float)

print(vector)

结果:[1.0, 2.0, 3.0]
简单的运算
参考numpy的手册:http://docs.scipy.org/doc/numpy-1.10.1/index.html
挑出几个重要的运算函数:
- l sum() -- 计算一个向量中的全部元素的总和,或者是一个矩阵中的一个维度的总和
- l mean() -- 同上,计算的是平均值
- l max() -- 同上,计算的是最大值
vector = numpy.array([5, 10, 15, 20])

vector.sum()

结果为:50

matrix = numpy.array([

                [5, 10, 15],

                [20, 25, 30],

                [35, 40, 45]

             ])

matrix.sum(axis=1)

结果:[30, 75, 120]

对于矩阵来说,需要指定axis参数,该参数等于1时表示计算的是每行,等于0时表示计算的是每列的总和
练习
使用world_alcohol.csv文件,计算在1986年里每个国家的饮料消耗量
import numpy

world_alcohol = numpy.genfromtxt('world_alcohol.csv', dtype='U75', skip_header=True, delimiter=',')

totals = {}

year = world_alcohol[world_alcohol[:, 0] == '1989', :]  # 选择1989年的数据集

countries = set(world_alcohol[:,2])  # 选择全部国家

for each in countries: # 分别计算每个国家

    consumption = year[year[:,2] == each, :]

    consumption[consumption[:, 4] == '',4] = '0'

    temp = consumption[:,4].astype(float)  # 将留空的数据转变为浮点数0参与运算

    country_consumption = temp.sum()

    totals[each] = country_consumption
总结
使用numpy的比直接对一个列表集合的运算更加方便,主要优于以下几点:
- 更容易对数据进行计算
- 可以快速地进行数据索引和分片
- 可以快速地转换数据类型
然而,numpy有一些不足之处:
- 在同一个数据集中的数据必须具有相同的数据类型,在处理多数据集时会变得很困难
- 行和列都需要使用数字来索引,而不能使用别名,这样容易造成混淆
而Pandas解决了Numpy的几点不足
numpy简单入门的更多相关文章
- NumPy简单入门教程
# NumPy简单入门教程 NumPy是Python中的一个运算速度非常快的一个数学库,它非常重视数组.它允许你在Python中进行向量和矩阵计算,并且由于许多底层函数实际上是用C编写的,因此你可以体 ...
- 初学Python之爬虫的简单入门
初学Python之爬虫的简单入门 一.什么是爬虫? 1.简单介绍爬虫 爬虫的全称为网络爬虫,简称爬虫,别名有网络机器人,网络蜘蛛等等. 网络爬虫是一种自动获取网页内容的程序,为搜索引擎提供了重要的 ...
- 用IntelliJ IDEA创建Gradle项目简单入门
Gradle和Maven一样,是Java用得最多的构建工具之一,在Maven之前,解决jar包引用的问题真是令人抓狂,有了Maven后日子就好过起来了,而现在又有了Gradle,Maven有的功能它都 ...
- [原创]MYSQL的简单入门
MYSQL简单入门: 查询库名称:show databases; information_schema mysql test 2:创建库 create database 库名 DEFAULT CHAR ...
- Okio 1.9简单入门
Okio 1.9简单入门 Okio库是由square公司开发的,补充了java.io和java.nio的不足,更加方便,快速的访问.存储和处理你的数据.而OkHttp的底层也使用该库作为支持. 该库极 ...
- emacs最简单入门,只要10分钟
macs最简单入门,只要10分钟 windwiny @2013 无聊的时候又看到鼓吹emacs的文章,以前也有几次想尝试,结果都是玩不到10分钟就退出删除了. 这次硬着头皮,打开几篇文章都看完 ...
- 【java开发系列】—— spring简单入门示例
1 JDK安装 2 Struts2简单入门示例 前言 作为入门级的记录帖,没有过多的技术含量,简单的搭建配置框架而已.这次讲到spring,这个应该是SSH中的重量级框架,它主要包含两个内容:控制反转 ...
- Docker 简单入门
Docker 简单入门 http://blog.csdn.net/samxx8/article/details/38946737
- Springmvc整合tiles框架简单入门示例(maven)
Springmvc整合tiles框架简单入门示例(maven) 本教程基于Springmvc,spring mvc和maven怎么弄就不具体说了,这边就只简单说tiles框架的整合. 先贴上源码(免积 ...
随机推荐
- 使用Loadrunner进行接口测试
在工作中很多时候都需要进行接口测试,如果只是进行接口的功能测试这个很简单,两种类型: 1.如果是基于get的直接使用浏览器进行访问,查看服务器返回的数据是否正确就行, 2.如果是基于post的可以接触 ...
- 小白日记22:kali渗透测试之提权(二)--抓包嗅探
抓包嗅探 通过抓包嗅探目标机器的流量,发现账号密码. Windows系统 1.Wirehshark 2.Omnipeek 3.commview 4.Sniffpass 只会抓取识别传输密码的明文协议, ...
- 炼数成金hadoop视频干货06-10
视频地址:http://pan.baidu.com/s/1dDEgKwD 第六课统讲了hadoop几个子项目和HBase,第七课还是讲的HBase 第八课讲了PIG 第九课讲了Hive和Zookeep ...
- SSIS 学习(1): 概要【转】
俗话说:“十年磨一剑”,Microsoft 通过5年时间的精心打造,于2005年浓重推出Sql Server 2005,这是自SQL Server 2000 以 后的又一旷世之作.这套企业级的数据库解 ...
- ArcGIS Server 10.2 实战(四)格栅动态配色服务
当你的地理处理服务输出的是格栅,那个不可避免地需要为格栅的各类型数据添加不同色彩进行区分,而默认时格栅的色彩是随机的,或者固定死一套着色方案是也显得不够人性化,难以满足多样的客户需求,下面谈谈如何解决 ...
- [转]oracle EBS 基础100问
from:http://www.cnblogs.com/xiaoL/p/3593691.html http://f.dataguru.cn/thread-51057-1-1.html 1001 OR ...
- SqlServer之游标深入
原创文章,转载必需注明出处:http://www.ncloud.hk/%E6%8A%80%E6%9C%AF%E5%88%86%E4%BA%AB/introduce-for-sqlserver-curs ...
- 关于64位Linux编译hadoop2
Apache官方提供hadoop2的安装包是在32位机器下编译的,生产环境一般使用64的Linux,那么需要在64位机器下重新编译可以查看hadoop-2.2.0-src下的BUILDING.txtB ...
- Wince 中的图形编程
图形编程程序当中,笔者主要要和大家讨论的是画刷的创建和使用以及绘图函数,比如2D图像的绘制等等. *画刷的定义: HBRUSH hBrush; *画刷的类型: 1. 系统内置画刷:GetStockOb ...
- COGS 265 线段覆盖
265. 线段覆盖 ★★☆ 输入文件:xdfg.in 输出文件:xdfg.out 简单对比时间限制:2 s 内存限制:20 MB [问题描述] 有一根长度为 L 的白色条状物.有两种操 ...