
spark自定义分区器实现
在spark中,框架默认使用的事hashPartitioner分区器进行对rdd分区,但是实际生产中,往往使用spark自带的分区器会产生数据倾斜等原因,这个时候就需要我们自定义分区,按照我们指定的字段进行分区。具体的流程步骤如下:
1、创建一个自定义的分区类,并继承Partitioner,注意这个partitioner是spark的partitioner
2、重写partitioner中的方法
  override def numPartitions: Int = ???
   override def getPartition(key: Any): Int = ???

代码实现:
测试数据集:
cookieid,createtime,pv

cookie1,2015-04-10,1

cookie1,2015-04-11,5

cookie1,2015-04-12,7

cookie1,2015-04-13,3

cookie1,2015-04-14,2

cookie1,2015-04-15,4

cookie1,2015-04-16,4

cookie2,2015-04-10,2

cookie2,2015-04-11,3

cookie2,2015-04-12,5

cookie2,2015-04-13,6

cookie2,2015-04-14,3

cookie2,2015-04-15,9

cookie2,2015-04-16,7
指定按照第一个字段进行分区
步骤1:
package _core.sourceCodeLearning.partitioner

import org.apache.spark.Partitioner

import scala.collection.mutable.HashMap

/**

  * Author Mr. Guo

  * Create 2019/6/23 - 12:19

  */

class UDFPartitioner(args: Array[String]) extends Partitioner {

  private val partitionMap: HashMap[String, Int] = new HashMap[String, Int]()

  var parId = 0

  for (arg <- args) {

    if (!partitionMap.contains(arg)) {

      partitionMap(arg) = parId

      parId += 1

    }

  }

  override def numPartitions: Int = partitionMap.valuesIterator.length

  override def getPartition(key: Any): Int = {

    val keys: String = key.asInstanceOf[String]

    val sub = keys

    partitionMap(sub)

  }

}
步骤2:
主类测试:
package _core.sourceCodeLearning.partitioner

import org.apache.spark.{SparkConf, TaskContext}

import org.apache.spark.sql.SparkSession

/**

  * Author Mr. Guo

  * Create 2019/6/23 - 12:21

  */

object UDFPartitionerMain {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local[2]").setAppName(this.getClass.getSimpleName)

    val ssc = SparkSession

      .builder()

      .config(conf)

      .getOrCreate()

    val sc = ssc.sparkContext

    sc.setLogLevel("WARN")

    val rdd = ssc.sparkContext.textFile("file:///E:\\TestFile\\analyfuncdata.txt")

    val transform = rdd.filter(_.split(",").length == 3).map(x => {

      val arr = x.split(",")

      (arr(0), (arr(1), arr(2)))

    })

    val keys: Array[String] = transform.map(_._1).collect()

    val partiion = transform.partitionBy(new UDFPartitioner(keys))

    partiion.foreachPartition(iter => {

      println(s"**********分区号:${TaskContext.getPartitionId()}***************")

      iter.foreach(r => {

        println(s"分区:${TaskContext.getPartitionId()}###" + r._1 + "\t" + r._2 + "::" + r._2._1)

      })

    })

    ssc.stop()

  }

}
运行结果:
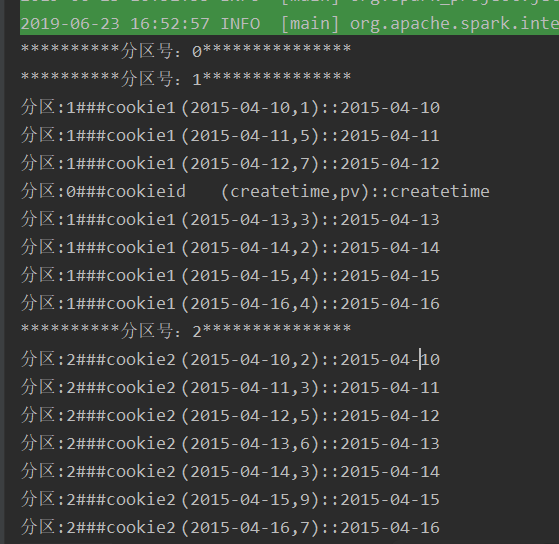
这样就是按照第一个字段进行了分区,当然在分区器的中,对于key是可以根据自己的需求随意的处理,比如添加随机数等等
spark自定义分区器实现的更多相关文章
- Spark自定义分区(Partitioner)
我们都知道Spark内部提供了HashPartitioner和RangePartitioner两种分区策略,这两种分区策略在很多情况下都适合我们的场景.但是有些情况下,Spark内部不能符合咱们的需求 ...
- MapReduce之自定义分区器Partitioner
@ 目录 问题引出 默认Partitioner分区 自定义Partitioner步骤 Partition分区案例实操 分区总结 问题引出 要求将统计结果按照条件输出到不同文件中(分区). 比如:将统计 ...
- kafka 自定义分区器
package cn.xiaojf.kafka.producer; import org.apache.kafka.clients.producer.Partitioner; import org.a ...
- Spark源码分析之分区器的作用
最近因为手抖,在Spark中给自己挖了一个数据倾斜的坑.为了解决这个问题,顺便研究了下Spark分区器的原理,趁着周末加班总结一下~ 先说说数据倾斜 数据倾斜是指Spark中的RDD在计算的时候,每个 ...
- RDD(六)——分区器
RDD的分区器 Spark目前支持Hash分区和Range分区,用户也可以自定义分区,Hash分区为当前的默认分区,Spark中分区器直接决定了RDD中分区的个数.RDD中每条数据经过Shuffle过 ...
- 聊聊Spark的分区、并行度 —— 前奏篇
通过之前的文章[Spark RDD详解],大家应该了解到Spark会通过DAG将一个Spark job中用到的所有RDD划分为不同的stage,每个stage内部都会有很多子任务处理数据,而每个sta ...
- 玩转Kafka的生产者——分区器与多线程
上篇文章学习kafka的基本安装和基础概念,本文主要是学习kafka的常用API.其中包括生产者和消费者, 多线程生产者,多线程消费者,自定义分区等,当然还包括一些避坑指南. 首发于个人网站:链接地址 ...
- kafka producer partitions分区器(七)
消息在经过拦截器.序列化后,就需要确定它发往哪个分区,如果在ProducerRecord中指定了partition字段,那么就不再需要partitioner分区器进行分区了,如果没有指定,那么会根据k ...
- Kafka的接口回调 +自定义分区、拦截器
一.接口回调+自定义分区 1.接口回调:在使用消费者的send方法时添加Callback回调 producer.send(new ProducerRecord<String, String> ...
随机推荐
- cordova插件值 二维码扫描
插件地址 https://github.com/gizwits/cordova-gizwits-scan-qrcode 插件安装方式 cordova plugin add https://github ...
- css3 新特性(2D translate 移动,rotate 旋转 , scale 缩放)
1.transform(转换)可以实现元素的位移,旋转,缩放等效果(可以简单理解为变形) 移动:translate 旋转:rotate 缩放:scale 2. ...
- js 禁止右击保存图片,禁止拖拽图片
禁止鼠标右键保存图片 <img src="" oncontextmenu="return false;"> 禁止鼠标拖动图片 <img src ...
- frp使用(windows+aliyun-windows)
下载frp:https://github.com/fatedier/frp/releases/ 解压,修改服务端配置文件:frps.ini:如下: [common] # 设置连接端口 bind_por ...
- Mysql差集
记录一个去差集的SQL 今天用sql去同步部分历史数据,需要用到一个求差集的sql 两张表简单结构如下: 有一个会员表 一个会员账户表 获取没有账户的会员 SELECT m.pkMember FROM ...
- redis-布隆过滤器使用
占用空间测试地址 https://krisives.github.io/bloom-calculator/
- nodejs进阶:密码加盐:随机盐值
demo var crypto = require('crypto'); function getRandomSalt(){ return Math.random().toString().slice ...
- react 脚手架使用
下载脚手架 npm i react create-react-app //下载安装脚手架 create-react-app pro_nmae //创建一个react项目 尽量不要使用大写,因为在Lin ...
- 页面background不随滚动条填充颜色
这我又遇到了个问题,这问题我连问都不知道该怎么问,先搁在这儿,如果有办法了,再来补充. 原因:因为颜色板块是100%宽度,和页面保持同宽,所以拖动滚动条,右侧就大于了页面宽度. bug: 我写页面的 ...
- @staticmethod和@classmethod区别
转载自: https://www.cnblogs.com/wyongbo/p/python_static_method.html https://www.cnblogs.com/champaign/p ...