
2003031121-浦娟-python数据分析五一假期作业
| 项目 | 内容 |
| 课程班级博客链接 | 20级数据班(本) |
| 这个作业要求链接 | Python作业 |
| 博客名称 | 2003031121-浦娟-python数据分析五一假期作业 |
| 要求 | 每道题要有题目,代码(使用插入代码,不会插入代码的自己查资料解决,不要直接截图代码!!),截图(只截运行结果)。 |
作业:
把期中考试代码看懂、运行并调通,要求每一行 或 每个重要功能写上注释。
一、分析1996~2015年人口数据特征间的关系
import numpy as np

import matplotlib.pyplot as plt

#使⽤numpy库读取数据

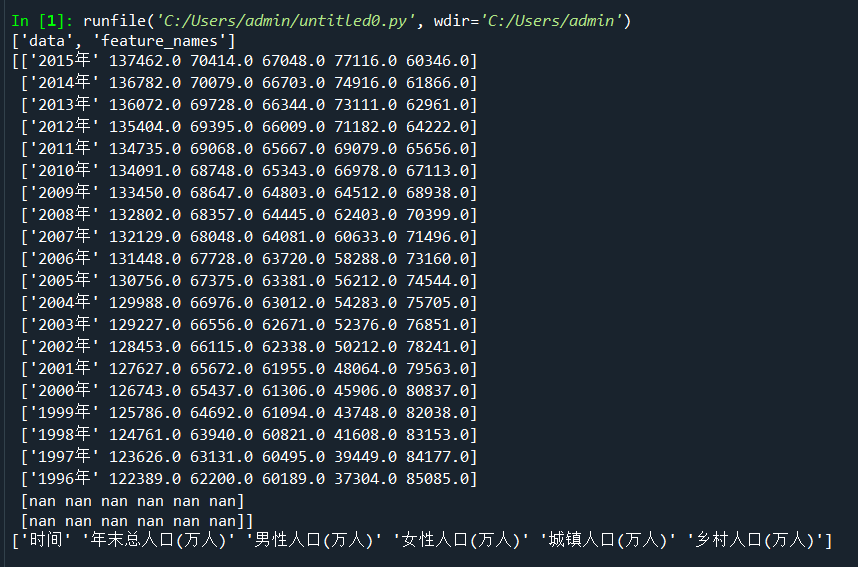
data=np.load('E:/桌面/populations.npz',allow_pickle=True)

print(data.files)#查看⽂件中的数组

print(data['data'])

print(data['feature_names'])

plt.rcParams['font.sans-serif'] = 'SimHei' # 设置中文显示

plt.rcParams['axes.unicode_minus'] = False# 防止字符无法显示

name=data['feature_names']#提取其中的feature_names数组,视为数据的标签

values=data['data']#提取其中的data数组,视为数据的存在位置

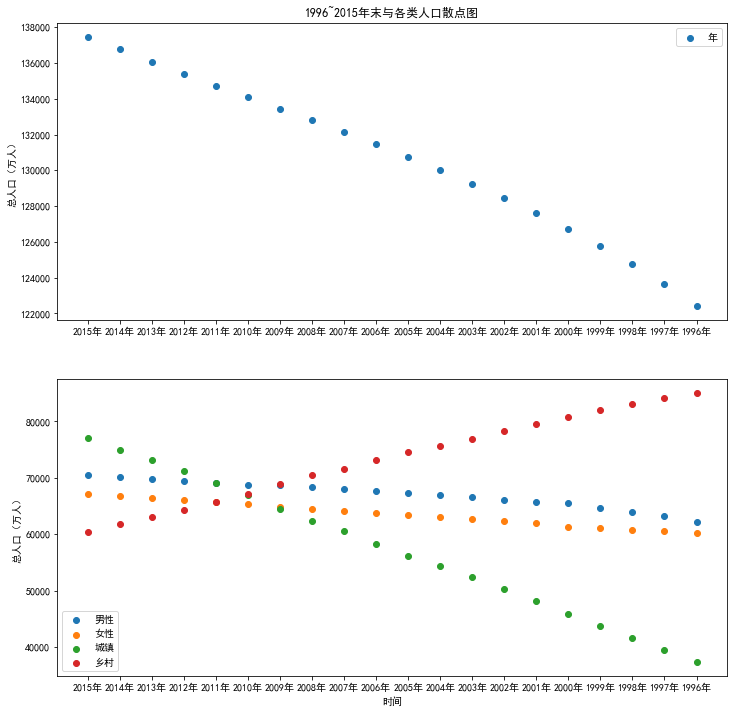
p1=plt.figure(figsize=(12,12))#确定画布大小

pip1=p1.add_subplot(2,1,1)#创建一个两行个一列的图并开始绘制

#在子图上绘制散点图

plt.scatter(values[0:20,0],values[0:20,1])#,marker='8',color='red'

plt.ylabel('总人口(万人)')

plt.legend('年末')

plt.title('1996~2015年末与各类人口散点图')

pip2=p1.add_subplot(2,1,2)#绘制图2

plt.scatter(values[0:20,0],values[0:20,2])#,marker='o',color='yellow'

plt.scatter(values[0:20,0],values[0:20,3])#,marker='D',color='green'

plt.scatter(values[0:20,0],values[0:20,4])#,marker='p',color='blue'

plt.scatter(values[0:20,0],values[0:20,5])#,marker='s',color='purple'

plt.xlabel('时间')

plt.ylabel('总人口(万人)')

plt.xticks(values[0:20,0])

plt.legend(['男性','女性','城镇','乡村'])

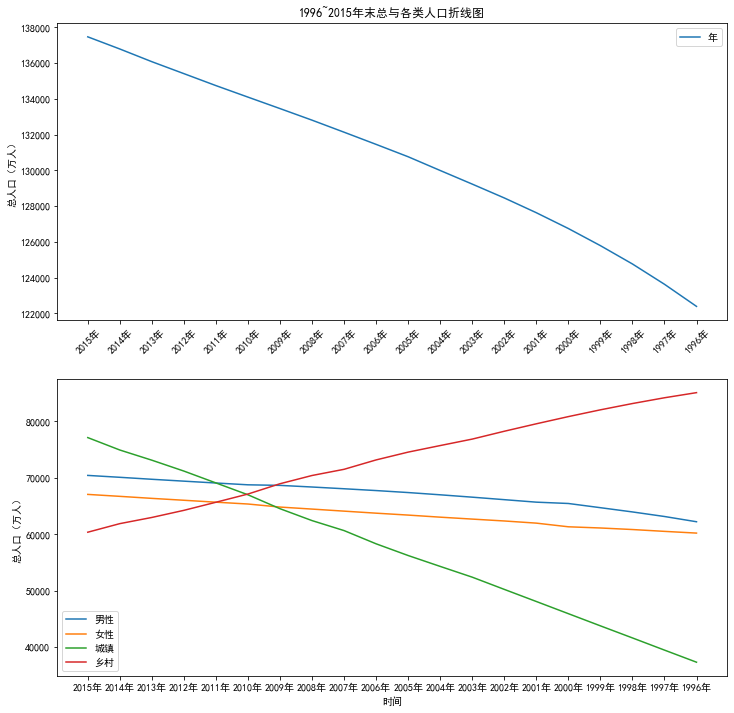
#在⼦图上绘制折线图

p2=plt.figure(figsize=(12,12))

p1=p2.add_subplot(2,1,1)

plt.plot(values[0:20,0],values[0:20,1])#,linestyle = '-',color='r',marker='8'

plt.ylabel('总人口(万人)')

plt.xticks(range(0,20,1),values[range(0,20,1),0],rotation=45)#rotation设置倾斜度

plt.legend('年末')

plt.title('1996~2015年末总与各类人口折线图')

p2=p2.add_subplot(2,1,2)

plt.plot(values[0:20,0],values[0:20,2])#,'y-'

plt.plot(values[0:20,0],values[0:20,3])#,'g-.'

plt.plot(values[0:20,0],values[0:20,4])#,'b-'

plt.plot(values[0:20,0],values[0:20,5])#,'p-'

plt.xlabel('时间')

plt.ylabel('总人口(万人)')

plt.xticks(values[0:20,0])

plt.legend(['男性','女性','城镇','乡村'])

#显示图片

plt.show()
二、读取并查看P2P网络贷款数据主表的基本信息
import os

import pandas as pd

master = pd.read_csv('E:/桌面/Training_Master .csv',encoding='gbk')

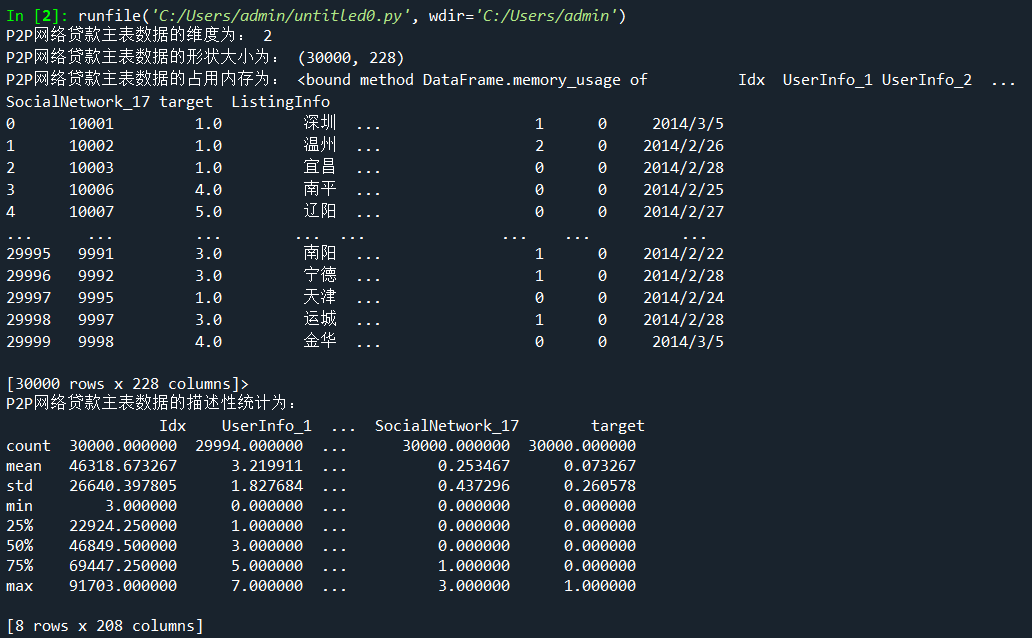
print('P2P网络贷款主表数据的维度为:',master.ndim)

print('P2P网络贷款主表数据的形状大小为:',master.shape)

print('P2P网络贷款主表数据的占用内存为:',master.memory_usage)

print('P2P网络贷款主表数据的描述性统计为:\n',master.describe())
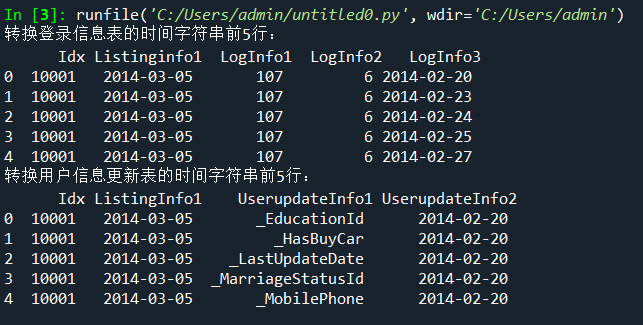
三、提取用户信息更新表和登录信息表的时间信息
import pandas as pd

LogInfo  = pd.read_csv('E:/桌面/Training_LogInfo .csv',encoding='gbk')

Userupdate   = pd.read_csv('E:/桌面/Training_Userupdate.csv',encoding='gbk')

# 转换时间字符串

LogInfo['Listinginfo1']=pd.to_datetime(LogInfo['Listinginfo1'])

LogInfo['LogInfo3']=pd.to_datetime(LogInfo['LogInfo3'])

print('转换登录信息表的时间字符串前5行:\n',LogInfo.head())

Userupdate['ListingInfo1']=pd.to_datetime(Userupdate['ListingInfo1'])

Userupdate['UserupdateInfo2']=pd.to_datetime(Userupdate['UserupdateInfo2'])

print('转换用户信息更新表的时间字符串前5行:\n',Userupdate.head())
四、使用分组聚合方法进一步分析用户信息更新表和登录信息表
import pandas as pd

import numpy as np

LogInfo  = pd.read_csv('E:/桌面/Training_LogInfo .csv',encoding='gbk')

Userupdate   = pd.read_csv('E:/桌面/Training_Userupdate.csv',encoding='gbk')

# 使用groupby方法对用户信息更新表和登录信息表进行分组

LogGroup = LogInfo[['Idx','LogInfo3']].groupby(by = 'Idx')

UserGroup = Userupdate[['Idx','UserupdateInfo2']].groupby(by = 'Idx')

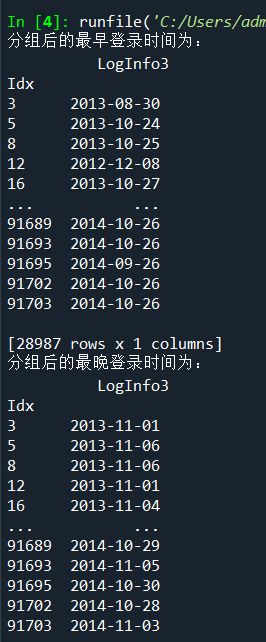
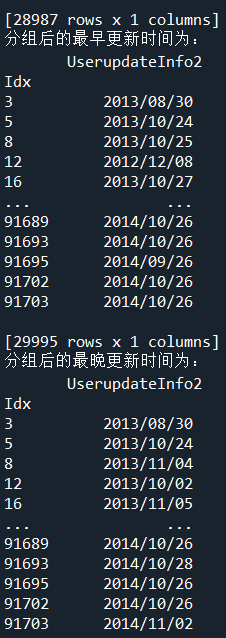
# 使用agg方法求取分组后的最早,最晚,更新登录时间

print('分组后的最早登录时间为:\n',LogGroup.agg(np.min))

print('分组后的最晚登录时间为:\n',LogGroup.agg(np.max))

print('分组后的最早更新时间为:\n',UserGroup.agg(np.min))

print('分组后的最晚更新时间为:\n',UserGroup.agg(np.max))

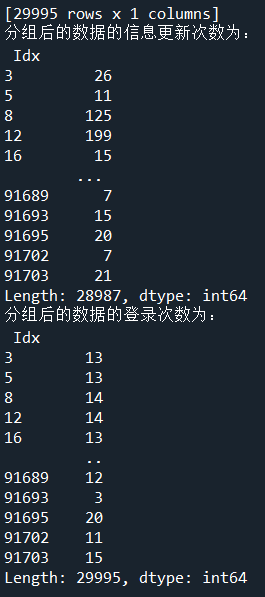
# 使用size方法求取分组后的数据的信息更新次数与登录次数

print('分组后的数据的信息更新次数为:\n',LogGroup.size())

print('分组后的数据的登录次数为:\n',UserGroup.size())
2003031121-浦娟-python数据分析五一假期作业的更多相关文章
- 2003031121——浦娟——Python数据分析第七周作业——MySQL的安装及使用
项目 要求 课程班级博客链接 20级数据班(本) 作业要求链接 Python第七周作业 博客名称 2003031121--浦娟--Python数据分析第七周作业--MySQL的安装及使用 要求 每道题 ...
- 2003031121-浦娟-python数据分析第四周作业-第二次作业
项目 内容 课程班级博客链接 20级数据班(本) 作业链接 Python第四周作业第二次作业 博客名称 2003031121-浦娟-python数据分析第四周作业-matolotlib的应用 要求 每 ...
- 2003031121-浦娟-python数据分析第三周作业-第一次作业
项目 内容 课程班级博客链接 https://edu.cnblogs.com/campus/pexy/20sj 作业链接 https://edu.cnblogs.com/campus/pexy/20s ...
- Python 数据分析(二 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识
Python 数据分析(二) 本实验将学习利用 Python 数据聚合与分组运算,时间序列,金融与经济数据应用等相关知识 第1节 groupby 技术 第2节 数据聚合 第3节 分组级运算和转换 第4 ...
- Python数据分析(二): Numpy技巧 (2/4)
numpy.pandas.matplotlib(+seaborn)是python数据分析/机器学习的基本工具. numpy的内容特别丰富,我这里只能介绍一下比较常见的方法和属性. 昨天晚上发了第一 ...
- Python数据分析(二): Numpy技巧 (3/4)
numpy.pandas.matplotlib(+seaborn)是python数据分析/机器学习的基本工具. numpy的内容特别丰富,我这里只能介绍一下比较常见的方法和属性. 昨天晚上发了第一 ...
- 零基础学习Python数据分析
网上虽然有很多Python学习的教程,但是大多是围绕Python网页开发等展开.数据分析所需要的Python技能和网页开发等差别非常大,本人就是浪费了很多时间来看这些博客.书籍.所以就有了本文,希望能 ...
- [Python数据分析]新股破板买入,赚钱几率如何?
这是本人一直比较好奇的问题,网上没搜到,最近在看python数据分析,正好自己动手做一下试试.作者对于python是零基础,需要从头学起. 在写本文时,作者也没有完成这个小分析目标,边学边做吧. == ...
- 【Python数据分析】Python3多线程并发网络爬虫-以豆瓣图书Top250为例
基于上两篇文章的工作 [Python数据分析]Python3操作Excel-以豆瓣图书Top250为例 [Python数据分析]Python3操作Excel(二) 一些问题的解决与优化 已经正确地实现 ...
随机推荐
- Dubbo 如何优雅停机?
Dubbo 是通过 JDK 的 ShutdownHook 来完成优雅停机的,所以如果使用 kill -9 PID 等强制关闭指令,是不会执行优雅停机的,只有通过 kill PID 时,才 会执行.
- 为什么 wait 和 notify 方法要在同步块中调用?
Java API 强制要求这样做,如果你不这么做,你的代码会抛出 IllegalMonitorStateException 异常.还有一个原因是为了避免 wait 和 notify 之间产生竞态条件.
- 比较一下 Java 和 JavaSciprt?
JavaScript 与 Java 是两个公司开发的不同的两个产品.Java 是原 Sun Microsystems 公司推出的面向对象的程序设计语言,特别适合于互联网应用程序 开发:而 JavaSc ...
- List、Set、Map详解及区别
一.List接口 List是一个继承于Collection的接口,即List是集合中的一种.List是有序的队列,List中的每一个元素都有一个索引:第一个元素的索引值是0,往后的元素的索引值依次+1 ...
- 面试问题之数据库:SQL优化的具体操作
转载于:https://www.cnblogs.com/wangzhengyu/p/10412499.html SQL优化的具体操作: 1.尽量避免使用select *,返回无用的字段会降低查询效率. ...
- 详细描述一下 Elasticsearch 索引文档的过程 ?
这里的索引文档应该理解为文档写入 ES,创建索引的过程. 文档写入包含:单文档写入和批量 bulk 写入,这里只解释一下:单文档写入流程. 记住官方文档中的这个图. 第一步:客户写集群某节点写入数据, ...
- spring boot 实现优雅的关闭
1.导入jar包 <dependency> <groupId>org.springframework.boot</groupId> <artifactId&g ...
- C++大作业——教职工管理系统
教职工信息管理系统 1.问题描述: 设计一个学校职工管理系统,要求实现如下功能:建立职工信息数据, 包括职工编号.姓名. 性别.工资.出生时间.岗位.参加工作时间和年 龄(必须计算得到),初始模拟数据 ...
- Hive启动后show tables报错:Unable to instantiate org.apache.hadoop.hive.ql.metadata.SessionHiveMetaStoreClient
错误详情: FAILED: HiveException java.lang.RuntimeException: Unable to instantiate org.apache.hadoop.hive ...
- 搭建 LNMP 环境
搭建 LNMP 环境 搭建 Nginx 静态服务器 安装 Nginx 使用 yum 安装 Nginx: yum install nginx -y 修改 /etc/nginx/conf.d/defaul ...