
Scrapy学习(一)、Scrapy框架和数据流
Scrapy是用python写的爬虫框架,架构图如下:
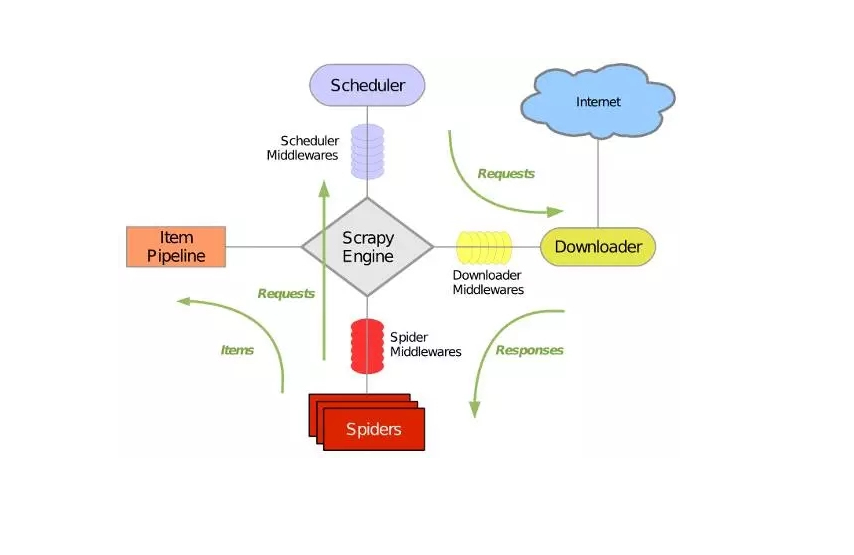
它可以分为如下七个部分:
1、Scrapy Engine:引擎,负责控制数据流在系统的所有组件中流动,并在相应动作发生时触发时间。
2、Scheduler:调度器,从引擎接收Request并将它们入队,以便引擎再次请求Request时提供给引擎。
3、Downloader:下载器,负责获取页面数据并提供给引擎,而后提供给Spiders。
4、Spider:爬虫,定义爬虫逻辑和解析规则,主要负责解析Response并生成提取结果(item)和新的请求(Request)。
5、Item Pipeline:管道,负责处理右Spider提取出来的结果(item)。主要任务是清洗,验证和存储数据。
6、Downloader middlewares:下载器中间件,位于引擎和下载器之间的特定钩子,处理引擎传给下载器的Request以及下载器传给引擎的Response。
7、Spider middlewares:爬虫中间件,位于引擎和爬虫之间的特定钩子,主要处理爬虫的输入(Response)和输出(Item和Request)
具体数据流如下:
1、引擎(Scrapy Engine)打开一个网站,找到处理该网站的Spider,并向该Spider请求第一个要爬取的URL
2、引擎(Scrapy Engine)从Spider中获取到第一个要爬取的URL后,通过调度器(Scheduler)以Request的形式调度
3、引擎(Scrapy Engine)向调度器(Scheduler)请求下一个要爬取的URL
4、调度器(Scheduler)返回下一个要爬取的URL给引擎(Scrapy Engine),引擎将该URL通过下载中间件(Downloader middlewares)转发给下载器(Downloader)
5、下载器(Downloader)下载页面,一旦页面下载完毕,下载器生成一个该页面的Response,并将其通过下载中间件(Downloader middlewares)发送给引擎
6、引擎(Scrapy Engine)从下载中间件(Downloader middlewares)接收Response,并将其通过爬虫中间件(Spider middlewares)发送给爬虫(Spider)处理
7、爬虫(Spider)处理Response,并返回处理的Item及新的Request给引擎
8、引擎(Scrapy Engine)将爬虫(Spider)返回的Item给管道(Item Pipeline),将新的Request给调度器(Scheduler)
9、重复第2步到第8步,直到调度器(Scheduler)中没有更多的Request,引擎(Scrapy Engine)关闭该网站,爬虫结束
Scrapy学习(一)、Scrapy框架和数据流的更多相关文章
- python爬虫学习之Scrapy框架的工作原理
一.Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. 其最初是为了 页面抓取 (更确切来说, 网 ...
- Python爬虫框架Scrapy学习笔记原创
字号 scrapy [TOC] 开始 scrapy安装 首先手动安装windows版本的Twisted https://www.lfd.uci.edu/~gohlke/pythonlibs/#twi ...
- python爬虫之Scrapy学习
在爬虫的路上,学习scrapy是一个必不可少的环节.也许有好多朋友此时此刻也正在接触并学习scrapy,那么很好,我们一起学习.开始接触scrapy的朋友可能会有些疑惑,毕竟是一个框架,上来不知从何学 ...
- 爬虫系列---scrapy post请求、框架组件和下载中间件+boss直聘爬取
一 Post 请求 在爬虫文件中重写父类的start_requests(self)方法 父类方法源码(Request): def start_requests(self): for url in se ...
- Scrapy学习篇(十)之下载器中间件(Downloader Middleware)
下载器中间件是介于Scrapy的request/response处理的钩子框架,是用于全局修改Scrapy request和response的一个轻量.底层的系统. 激活Downloader Midd ...
- scrapy 学习笔记1
最近一段时间开始研究爬虫,后续陆续更新学习笔记 爬虫,说白了就是获取一个网页的html页面,然后从里面获取你想要的东西,复杂一点的还有: 反爬技术(人家网页不让你爬,爬虫对服务器负载很大) 爬虫框架( ...
- scrapy学习(完全版)
scrapy1.6中文文档 scrapy1.6中文文档 scrapy中文文档 Scrapy框架 下载页面 解析页面 并发 深度 安装 scrapy学习教程 如果安装了anconda,可以在anacon ...
- scrapy学习笔记(二)框架结构工作原理
scrapy结构图: scrapy组件: ENGINE:引擎,框架的核心,其它所有组件在其控制下协同工作. SCHEDULER:调度器,负责对SPIDER提交的下载请求进行调度. DOWNLOADER ...
- Scrapy (网络爬虫框架)入门
一.Scrapy 简介: Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,Scrapy 使用了 Twisted['twɪstɪd](其主要对手是Tornado) ...
随机推荐
- CF387B 【George and Round】
暴力还真的出奇迹了这题窝将读入的两个数组都先排个序,然后再枚举一遍就过了: 目前题解最短的代码QwQ.这里是代码 #include<bits/stdc++.h>using namespac ...
- linux小白家教学<一>
<数据中心规划与实施> 教学大纲 编写人:Allen 一. 课程教学内容及目标: (一) 知识目标 1.掌握企业级LINUX部署以及相关配置: 2.掌握LINUX操作系统基本的创建.删除 ...
- spark教程(15)-Streaming
Spark Streaming 是一个分布式数据流处理框架,它可以近乎实时的处理流数据,它易编程,可以处理大量数据,并且能把实时数据与历史数据结合起来处理. Streaming 使得 spark 具有 ...
- javaScript基础知识总汇
javaScript是什么: 1.JavaScript 运行在客户端(浏览器)的编程语言 2.用来给HTML网页增加动态功能 3.用来给HTML网页增加动态功能. 4.Netscape在最初将其脚本语 ...
- Mysql学习(三)之数据库管理工具Navicat
前言 mysql安装完后默认只有命令行工具,所以我们可以下载一些数据库管理工具Navicat Navicat使用 首先建立一个连接选择mysql,填写信息 发现多了一个localhost,双击,打开连 ...
- 一款完美代替微信小程序原生客服消息的工具:
一.设置:无需开发,多种回复(自动+人工) 自动回复形式有3种: 打开客服消息(用户只要和客服互动过一次,再次点击进入,会收到设置好的自动回复) 关键词回复(用户在小程序中回复某个关键词内容时,会 ...
- [转载]for、foreach、iterator的用法及效率区别
来源:https://www.jianshu.com/p/bbb220824c9a 1.在形式上 for的形式是 for(int i=0;i<arr.size();i++){...} forea ...
- 浅析HBase:为高效的可扩展大规模分布式系统而生
什么是HBase Apache HBase是运行在Hadoop集群上的数据库.为了实现更好的可扩展性(scalability),HBase放松了对ACID(数据库的原子性,一致性,隔离性和持久性)的要 ...
- 《python解释器源码剖析》第0章--python的架构与编译python
本系列是以陈儒先生的<python源码剖析>为学习素材,所记录的学习内容.不同的是陈儒先生的<python源码剖析>所剖析的是python2.5,本系列对应的是python3. ...
- tp5实现Redis的简单使用
方法1: Controller <?php namespace app\index\controller; use think\Controller; use think\session\dri ...