
[pytorch笔记] 调整网络学习率
1. 为网络的不同部分指定不同的学习率
 class LeNet(t.nn.Module):

     def __init__(self):

         super(LeNet, self).__init__()

         self.features = t.nn.Sequential(

             t.nn.Conv2d(3, 6, 5),

             t.nn.ReLU(),

             t.nn.MaxPool2d(2, 2),

             t.nn.Conv2d(6, 16, 5),

             t.nn.ReLU(),

             t.nn.MaxPool2d(2, 2)

         )

         # 由于调整shape并不是一个class层,

         # 所以在涉及这种操作(非nn.Module操作)需要拆分为多个模型

         self.classifier = t.nn.Sequential(

             t.nn.Linear(16*5*5, 120),

             t.nn.ReLU(),

             t.nn.Linear(120, 84),

             t.nn.ReLU(),

             t.nn.Linear(84, 10)

         )

     def forward(self, x):

         x = self.features(x)

         x = x.view(-1, 16*5*5)

         x = self.classifier(x)

         return x
这里LeNet被拆解成features和classifier两个模型来实现。在训练时,可以为features和classifier分别指定不同的学习率。
 model = LeNet()

 optimizer = optim.SGD([{'params': model.features.parameters()},

                        {'params': model.classifier.parameters(), 'lr': 1e-2}

                       ], lr = 1e-5)
对于{'params': model.classifier.parameters(), 'lr': 1e-2} 被指定了特殊的学习率 'lr': 1e-2,则按照该值优化。
对于{'params': model.features.parameters()} 没有特殊指定学习率,则使用 lr = 1e-5。
SGD的param_groups中保存着 'params', 'lr', 'momentum', 'dampening','weight_decay','nesterov'及对应值的字典。
在 CLASS torch.optim.Optimizer(params, defaults) 中,提供了 add_param_group(param_group) 函数,可以在optimizer中添加param group. 这在固定与训练网络模型部分,fine-tuning 训练层部分时很实用。
2. 动态调整网络模块的学习率
 for p in optimizer.param_groups:

     p['lr'] = rate()
如果需要动态设置学习率,可以以这种方式,将关于学习率的函数赋值给参数的['lr']属性。
还以以上定义的LeNet的optimizer为例,根据上面的定义,有两个param_groups, 一个是model.features.parameters(), 一个是{'params': model.classifier.parameters()。
那么在for的迭代中,可以分别为这两个param_group通过函数rate()实现动态赋予学习率的功能。
如果将optimizer定义为:
optimizer = optim.SGD(model.parameters(), lr = 0.001, momentum = 0.9)
那么param_groups中只有一个param group,也就是网络中各个模块共用同一个学习率。
3. 使用pytorch封装好的方法
https://pytorch.org/docs/stable/optim.html#how-to-adjust-learning-rate
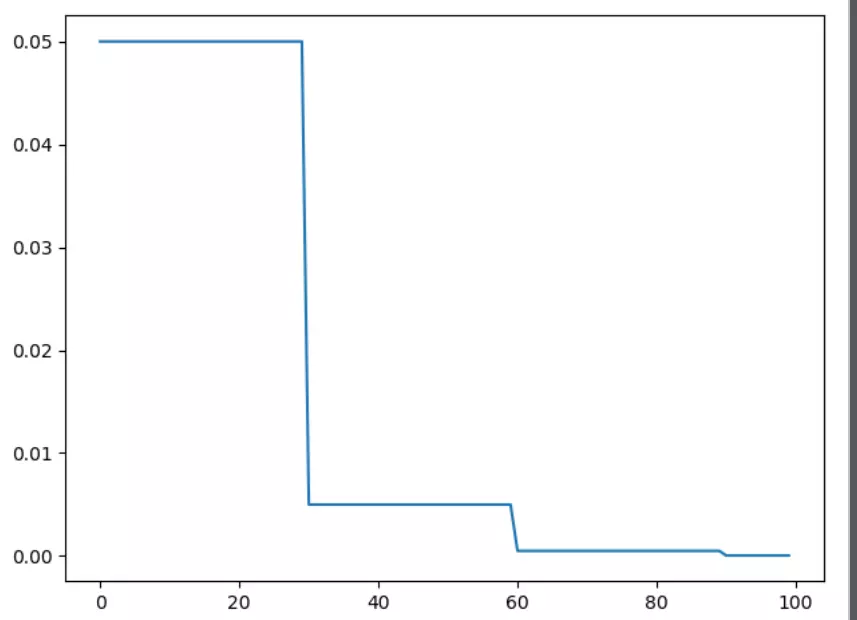
torch.optim.lr_scheduler中提供了一些给予epochs的动态调整学习率的方法。
https://www.jianshu.com/p/a20d5a7ed6f3 这篇blog中绘制了一些学习率方法对应的图示。
1)torch.optim.lr_scheduler.StepLR
 import torch

 import torch.optim as optim

 from torch.optim import lr_scheduler

 from torchvision.models import AlexNet

 import matplotlib.pyplot as plt

 model = AlexNet(num_classes=2)

 optimizer = optim.SGD(params=model.parameters(), lr=0.05)

 # lr_scheduler.StepLR()

 # Assuming optimizer uses lr = 0.05 for all groups

 # lr = 0.05     if epoch < 30

 # lr = 0.005    if 30 <= epoch < 60

 # lr = 0.0005   if 60 <= epoch < 90

 scheduler = lr_scheduler.StepLR(optimizer, step_size=30, gamma=0.1)

 plt.figure()

 x = list(range(100))

 y = []

 for epoch in range(100):

     scheduler.step()

     lr = scheduler.get_lr()

     print(epoch, scheduler.get_lr()[0])

     y.append(scheduler.get_lr()[0])

 plt.plot(x, y)
2)torch.optim.lr_scheduler.MultiStepLR
与StepLR相比,MultiStepLR可以设置指定的区间
 # ---------------------------------------------------------------

 # 可以指定区间

 # lr_scheduler.MultiStepLR()

 #  Assuming optimizer uses lr = 0.05 for all groups

 # lr = 0.05     if epoch < 30

 # lr = 0.005    if 30 <= epoch < 80

 #  lr = 0.0005   if epoch >= 80

 print()

 plt.figure()

 y.clear()

 scheduler = lr_scheduler.MultiStepLR(optimizer, [30, 80], 0.1)

 for epoch in range(100):

     scheduler.step()

     print(epoch, 'lr={:.6f}'.format(scheduler.get_lr()[0]))

     y.append(scheduler.get_lr()[0])

 plt.plot(x, y)

 plt.show()

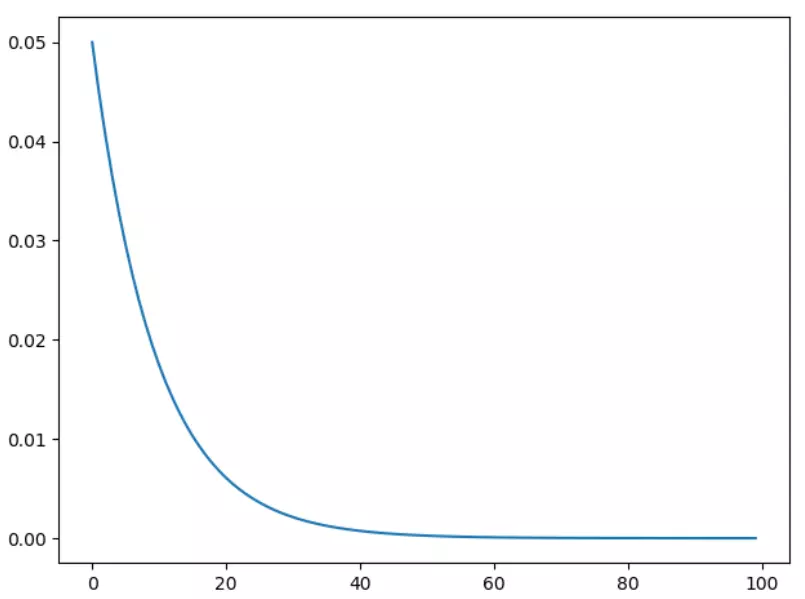
3)torch.optim.lr_scheduler.ExponentialLR
指数衰减
 scheduler = lr_scheduler.ExponentialLR(optimizer, gamma=0.9)

 print()

 plt.figure()

 y.clear()

 for epoch in range(100):

     scheduler.step()

     print(epoch, 'lr={:.6f}'.format(scheduler.get_lr()[0]))

     y.append(scheduler.get_lr()[0])

 plt.plot(x, y)

 plt.show()
[pytorch笔记] 调整网络学习率的更多相关文章
- [Pytorch] pytorch笔记 <三>
pytorch笔记 optimizer.zero_grad() 将梯度变为0,用于每个batch最开始,因为梯度在不同batch之间不是累加的,所以必须在每个batch开始的时候初始化累计梯度,重置为 ...
- [Pytorch] pytorch笔记 <一>
pytorch笔记 - torchvision.utils.make_grid torchvision.utils.make_grid torchvision.utils.make_grid(tens ...
- python3.4学习笔记(十七) 网络爬虫使用Beautifulsoup4抓取内容
python3.4学习笔记(十七) 网络爬虫使用Beautifulsoup4抓取内容 Beautiful Soup 是用Python写的一个HTML/XML的解析器,它可以很好的处理不规范标记并生成剖 ...
- python3.4学习笔记(十三) 网络爬虫实例代码,使用pyspider抓取多牛投资吧里面的文章信息,抓取政府网新闻内容
python3.4学习笔记(十三) 网络爬虫实例代码,使用pyspider抓取多牛投资吧里面的文章信息PySpider:一个国人编写的强大的网络爬虫系统并带有强大的WebUI,采用Python语言编写 ...
- MINIST深度学习识别:python全连接神经网络和pytorch LeNet CNN网络训练实现及比较(三)
版权声明:本文为博主原创文章,欢迎转载,并请注明出处.联系方式:460356155@qq.com 在前两篇文章MINIST深度学习识别:python全连接神经网络和pytorch LeNet CNN网 ...
- [Pytorch] pytorch笔记 <二>
pytorch笔记2 用到的关于plt的总结 plt.scatter scatter(x, y, s=None, c=None, marker=None, cmap=None, norm=None, ...
- 使用Iperf调整网络
使用Iperf调整网络 Iperf 是一个 TCP/IP 和 UDP/IP 的性能测量工具,通过调谐各种参数可以测试TCP的最大带宽,并报告带宽.延迟,最大段和最大传输单元大小等统计信息.Ip ...
- PyTorch对ResNet网络的实现解析
PyTorch对ResNet网络的实现解析 1.首先导入需要使用的包 import torch.nn as nn import torch.utils.model_zoo as model_zoo # ...
- pytorch空间变换网络
pytorch空间变换网络 本文将学习如何使用称为空间变换器网络的视觉注意机制来扩充网络.可以在DeepMind paper 阅读更多有关空间变换器网络的内容. 空间变换器网络是对任何空间变换的差异化 ...
随机推荐
- LOJ576 「LibreOJ NOI Round #2」签到游戏
题目 先进行一个转化: 每次花费\(\gcd\limits_{i=l+1}^rB_i\)的代价,可以连\((l,r)\)这一条边. 然后我们需要求\(0\sim n\)的最小生成树. 根据Kruska ...
- ORM中的锁和事务
锁 sql语句加锁 select * from book where id=1 for update; begin; start transaction; select * from t1 where ...
- 从入门到自闭之Python while如何使用
while 循环 while 条件: 循环体 终止循环的两种办法: 改变条件 break break和continue的用法: break 用法:打破当前循环,(终止当前循环),所处位置在循环 ...
- 手写一个python迭代器
分析 我们都知道一个可迭代对象可以通过iter()可以返回一个迭代器. 如果想要一个对象称为可迭代对象,即可以使用for,那么必须实现__iter __()方法. 在一个类的实例对象想要变成迭代器,就 ...
- java执行bat代码
java执行bat代码.txt public static void runbat(String path,String filename) { String cmd = "cmd /c s ...
- leetcode hard
# Title Solution Acceptance Difficulty Frequency 4 Median of Two Sorted Arrays 27.2% Hard ...
- java中super总结
1:super 可以在子类调用父类中的成员变量(包括static修饰的变量)和方法(包括static修饰的方法) 2:super 可以调用父类的构造方法 super(参数列表),在没有定义时,并且没有 ...
- 一般处理程序,ajax
一般处理程序调用session: 在.aspx.cs页中读写Session都是Session["***"]就可以获取或者写入.但是在一般处理程序也就是ashx页面中,再这样写的话, ...
- EJS学习(一)之特性、安装、工作原理
前言 EJS,"E" 代表 "effective",即[高效],EJS 是一套简单的JavaScript模板,EJS 没有如何组织内容的教条:也没有再造一套迭代 ...
- cookie和session的详解和区别
会话(Session)跟踪是Web程序中常用的技术,用来跟踪用户的整个会话.常用的会话跟踪技术是Cookie与Session.Cookie通过在客户端记录信息确定用户身份,Session通过在服务器端 ...