
【Hadoop】MapReduce练习:分科目等级并按分区统计学生以及人数
需求
背景:学校的学生的是一个非常大的生成数据的集体,比如每次考试的成绩
现有一个班级的学生一个月的考试成绩数据。
科目 姓名 分数
需求:求出每门成绩中属于甲级的学生人数和总人数
乙级的学生人数和总人数
丙级的学生人数和总人数
甲级(90及以上)乙级(80到89)丙级(0到79)
处理数据结果:
甲级分区
课程\t甲级\t学生1,学生2,...\t总人数
乙级分区
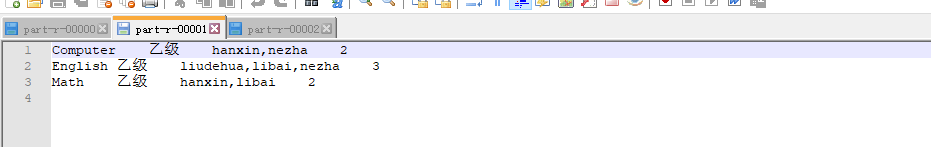
课程\t乙级\t学生1,学生2,...\t总人数
丙级分区
课程\t丙级\t学生1,学生2,...\t总人数
文档格式
English,liudehua,80

English,lijing,79

English,nezha,85

English,jinzha,60

English,muzha,71

English,houzi,99

English,libai,88

English,hanxin,66

English,zhugeliang,95

Math,liudehua,74

Math,lijing,72

Math,nezha,95

Math,jinzha,61

Math,muzha,37

Math,houzi,37

Math,libai,84

Math,hanxin,89

Math,zhugeliang,93

Computer,liudehua,54

Computer,lijing,73

Computer,nezha,86

Computer,jinzha,96

Computer,muzha,76

Computer,houzi,92

Computer,libai,73

Computer,hanxin,82

Computer,zhugeliang,100
代码示例
StuDriver
import org.apache.hadoop.io.Text;

import stuScore.JobUtils;

public class StuDriver {

    public static void main(String[] args) {

        String[] paths = {"F:/stu_score.txt", "F:/output"};

        JobUtils.commit(paths, true, 3, false, StuDriver.class,

                StuMapper.class, Text.class, Text.class, null, StuPartitioner.class, StuReduce.class,

                Text.class, Text.class);

    }

}
JobUtils
import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import java.io.File;

import java.io.IOException;

public class JobUtils {

    private static Configuration conf;

    static {

        conf = new Configuration();

    }

    /**

     * 提交job

     *

     * @param paths        输入输出路径数组

     * @param isPartition  是否包含自定义分区类

     * @param reduceNumber reduce数量(若自定义分区为true,则此项必须>=自定义分区数)

     * @param isGroup  是否分组

     * @param params       可变参数

     */

    public static void commit(String[] paths, boolean isPartition, int reduceNumber, boolean isGroup, Class... params) {

        try {

            Job job = Job.getInstance(conf);

            job.setJarByClass(params[0]);

            job.setMapperClass(params[1]);

            job.setMapOutputKeyClass(params[2]);

            job.setMapOutputValueClass(params[3]);

            if(isGroup) {

                job.setGroupingComparatorClass(params[4]);

            }

            if (isPartition) {

                job.setPartitionerClass(params[5]);//设置自定义分区;

            }

            if (reduceNumber > 0) {

                job.setNumReduceTasks(reduceNumber);

                job.setReducerClass(params[6]);

                job.setOutputKeyClass(params[7]);

                job.setOutputValueClass(params[8]);

            } else {

                job.setNumReduceTasks(0);

            }

            FileInputFormat.setInputPaths(job, new Path(paths[0]));

            FileOutputFormat.setOutputPath(job, new Path(paths[1]));

            job.waitForCompletion(true);

        } catch (InterruptedException | ClassNotFoundException | IOException e) {

            e.printStackTrace();

        }

    }

}
StuMapper
import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class StuMapper extends Mapper<LongWritable, Text, Text, Text> {

    Text k = new Text();

    Text v = new Text();

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        String line = value.toString();

        String[] splits = line.split(",");

        int score = Integer.parseInt(splits[2]);

        String level;

        if (score >= 90) {

            level = "甲级";

        } else if (score < 90 && score >= 80) {

            level = "乙级";

        } else {

            level = "丙级";

        }

        k.set(splits[0] + "\t" + level);

        v.set(splits[1]);

        context.write(k, v);

    }

}
StuReduce
import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class StuReduce extends Reducer<Text,Text,Text, Text> {

    @Override

    protected void reduce(Text key, Iterable<Text> values, Context context) throws IOException, InterruptedException {

        StringBuilder builder = new StringBuilder();

        int count =0;

        for (Text v : values) {

            builder.append(v+",");

            count++;

        }

        builder.replace(builder.length()-1,builder.length(),"\t");

        builder.append(count);

        context.write(key,new Text(builder.toString()));

    }

}
StuPartitioner
import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Partitioner;

public class StuPartitioner extends Partitioner<Text, Text> {

    @Override

    public int getPartition(Text text, Text text2, int i) {

        String line = text.toString();

        if(line.contains("甲级")){

            return 0;

        }else if(line.contains("乙级")){

            return 1;

        }else{

            return 2;

        }

    }

}
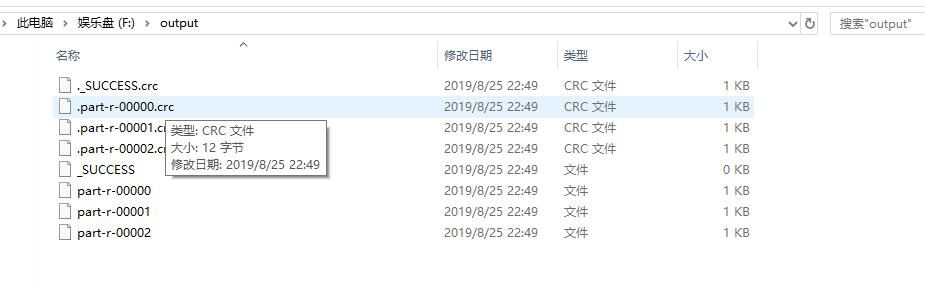
输出结果


【Hadoop】MapReduce练习:分科目等级并按分区统计学生以及人数的更多相关文章
- Hadoop MapReduce编程 API入门系列之分区和合并(十四)
不多说,直接上代码. 代码 package zhouls.bigdata.myMapReduce.Star; import java.io.IOException; import org.apache ...
- Hadoop MapReduce编程 API入门系列之薪水统计(三十一)
不多说,直接上代码. 代码 package zhouls.bigdata.myMapReduce.SalaryCount; import java.io.IOException; import jav ...
- Hadoop Mapreduce分区、分组、二次排序过程详解[转]
原文地址:Hadoop Mapreduce分区.分组.二次排序过程详解[转]作者: 徐海蛟 教学用途 1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2) ...
- Hadoop mapreduce自定义分区HashPartitioner
本文发表于本人博客. 在上一篇文章我写了个简单的WordCount程序,也大致了解了下关于mapreduce运行原来,其中说到还可以自定义分区.排序.分组这些,那今天我就接上一次的代码继续完善实现自定 ...
- Hadoop MapReduce执行过程详解(带hadoop例子)
https://my.oschina.net/itblog/blog/275294 摘要: 本文通过一个例子,详细介绍Hadoop 的 MapReduce过程. 分析MapReduce执行过程 Map ...
- Hadoop MapReduce 二次排序原理及其应用
关于二次排序主要涉及到这么几个东西: 在0.20.0 以前使用的是 setPartitionerClass setOutputkeyComparatorClass setOutputValueGrou ...
- 三种方法实现Hadoop(MapReduce)全局排序(1)
我们可能会有些需求要求MapReduce的输出全局有序,这里说的有序是指Key全局有序.但是我们知道,MapReduce默认只是保证同一个分区内的Key是有序的,但是不保证全局有序.基于此,本文提供三 ...
- hadoop MapReduce
简单介绍 官方给出的介绍是hadoop MR是一个用于轻松编写以一种可靠的.容错的方式在商业化硬件上的大型集群上并行处理大量数据的应用程序的软件框架. MR任务通常会先把输入的数据集切分成独立的块(可 ...
- Hadoop Mapreduce 案例 wordcount+统计手机流量使用情况
mapreduce设计思想 概念:它是一个分布式并行计算的应用框架它提供相应简单的api模型,我们只需按照这些模型规则编写程序,即可实现"分布式并行计算"的功能. 案例一:word ...
随机推荐
- HTML禁用一块区域点击
style="pointer-events: none;" 此方法可以禁止鼠标点击指定区域,但是对于键盘事件无法屏蔽,最好禁用一下键盘事件,如:tab
- 再度吐槽,PHP在centos7的安装方式稍不注意可能就打击你的积极性
由于装新机器,没仔细看随便找了篇博文就匆匆安装了php73结果,连配置文件,扩展模块都找不着在哪这里介绍一个linux的查找命令 find / -name php73* 这一命令使用了*这一正则匹配的 ...
- kafka什么时候会丢消息(转)
因为在具体开发中某些环节考虑使用kafka却担心有消息丢失的风险,本周结合项目对kafka的消息可靠性做了一下调研和总结: 首先明确一下丢消息的定义.kafka集群中的部分或全部broker挂了,导致 ...
- NodeList对象的特点
nodeList对象的特点1,nodeList是一种类数组对象,用于保存一组有序的节点.2,通过方括号来访问nodeList的值,有item方法与length属性.3,它并不是Array的实例,没有数 ...
- 【luoguP4124 】[CQOI2016]手机号码
题目描述 人们选择手机号码时都希望号码好记.吉利.比如号码中含有几位相邻的相同数字.不含谐音不吉利的数字等.手机运营商在发行新号码时也会考虑这些因素,从号段中选取含有某些特征的号码单独出售.为了便于前 ...
- Transformer模型总结
Transformer改进了RNN最被人诟病的训练慢的缺点,利用self-attention机制实现快速并行. 它是由编码组件.解码组件和它们之间的连接组成. 编码组件部分由一堆编码器(6个 enco ...
- 数据结构实验之链表二:逆序建立链表(SDUT 2117)
题目链接 #include <bits/stdc++.h> using namespace std; struct node { int data; struct node *next; ...
- 阿里云Ubuntu安装LNMP环境之PHP7
在QQ群很多朋友问阿里云服务器怎么安装LNMP环境,怎么把项目放到服务器上面去,在这里,我就从头开始教大家怎么在阿里云服务器安装LNMP环境. 在这之前,我们先要知道什么是LNMP. L: 表示的是L ...
- 【java设计模式】-05建造者模式
建造者模式 简述 建造者模式,是将一个复杂对象的创建和它的表示分离开来,这就使得同样的构建构成可以有不同的表示. 建造者模式是一步步构建一个复杂的对象,允许用户只需要指定复杂对象的类型和必要的内容就可 ...
- Linux 删除文件夹和文件的命令(强制删除包括非空文件)
linux删除目录很简单,很多人还是习惯用rmdir,不过一旦目录非空,就陷入深深的苦恼之中,现在使用rm -rf命令即可.直接rm就可以了,不过要加两个参数-rf 即:rm -rf 目录名字-r 就 ...