
Word2Vec词向量(一)
一、词向量基础(一)来源背景
word2vec是google在2013年推出的一个NLP工具,它的特点是将所有的词向量化,这样词与词之间就可以定量的去度量他们之间的关系,挖掘词之间的联系。虽然源码是开源的,但是谷歌的代码库国内无法访问,
因此本文的讲解word2vec原理以Github上的word2vec代码为准。
最早的词向量是使用one-hot编码表示的(就是有多少个词就有多少维度,每个词对应的位置是1, 其他位置是0), 如下图:
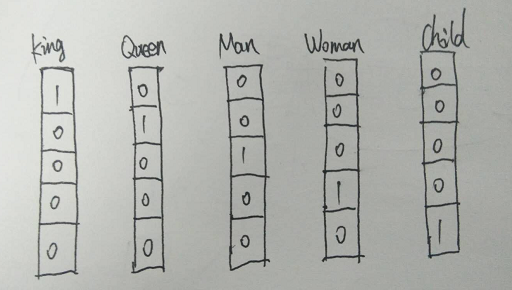
这样表示最大的确定就是我们的词汇表一般都非常大,比如达到百万级别,这样每个词都用百万维的向量来表示简直是内存的灾难。
分布式表示可以解决One-hot方式的问题,它的思路是通过训练,将每个词都映射到一个较短的词向量上来。所有的这些词向量就构成了向量空间,
进而可以用普通的统计学的方法来研究词与词之间的关系。这个较短的词向量维度是多大呢?这个一般需要我们在训练时自己来指定。
比如下图我们将词汇表里的词用"Royalty","Masculinity", "Femininity"和"Age"4个维度来表示,King这个词对应的词向量可能是(0.99,0.99,0.05,0.7)(0.99,0.99,0.05,0.7)。
当然在实际情况中,我们并不能对词向量的每个维度做一个很好的解释。
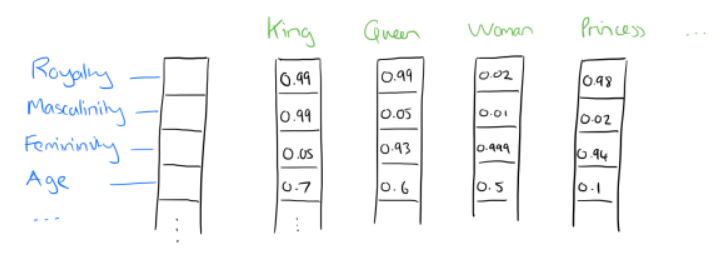
有了用分布式表示的较短的词向量,我们就可以较容易的分析词之间的关系了,比如我们将词的维度降维到2维,有一个有趣的研究表明,用下图的词向量表示我们的词时,我们可以发现:
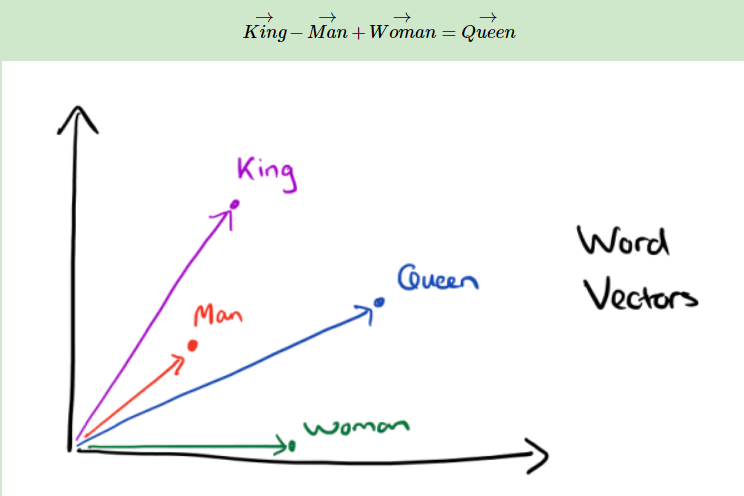
可见我们只要得到了词汇表里所有词对应的词向量,那么我们就可以做很多有趣的事情了。不过,怎么训练得到合适的词向量呢?一个很常见的方法是使用神经网络语言模型。
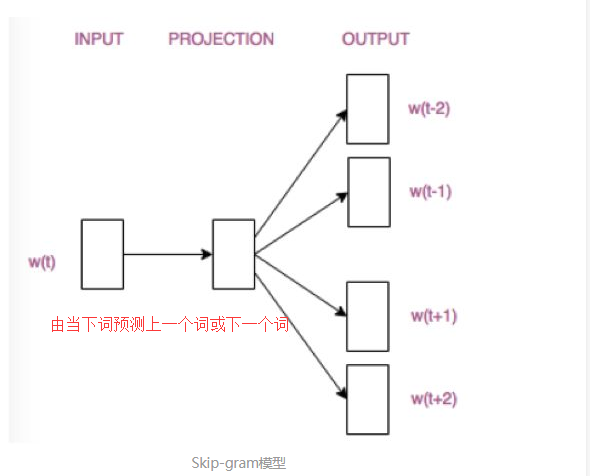
二、词向量基础(CBOW与Skip-Gram模型)
通俗解释:
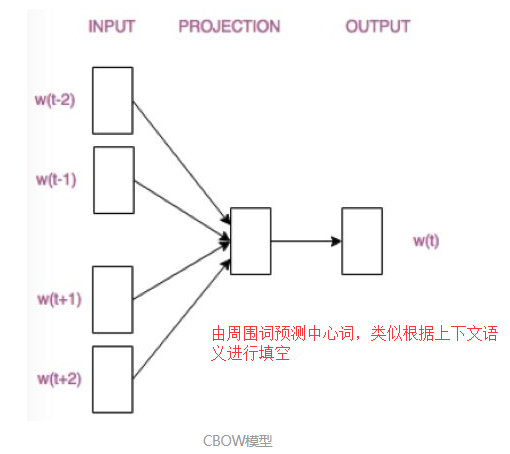
CBOW((Continuous Bag-of-Words)模型根据中心词W(t)周围的词来预测中心词
Skip-gram模型则根据中心词W(t)来预测周围词
Word2Vec词向量(一)的更多相关文章
- 文本分布式表示(三):用gensim训练word2vec词向量
今天参考网上的博客,用gensim训练了word2vec词向量.训练的语料是著名科幻小说<三体>,这部小说我一直没有看,所以这次拿来折腾一下. <三体>这本小说里有不少人名和一 ...
- word2vec词向量训练及中文文本类似度计算
本文是讲述怎样使用word2vec的基础教程.文章比較基础,希望对你有所帮助! 官网C语言下载地址:http://word2vec.googlecode.com/svn/trunk/ 官网Python ...
- word2vec词向量处理中文语料
word2vec介绍 word2vec官网:https://code.google.com/p/word2vec/ word2vec是google的一个开源工具,能够根据输入的词的集合计算出词与词之间 ...
- 机器学习之路: python 实践 word2vec 词向量技术
git: https://github.com/linyi0604/MachineLearning 词向量技术 Word2Vec 每个连续词汇片段都会对后面有一定制约 称为上下文context 找到句 ...
- word2vec词向量处理英文语料
word2vec介绍 word2vec官网:https://code.google.com/p/word2vec/ word2vec是google的一个开源工具,能够根据输入的词的集 ...
- 机器学习入门-文本特征-word2vec词向量模型 1.word2vec(进行word2vec映射编码)2.model.wv['sky']输出这个词的向量映射 3.model.wv.index2vec(输出经过映射的词名称)
函数说明: 1. from gensim.model import word2vec 构建模型 word2vec(corpus_token, size=feature_size, min_count ...
- 文本分类实战(一)—— word2vec预训练词向量
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 文本情感分析(二):基于word2vec、glove和fasttext词向量的文本表示
上一篇博客用词袋模型,包括词频矩阵.Tf-Idf矩阵.LSA和n-gram构造文本特征,做了Kaggle上的电影评论情感分类题. 这篇博客还是关于文本特征工程的,用词嵌入的方法来构造文本特征,也就是用 ...
- PyTorch在NLP任务中使用预训练词向量
在使用pytorch或tensorflow等神经网络框架进行nlp任务的处理时,可以通过对应的Embedding层做词向量的处理,更多的时候,使用预训练好的词向量会带来更优的性能.下面分别介绍使用ge ...
随机推荐
- LeetCode2.两数相加 JavaScript
给定两个非空链表来表示两个非负整数.位数按照逆序方式存储,它们的每个节点只存储单个数字.将两数相加返回一个新的链表. 你可以假设除了数字 0 之外,这两个数字都不会以零开头. 示例: 输入:(2 -& ...
- Oracle递归 start with...connect by...prior
prior一侧是父节点 另一侧是子节点 --查询region_id等于4519的节点下面的所有子节点 查找出给定节点的所有子节点 SELECT sr.* FROM spc_region sr wher ...
- Python基础—03-运算符与分支结构
运算符与分支结构 运算符 赋值运算符 用'='表示,左边只能是变量 算术运算符 +.-.*:加.减.乘 /:除法运算,结果是浮点型 //:除法运算,结果是整型 %:求余 **:求幂 复合运算符 +=. ...
- C++的抽象类、虚函数、虚基类和java的抽象类和接口
简单整理如下: C++虚函数 == java普通函数 C++纯虚函数 == java抽象函数 C++抽象类 == java抽象类 C++虚基类(全都是纯虚函数) == java接口
- iOS之UIImagePickerController显示中文界面
iOS开发中,我们经常遇到获取拍照.相册中图片的功能,就必然少不了UIImagePickerController,但是我们发现当我们使用它的时候,它的页面是英文的,看着很别扭,国人还是比较喜欢看中文界 ...
- 单机安装hadoop+hive+presto
系统环境 在个人笔记本上使用virtualbox虚拟机 os:centos -7.x86-64.everything.1611 ,内核 3.10.0-514.el7.x86_64 注:同样可以使用r ...
- spring cloud 学习之路由网关(zuul)
学习自方志朋的博客 http://blog.csdn.net/forezp/article/details/69939114 在微服务架构中,需要几个基础的服务治理组件,包括服务注册与发现.服务消费. ...
- Python日常运维脚本
1 扫描Windows系统CPU.内存.磁盘利用率 1.1 实现代码 #!usr/bin/env python #-*- coding:utf-8 _*- ""&quo ...
- node.js中http通讯模块
创建一个服务器 首先建立一个js文件,命名为app.js写入内容: const http=require('http'); http.createServer((request,response)=& ...
- [转]不让iTunes备份到c盘
很多人现在的C盘都是空间不大的SSD硬盘,ITUNES备份老是占越来越大的空间,不如动手把它改成其它盘好了.下面7个步骤教你转移备份. 1.需要一个小工具:Juction.exe,如果你已经是WIN7 ...