
深度学习网络层之 Batch Normalization
Batch Normalization
Ioffe 和 Szegedy 在2015年《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》论文中提出此方法来减缓网络参数初始化的难处.
Batch Norm优点
- 减轻过拟合
- 改善梯度传播(权重不会过高或过低)
- 容许较高的学习率,能够提高训练速度。
- 减轻对初始化权重的强依赖
- 作为一种正则化的方式,在某种程度上减少对dropout的使用。
Batch Norm层摆放位置
在激活层(如 ReLU )之前还是之后,没有一个统一的定论。在原论文中提出在非线性层之前(CONV_BN_RELU),而在实际编程中很多人可能放在激活层之后(BN_CONV_RELU)。
Batch Norm原理
内部协转移(Internal Covariate Shift):由于训练时网络参数的改变导致的网络层输出结果分布的不同。这正是导致网络训练困难的原因。
对输如进行白化(whiten:0均值,单位标准差,并且decorrelate去相关)已被证明能够加速收敛速度,参考Efficient backprop. (LeCun et al.1998b)和 A convergence anal-ysis of log-linear training.(Wiesler & Ney,2011)。由于白化中去除相关性类似PCA等操作,在特征维度较高时计算复杂度较高,因此提出了两种简化方式:1)对特征的每个维度进行归一化,忽略白化中的去除相关性 ;2)在每个mini-batch中计算均值和方差来替代整体训练集的计算.
batch normalization中即使不对每层的输入进行去相关,也能加速收敛。通俗的理解是在网络的每一层的输入都做了归一化预处理。
unit gaussian activations:
\[
\hat x^{(k)}=\frac{x^{(k)}-E[x^{(k)}]}{\sqrt{\operatorname{Var[x^{(k)}]}}}
\]
公式中k为通道channel数。
\[
\text{Batch Normalizing Transform} \\
\begin{align}
u &= \frac{1}{m}\sum_{i=1}^m x_i &\text{//mini-batch mean} \\
var &= \frac{1}{m} \sum_{i=1}^m (x_i - u)^2 &\text{//mini-batch variance} \\
\hat{x_i} &= \frac{x_i - u}{\sqrt{var + \epsilon}} &\text{//normalize} \\
y_i &= \gamma \hat{x_i} + \beta &\text{//scale and shift}
\end{align}
\]
其中ϵ是为了防止方差为0导致数值计算的不稳定而添加的一个小数,如1e−6。可以看做是在原网络中插入了一个
注意,在对每层的输入进行正则化之后会改变特征的表示,如对sigmoid输入进行正则化后将数据限制在进行线性的区域,这样改变了原始特征的分布。如下图所示:
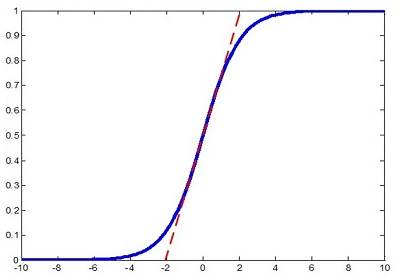
论文中引入了两个可学习的参数\(\gamma , \beta\)来还原原始特征分布。这两个参数学习的目标即为\(\gamma=\sqrt{\text{Var}[x]}、 \beta=\mathbb E[x]\).原来的分布方差和均值由前层的各种参数weight耦合控制,而现在仅由\(\gamma , \beta\)控制,这样在保留BN层足够的学习能力的同时,我们使得其学习更加容易。因此,加速收敛并非由于计算量减少(反而由于增加了参数增加了计算量)。梯度计算如下:

在训练时计算mini-batch的均值和标准差并进行反向传播训练,而测试时并没有batch的概念,训练完毕后需要提供固定的\(\bar\mu,\bar\sigma\)供测试时使用。论文中对所有的mini-batch的\(\mu_\mathcal B,\sigma^2_\mathcal B\)取了均值(m是mini-batch的大小,\(\bar\sigma^2\)采用的是无偏估计):
\[
\begin{align}
\bar\mu &=\mathbb E[\mu_\mathcal B] \\
\bar\sigma^2 &={m\over m-1}\mathbb E[\sigma^2_\mathcal B]
\end{align}
\]
测试阶段,同样要进行归一化和缩放平移操作,唯一不同之处是不计算均值和方差,而使用训练阶段记录下来的\(\bar\mu,\bar\sigma\)。
\[
\begin{align}
y&=γ({x-\bar\mu\over\sqrt{\bar\sigma^2+ϵ}})+ β \\
&={γ\over\sqrt{\bar\sigma^2+ϵ}}\cdot x+(β-{γ\bar\mu\over\sqrt{\bar\sigma^2+ϵ}})
\end{align}
\]
caffe框架中该层全局均值和方差的实现
与论文计算 global 均值和 global 方差的方式不同之处在于,Caffe 中的 global 均值和 global 方差采用的是滑动衰减平均的更新方式,设滑动衰减系数moving_average_fraction 为 λ,当前的 mini-batch 的均值和方差分别为 \(\mu_B,\sigma_B^2\):
\[
\mu_{new} = \lambda \mu_{old} + \mu_B \\
\sigma_{new}^2 =
\begin{cases}
\lambda \sigma_{old}^2 + \frac{m - 1}{m} \sigma_B^2 & m > 1 \\
\lambda \sigma_{old}^2 & m = 1
\end{cases}
\]
Batch Norm在卷积层的应用
前边提到的mini-batch说的是神经元的个数,而卷积层中是堆叠的多个特征图,共享卷积参数。如果每个神经元使用一对\(\gamma , \beta\)参数,那么不仅多,而且冗余。可以在channel方向上取m个特征图作为mini-batch,对每一个特征图计算一对参数。这样减少了参数的数量。
应用举例-VGG16
为VGG16结构模型添加Batch Normalization。
- 重新完全训练.如果想将BN添加到卷基层,通常要重新训练整个模型,大概花费一周时间。
- finetune.只将BN添加到最后的几层全连接层,这样可以在训练好的VGG16模型上进行微调。采用ImageNet的全部或部分数据按batch计算均值和方差作为BN的初始\(\beta,\gamma\)参数。
深度学习网络层之 Batch Normalization的更多相关文章
- 深度解析Droupout与Batch Normalization
Droupout与Batch Normalization都是深度学习常用且基础的训练技巧了.本文将从理论和实践两个角度分布其特点和细节. Droupout 2012年,Hinton在其论文中提出Dro ...
- 深度学习中优化【Normalization】
深度学习中优化操作: dropout l1, l2正则化 momentum normalization 1.为什么Normalization? 深度神经网络模型的训练为什么会很困难?其中一个重 ...
- 深度学习中的batch、epoch、iteration的含义
深度学习的优化算法,说白了就是梯度下降.每次的参数更新有两种方式. 第一种,遍历全部数据集算一次损失函数,然后算函数对各个参数的梯度,更新梯度.这种方法每更新一次参数都要把数据集里的所有样本都看一遍, ...
- 深度学习中的batch的大小对学习效果的影响
Batch_size参数的作用:决定了下降的方向 极端一: batch_size为全数据集(Full Batch Learning): 好处: 1.由全数据集确定的方向能够更好地代表样本总体,从而更准 ...
- 深度学习网络层之 Pooling
pooling 是仿照人的视觉系统进行降维(降采样),用更高层的抽象表示图像特征,这一部分内容从Hubel&wiesel视觉神经研究到Fukushima提出,再到LeCun的LeNet5首次采 ...
- 深度学习(二十九)Batch Normalization 学习笔记
Batch Normalization 学习笔记 原文地址:http://blog.csdn.net/hjimce/article/details/50866313 作者:hjimce 一.背景意义 ...
- 【深度学习】批归一化(Batch Normalization)
BN是由Google于2015年提出,这是一个深度神经网络训练的技巧,它不仅可以加快了模型的收敛速度,而且更重要的是在一定程度缓解了深层网络中"梯度弥散"的问题,从而使得训练深层网 ...
- caffe︱深度学习参数调优杂记+caffe训练时的问题+dropout/batch Normalization
一.深度学习中常用的调节参数 本节为笔者上课笔记(CDA深度学习实战课程第一期) 1.学习率 步长的选择:你走的距离长短,越短当然不会错过,但是耗时间.步长的选择比较麻烦.步长越小,越容易得到局部最优 ...
- 【深度学习】深入理解Batch Normalization批标准化
这几天面试经常被问到BN层的原理,虽然回答上来了,但还是感觉答得不是很好,今天仔细研究了一下Batch Normalization的原理,以下为参考网上几篇文章总结得出. Batch Normaliz ...
随机推荐
- git 简易使用说明
背景 代码用git管理,所以需要大家熟悉git工具的一些操作 目前我们自动化在develop分支上进行编写 前言 安装git,https://git-scm.com/ 可视化工具推荐,sourcetr ...
- GC选择之串行收集与并行收集
GC 串行收集器 (古老 稳定 会有较长时间停顿)-XX:+UseSerialGC 新生代.老年代串行回收,新生代复制算法.老年代标记-压缩算法 并行收集器 ParNew (多核时性能比较好) Ser ...
- 2017-4-25/设计缓存(LFU)
1. 恒定缓存性能有哪些因素? 命中率.缓存更新策略.缓存最大数据量. 命中率:指请求缓存次数和缓存返回正确结果次数的比例.比例越高,缓存的使用率越高,用来衡量缓存机智的好坏和效率.如果数据频繁更新, ...
- python代码`if not x:` 和`if x is not None:`和`if not x is None:`
转自 http://blog.csdn.net/sasoritattoo/article/details/12451359 代码中经常会有变量是否为None的判断,有三种主要的写法: 第一种是`if ...
- 使用javaconfig配置freemarker
package com.yy.config; import org.springframework.context.annotation.Bean; import org.springframewor ...
- idea 远程调试
Idea 远程在线测试 描述:在window下开发,部署到Linux服务器上,往往会遇到在windows下正常运行,在Linux服务器下异常,这是需要本地调试远程代码: 操作步骤: 一.代码已知 保证 ...
- ASP.NET Core 运行原理解剖[4]:进入HttpContext的世界
HttpContext是ASP.NET中的核心对象,每一个请求都会创建一个对应的HttpContext对象,我们的应用程序便是通过HttpContext对象来获取请求信息,最终生成响应,写回到Http ...
- JS面向对象编程(进阶理解)
JS 面向对象编程 如何创建JS对象 JSON语法声明对象(直接量声明对象) var obj = {}; 使用 Object 创建对象 var obj = new Object(); JS对象可以后期 ...
- ABB-robotstudio离线编程-Smart组件资料-笔记
Smart组件 目录: 1.“信号与属性”子组件. 2.“参数与建模”子组件. 3.“传感器”子组件. 4.“动作”子组件. 5.“本体”子组件. 6.“其他”子组件. 一.“信号与属牲”子组件 1. ...
- html标签缺省(自带)样式大全
html标签默认样式整理 作者:佚名 来源:互联网 时间:07-30 16:54:48 文为大家整理了html标签默认样式属性及浏览器默认样式等等,喜欢css布局的朋友们可以学下,希望对大家有所帮助 ...