
深度学习中优化【Normalization】
深度学习中优化操作:
- dropout
- l1, l2正则化
- momentum
- normalization
1、为什么Normalization?
深度神经网络模型的训练为什么会很困难?其中一个重要的原因是,深度神经网络涉及到很多层的叠加,而每一层的参数更新会导致上层的输入数据分布发生变化,通过层层叠加,高层的输入分布变化会非常剧烈,这就使得高层需要不断去重新适应底层的参数更新。为了训好模型,我们需要非常谨慎地去设定学习率、初始化权重、以及尽可能细致的参数更新策略。
对于每一层网络得到输出向量的分布是不太有规律的,将这些没有规律的的输出结果放入激励层,会使得许多样本?因为偏离0坐标太远,而使得这些样本的值很大(等于1)或者很小(等于0),从而导致在反向传播时梯度消失。
我们在训练的时候希望每个batch在同一层网络下的输出结果是独立同分布的,这样能网络的泛化性就会比较强。
2、方式
1.Batch Normalization
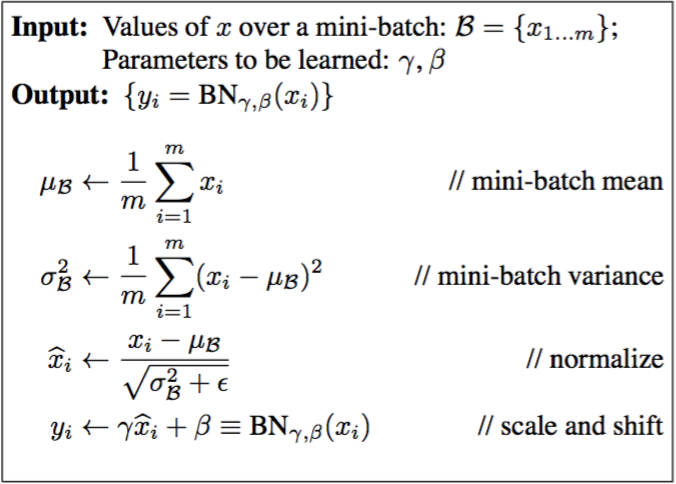
BN的做法很简单,就是在输出结果在送到激励层之前,对输出结果做一次标准化。
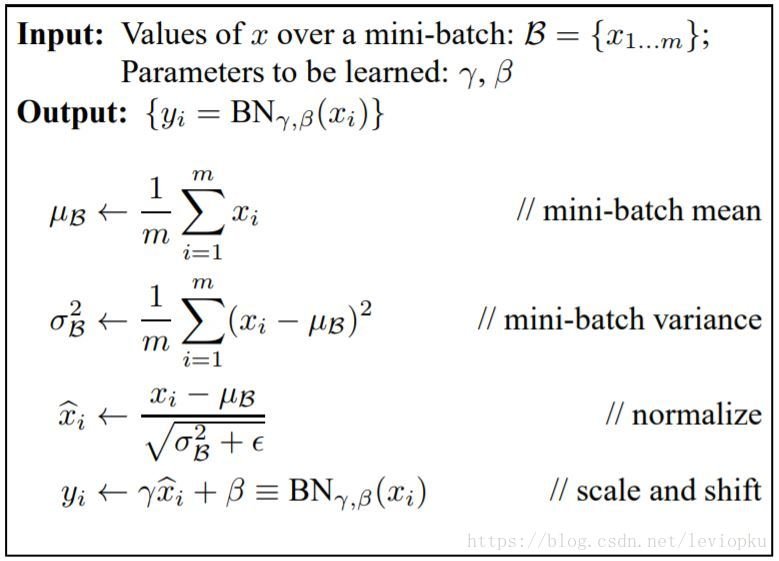
前三步分别就是求均值与方差,并对其进行中心化,normalize中分母中的$\epsilon$,是为了避免除以0溢出。经过这三步,输出结果已经变成均值为$\mu _{b}$, 方差是$\sigma^{2}_{b}$的分布了。
最后一步非常重要。γ和β是可学习的,目的是让网络能够自己调节分布。我们获得一个关于y轴对称的分布真的是最符合神经网络训练的吗?没有任何理由能证明这点。事实上,γ和β为输出的线性调整参数,可以让分布曲线压缩或延长一点,左移或右移一点。由于γ和β是可训练的,那么意味着神经网络会随着训练过程自己挑选一个最适合的分布。如果我们固执地不用γ和β会怎么样呢?那势必会把压力转移到特征提取层,虽然最后结果依然可观,但训练压力会很大。你想想,一边只需要训练两个数,另一边需要训练特征提取层来符合最优分布就是关于y轴的对称曲线。前者自然训练成本更低。
---------------------
作者:木盏
来源:CSDN
原文:https://blog.csdn.net/leviopku/article/details/83109422
版权声明:本文为博主原创文章,转载请附上博文链接!
反向传播:https://kevinzakka.github.io/2016/09/14/batch_normalization/
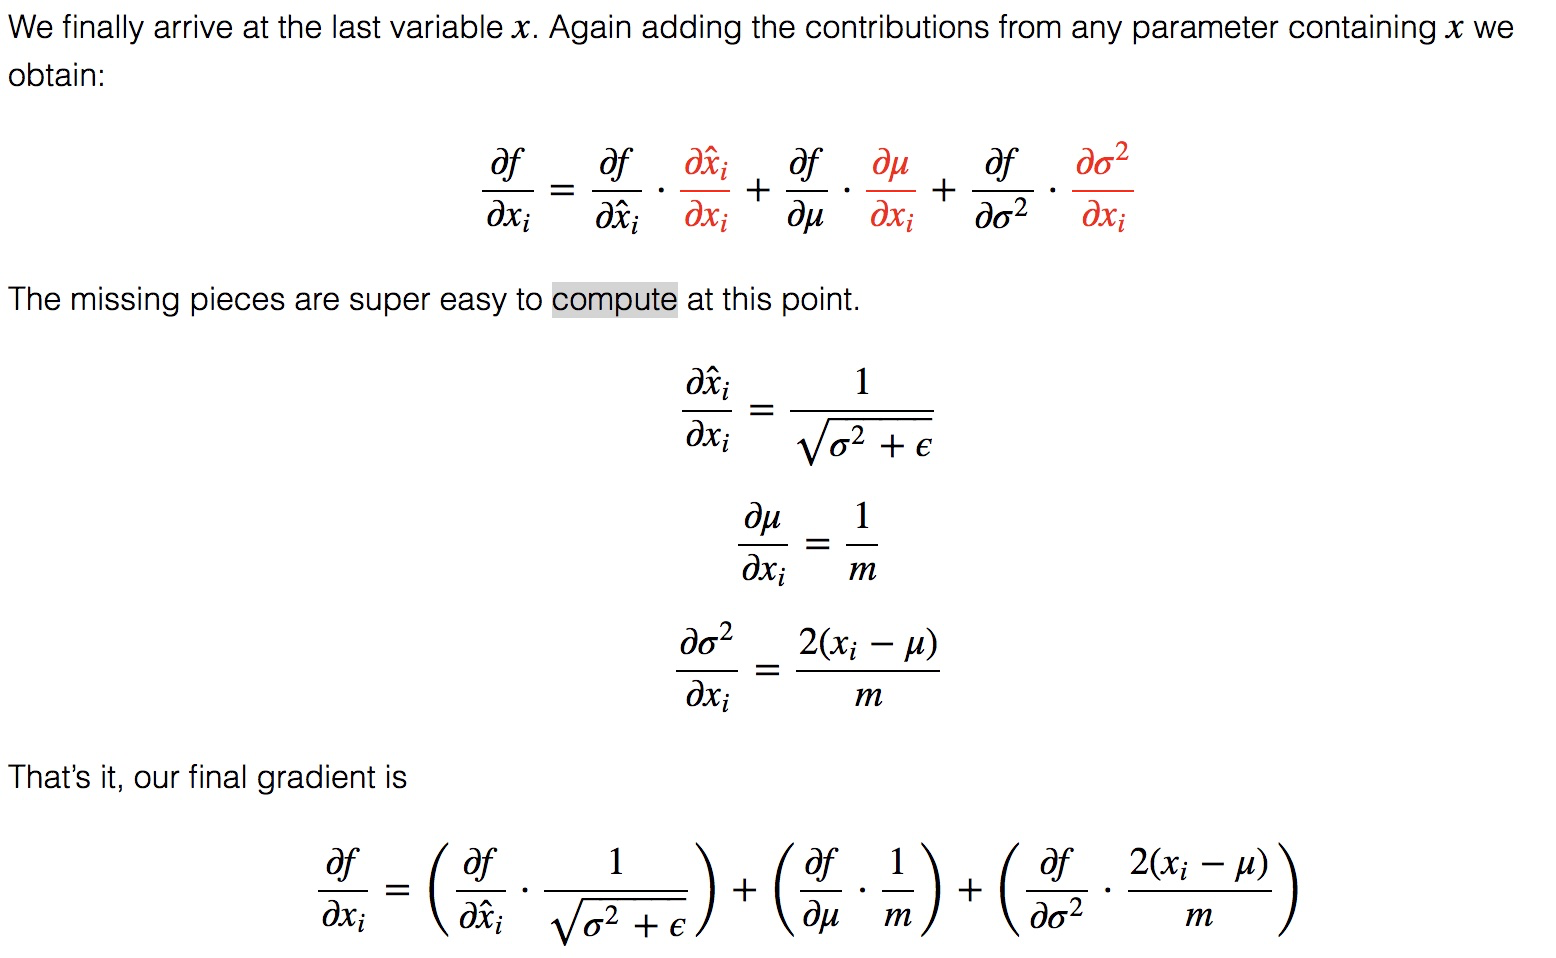
在反向传播过程中,$\frac{\partial L}{\partial \boldsymbol{y}}$由上一步已经算出,是已知条件。
先求:$\frac{\partial f}{\partial \gamma }, \frac{\partial f}{\partial \hat{x_{i}}},\frac{\partial f}{\partial \beta } $
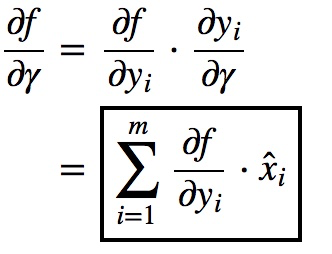
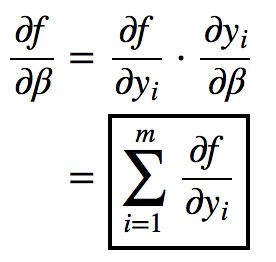
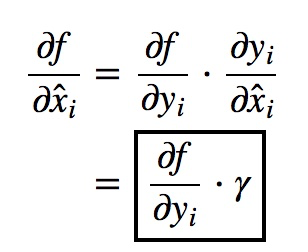
再根据 x标准化,求$\frac{\partial f}{\partial \mu }, \frac{\partial f}{\partial \sigma ^{2}},\frac{\partial f}{\partial x_{i} } $
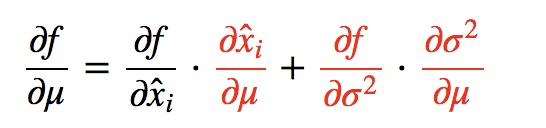
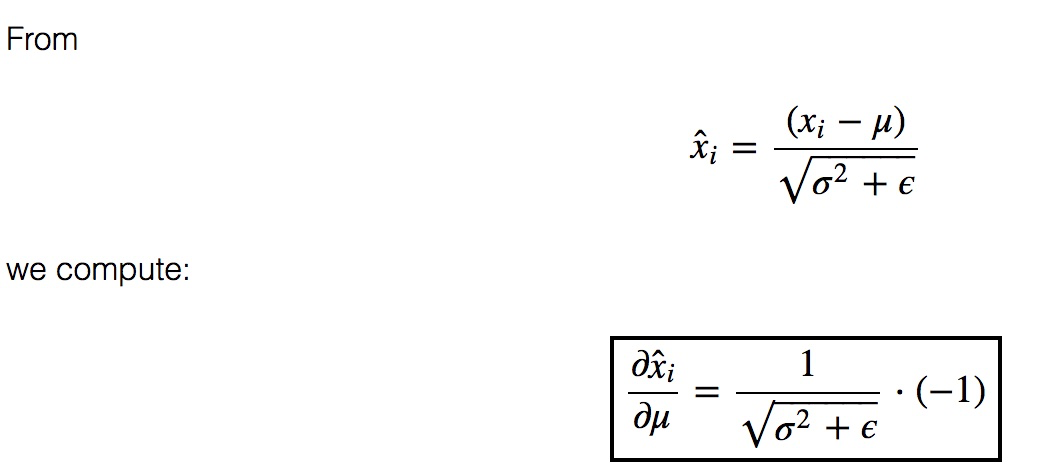
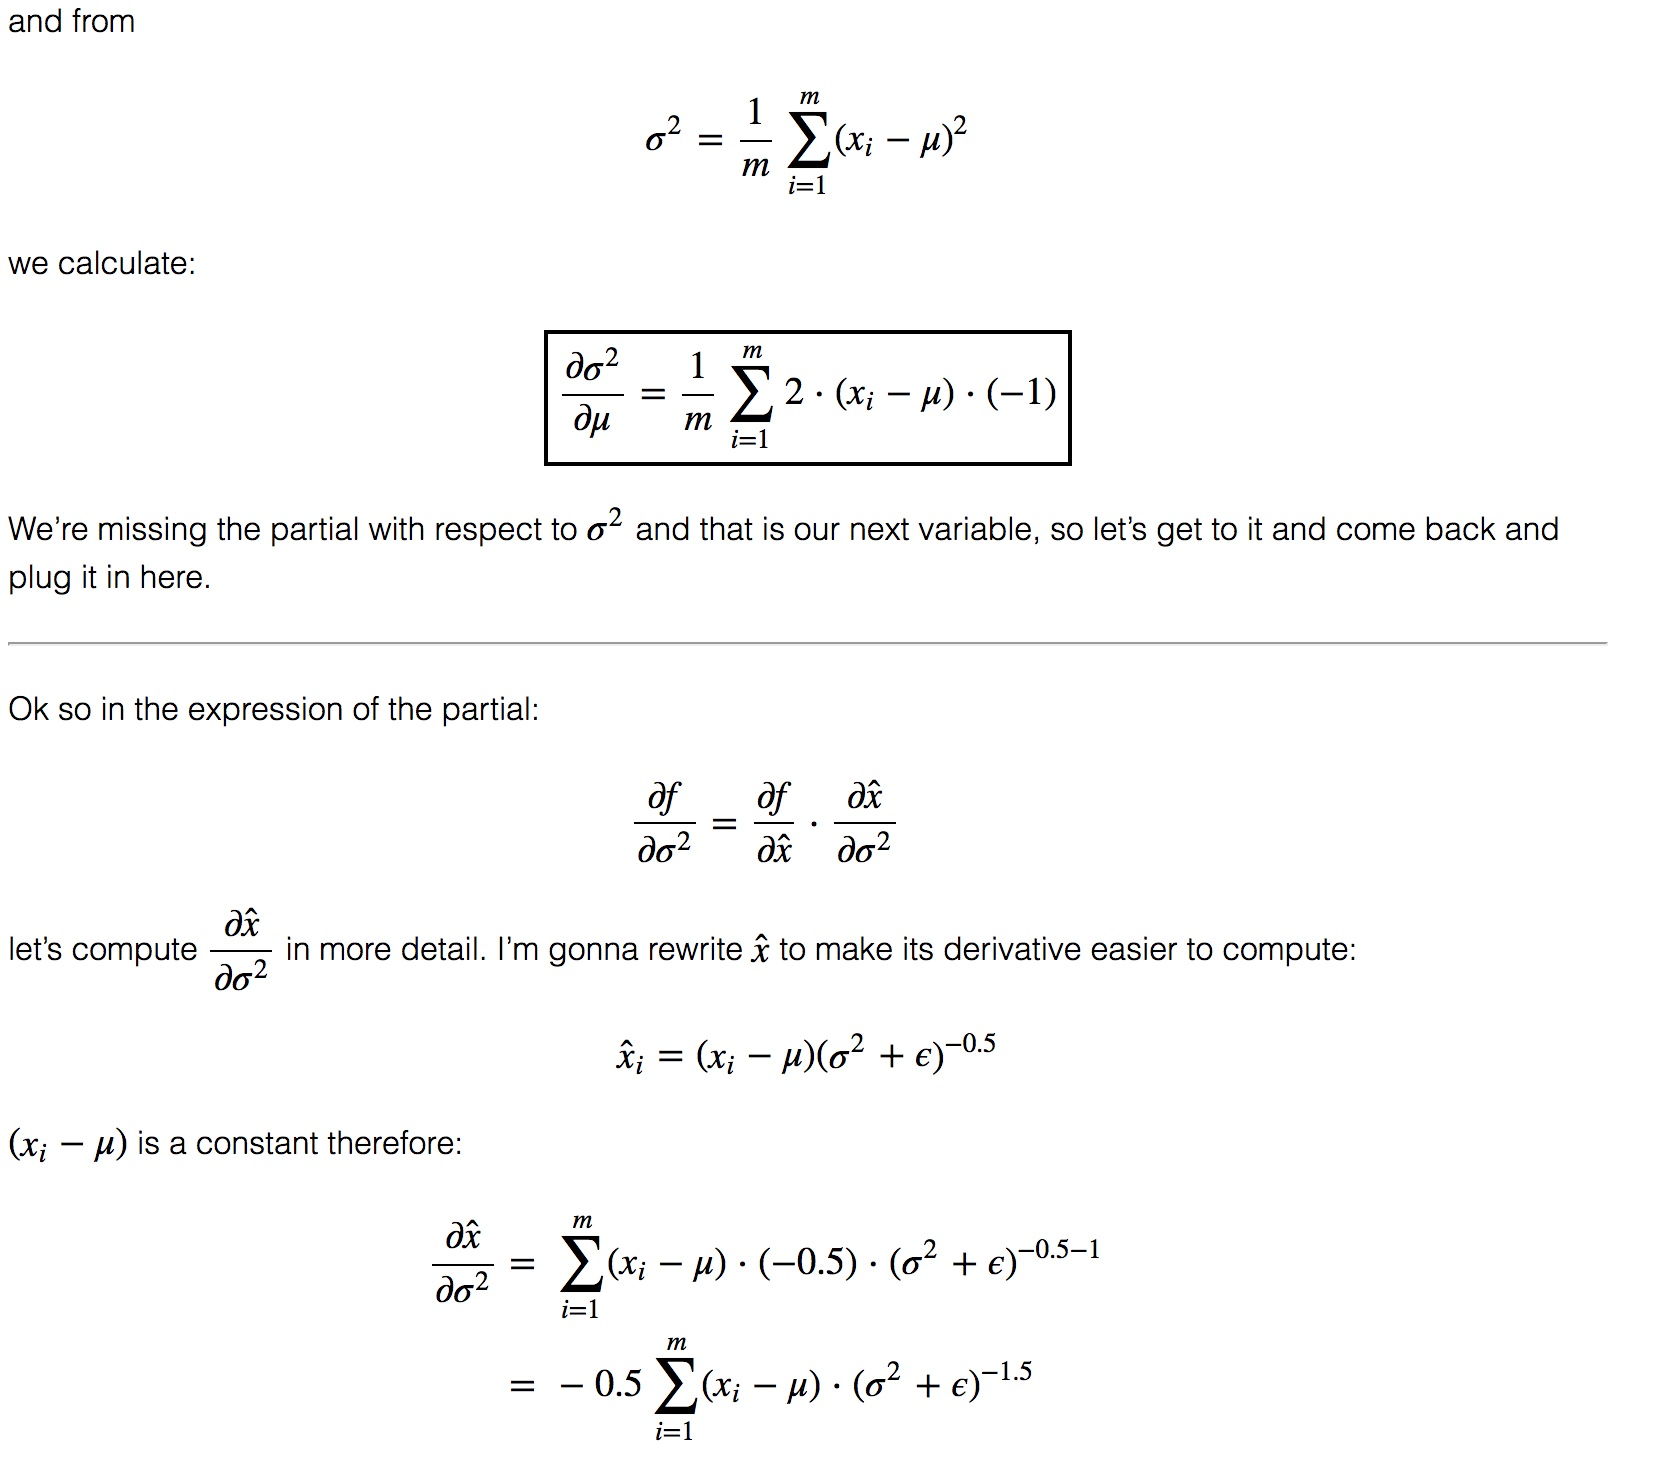
$\frac{\partial f}{\partial \mu} = \sum_{i = 1}^{m} \frac{\partial f}{\partial \hat{x}_{i}} \frac{\partial \hat{x}_{i}}{\partial \mu} + \frac{\partial f}{\partial \sigma^{2} } \frac{\partial \sigma^{2}}{\partial \mu}$
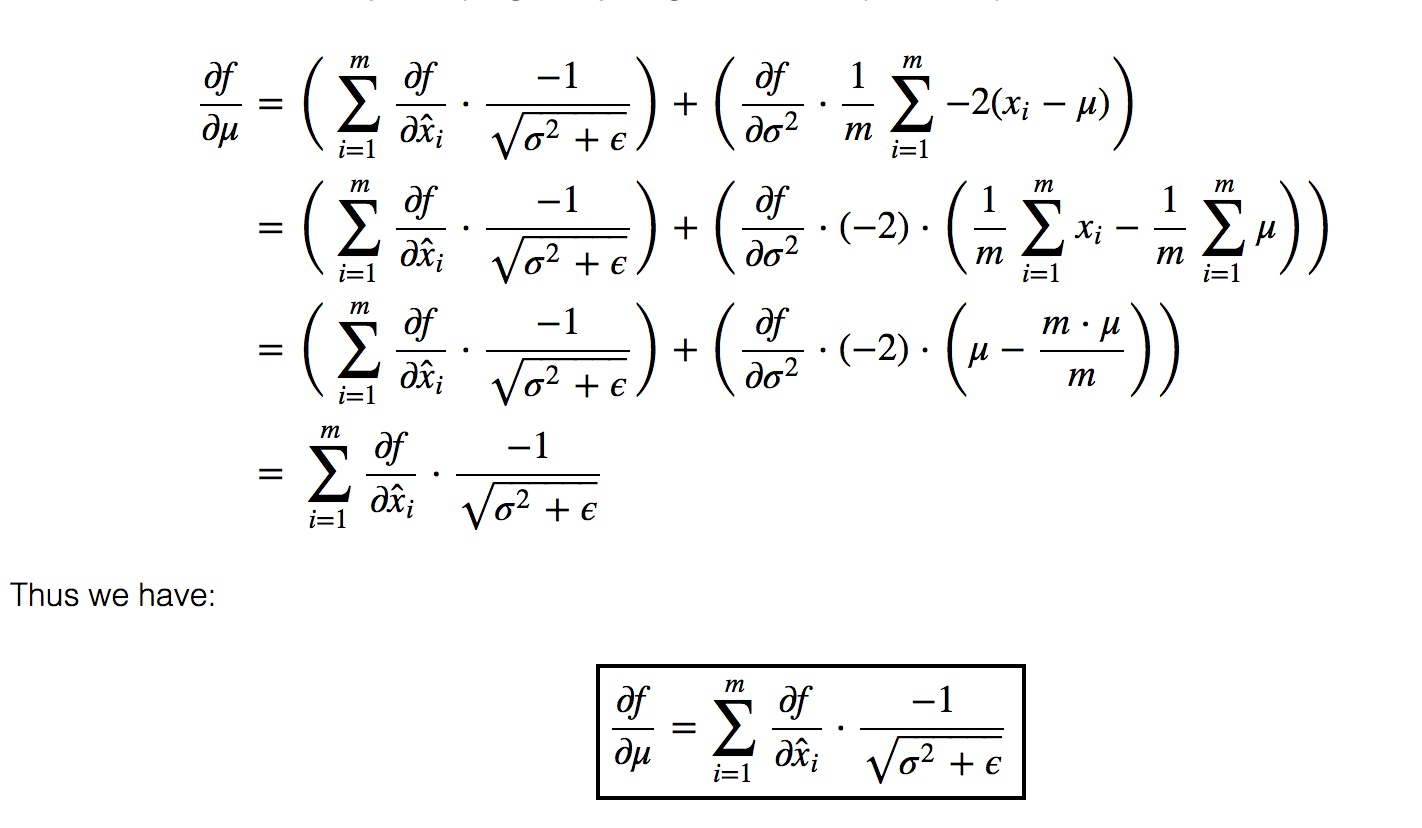
缺点:
1.对batchsize大小比较敏感,如果batchsize太不小计算的均值和方差不足以代表整体的数据分布
2.在RNN领域效果不是很好。为什么
BN是以每一个batch为基准进行计算的,也就是 μ.shape = (1, D), var.shape = (1, D),对于RNN来说,每一个batch中的数据可能不是等长的,即使padding后变成等长,然后在normalize就会引入噪声(padding)
2、Layer Normalization
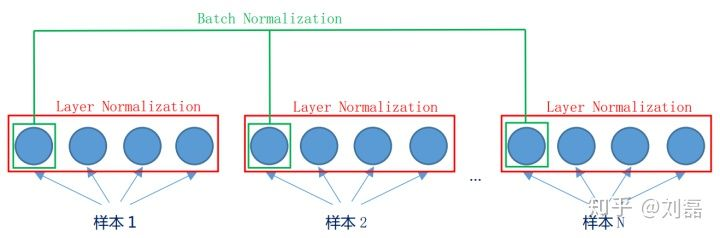
LN不以batch为单位,而是以一个样本为单位。
u.shape = (N, 1)
var.shape = (N, 1)
反向传播:
python实现:
tf接口
参考:
http://www.dataguru.cn/article-13031-1.html
https://www.cnblogs.com/guoyaohua/p/8724433.html
https://blog.csdn.net/leviopku/article/details/83109422
深度学习中优化【Normalization】的更多相关文章
- [优化]深度学习中的 Normalization 模型
来源:https://www.chainnews.com/articles/504060702149.htm 机器之心专栏 作者:张俊林 Batch Normalization (简称 BN)自从提出 ...
- 深度学习中的Normalization模型
Batch Normalization(简称 BN)自从提出之后,因为效果特别好,很快被作为深度学习的标准工具应用在了各种场合.BN 大法虽然好,但是也存在一些局限和问题,诸如当 BatchSize ...
- zz详解深度学习中的Normalization,BN/LN/WN
详解深度学习中的Normalization,BN/LN/WN 讲得是相当之透彻清晰了 深度神经网络模型训练之难众所周知,其中一个重要的现象就是 Internal Covariate Shift. Ba ...
- 深度学习中 Batch Normalization
深度学习中 Batch Normalization为什么效果好?(知乎) https://www.zhihu.com/question/38102762
- 深度学习中 Batch Normalization为什么效果好
看mnist数据集上其他人的CNN模型时了解到了Batch Normalization 这种操作.效果还不错,至少对于训练速度提升了很多. batch normalization的做法是把数据转换为0 ...
- 深度学习中batch normalization
目录 1 Batch Normalization笔记 1.1 引包 1.2 构建模型: 1.3 构建训练函数 1.4 结论 Batch Normalization笔记 我们将会用MNIST数 ...
- L19深度学习中的优化问题和凸性介绍
优化与深度学习 优化与估计 尽管优化方法可以最小化深度学习中的损失函数值,但本质上优化方法达到的目标与深度学习的目标并不相同. 优化方法目标:训练集损失函数值 深度学习目标:测试集损失函数值(泛化性) ...
- 深度学习中的batch_size,iterations,epochs等概念的理解
在自己完成的几个有关深度学习的Demo中,几乎都出现了batch_size,iterations,epochs这些字眼,刚开始我也没在意,觉得Demo能运行就OK了,但随着学习的深入,我就觉得不弄懂这 ...
- 深度学习中交叉熵和KL散度和最大似然估计之间的关系
机器学习的面试题中经常会被问到交叉熵(cross entropy)和最大似然估计(MLE)或者KL散度有什么关系,查了一些资料发现优化这3个东西其实是等价的. 熵和交叉熵 提到交叉熵就需要了解下信息论 ...
随机推荐
- Android为TV端助力转载:码农小阿飞(SpannableString)
用SpannableString打造绚丽多彩的文本显示效果 引语 TeXtView大家应该都不陌生,文本展示控件嘛! 就用TextView显示普普通通的文本,OK,很简单,Android入门的都会,没 ...
- ElasticSearch-6.3.2 linux 安装
在linux 系统安装ElasticSearch-6.3.2最新版本,也适合6.x 系列版本做参考 前提先在linux 安装好jdk1.8 创建用户 从5.0开始,ElasticSearch 安全级别 ...
- 突破瓶颈,再出发 - PM过程能力成熟度5级
尽管程度不同,但PM的每个级别都在践行过程改进,并在4级借助数据,达到了“登峰造极”的程度.随着量化与统计分析的深入,项目会被优化到极其稳定的状态,组织的过程改进也就此进入了平台期. 平台期可以被视为 ...
- docker容器安装vi (一般容器都是Debian GNU/Linux 9)
在使用docker容器时,同时你docker里的系统正好是debian或ubuntu的时候,有时候里边没有安装vim,敲vim命令时提示说:vim: command not found,这个时候就需要 ...
- 003_python中key为中文的处理
由于统计域名资产信息时,部门名称是中文的,但是还需要用这个部门名称进行字符的匹配运算,但不进行转换处理的话,它会报以下的错误: 解决方法如下: # -*- coding: utf-8 -*- all_ ...
- VSC 解决红底线问题
话不多说 设置里代码奉上 { "editor.minimap.enabled": false, "workbench.iconTheme": "vs ...
- python基础杂记
一.编码 1.ACSII 0000 0001 8位 一个字节 2. uncoide ...
- fullcalendar日历插件的使用并动态增删改查
我上个项目是做了一个关于教育方面的web端页面,其中的课程表就要用到fullcalendar日历插件,刚开始也是不会用,因为以前也没用过,后面也是看官方文档,问同事,最后完成了这个课程表,个人感觉fu ...
- 一键发布部署vs插件[AntDeploy],让net开发者更幸福
一键发布工具(ant deploy tool) 插件下载地址: https://marketplace.visualstudio.com/items?itemName=nainaigu.AntDepl ...
- Python协程的引入与原理分析
相关概念 并发:指一个时间段内,有几个程序在同一个cpu上运行,但是任意时刻只有一个程序在cpu上运行.比如说在一秒内cpu切换了100个进程,就可以认为cpu的并发是100. 并行:值任意时刻点上, ...