
java 读写Parquet格式的数据 Parquet example
import java.io.BufferedReader;

import java.io.File;

import java.io.FileReader;

import java.io.IOException;

import java.util.Random;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.log4j.Logger;

import org.apache.parquet.example.data.Group;

import org.apache.parquet.example.data.GroupFactory;

import org.apache.parquet.example.data.simple.SimpleGroupFactory;

import org.apache.parquet.hadoop.ParquetReader;

import org.apache.parquet.hadoop.ParquetReader.Builder;

import org.apache.parquet.hadoop.ParquetWriter;

import org.apache.parquet.hadoop.example.GroupReadSupport;

import org.apache.parquet.hadoop.example.GroupWriteSupport;

import org.apache.parquet.schema.MessageType;

import org.apache.parquet.schema.MessageTypeParser;

public class ReadParquet {

    static Logger logger=Logger.getLogger(ReadParquet.class);

    public static void main(String[] args) throws Exception {

//        parquetWriter("test\\parquet-out2","input.txt");

        parquetReaderV2("test\\parquet-out2");

    }

    static void parquetReaderV2(String inPath) throws Exception{

        GroupReadSupport readSupport = new GroupReadSupport();

        Builder<Group> reader= ParquetReader.builder(readSupport, new Path(inPath));

        ParquetReader<Group> build=reader.build();

        Group line=null;

        while((line=build.read())!=null){
      Group time= line.getGroup("time", 0);
        //通过下标和字段名称都可以获取
/*System.out.println(line.getString(0, 0)+"\t"+
line.getString(1, 0)+"\t"+
time.getInteger(0, 0)+"\t"+
time.getString(1, 0)+"\t");*/
System.out.println(line.getString("city", 0)+"\t"+
line.getString("ip", 0)+"\t"+
time.getInteger("ttl", 0)+"\t"+
time.getString("ttl2", 0)+"\t");
//System.out.println(line.toString());
        }

        System.out.println("读取结束");

    }

    //新版本中new ParquetReader()所有构造方法好像都弃用了,用上面的builder去构造对象

    static void parquetReader(String inPath) throws Exception{

        GroupReadSupport readSupport = new GroupReadSupport();

        ParquetReader<Group> reader = new ParquetReader<Group>(new Path(inPath),readSupport);

        Group line=null;

        while((line=reader.read())!=null){
          System.out.println(line.toString());
        }
        System.out.println("读取结束");

    }

    /**

     *

     * @param outPath  输出Parquet格式

     * @param inPath  输入普通文本文件

     * @throws IOException

     */

    static void parquetWriter(String outPath,String inPath) throws IOException{

        MessageType schema = MessageTypeParser.parseMessageType("message Pair {\n" +

                " required binary city (UTF8);\n" +

                " required binary ip (UTF8);\n" +

                " repeated group time {\n"+

                  " required int32 ttl;\n"+

                  " required binary ttl2;\n"+

                "}\n"+

              "}");

        GroupFactory factory = new SimpleGroupFactory(schema);

        Path path = new Path(outPath);

       Configuration configuration = new Configuration();

       GroupWriteSupport writeSupport = new GroupWriteSupport();

       writeSupport.setSchema(schema,configuration);

       ParquetWriter<Group> writer = new ParquetWriter<Group>(path,configuration,writeSupport);
    //把本地文件读取进去,用来生成parquet格式文件

       BufferedReader br =new BufferedReader(new FileReader(new File(inPath)));

       String line="";

       Random r=new Random();

       while((line=br.readLine())!=null){

           String[] strs=line.split("\\s+");

           if(strs.length==2) {

               Group group = factory.newGroup()

                       .append("city",strs[0])

                       .append("ip",strs[1]);

               Group tmpG =group.addGroup("time");

               tmpG.append("ttl", r.nextInt(9)+1);

               tmpG.append("ttl2", r.nextInt(9)+"_a");

               writer.write(group);

           }

       }

       System.out.println("write end");

       writer.close();

    }

}
说下schema(写Parquet格式数据需要schema,读取的话"自动识别"了schema)
/*

 * 每一个字段有三个属性:重复数、数据类型和字段名,重复数可以是以下三种:

 *         required(出现1次)

 *         repeated(出现0次或多次)

 *         optional(出现0次或1次)

 * 每一个字段的数据类型可以分成两种:

 *         group(复杂类型)

 *         primitive(基本类型)
 * 数据类型有
 * INT64, INT32, BOOLEAN, BINARY, FLOAT, DOUBLE, INT96, FIXED_LEN_BYTE_ARRAY
 */
这个repeated和required 不光是次数上的区别,序列化后生成的数据类型也不同,
比如repeqted修饰 ttl2 打印出来为 WrappedArray([7,7_a])
而 required修饰 ttl2 打印出来为 [7,7_a]
除了用MessageTypeParser.parseMessageType类生成MessageType 还可以用下面方法
(注意这里有个坑--spark里会有这个问题--ttl2这里 as(OriginalType.UTF8) 和 required binary city (UTF8)作用一样,加上UTF8,在读取的时候可以转为StringType,不加的话会报错 [B cannot be cast to java.lang.String  )
/*MessageType schema = MessageTypeParser.parseMessageType("message Pair {\n" +

                " required binary city (UTF8);\n" +

                " required binary ip (UTF8);\n" +

                "repeated group time {\n"+

                "required int32 ttl;\n"+

                "required binary ttl2;\n"+

                "}\n"+

                "}");*/

//import org.apache.parquet.schema.Types;

MessageType schema = Types.buildMessage()

           .required(PrimitiveTypeName.BINARY).as(OriginalType.UTF8).named("city")

           .required(PrimitiveTypeName.BINARY).as(OriginalType.UTF8).named("ip")

           .repeatedGroup().required(PrimitiveTypeName.INT32).named("ttl")

                            .required(PrimitiveTypeName.BINARY).as(OriginalType.UTF8).named("ttl2")

                            .named("time")

          .named("Pair");
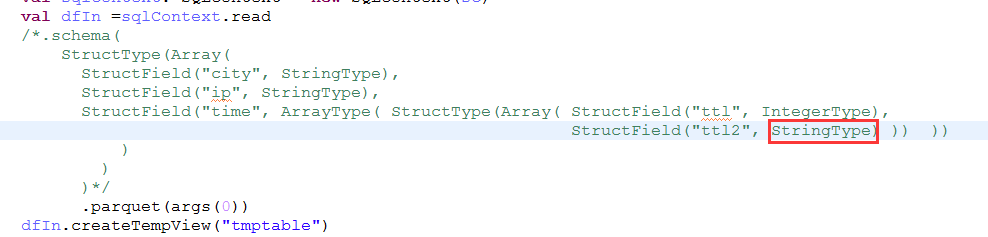
解决 [B cannot be cast to java.lang.String 异常:
1.要么生成parquet文件的时候加个UTF8
2.要么读取的时候再提供一个同样的schema类指定该字段类型,比如下面:
hadoop Mapreducer读写 Parquetexample
http://www.cnblogs.com/yanghaolie/p/7389543.html
maven依赖(我用的1.7)
<dependency>

    <groupId>org.apache.parquet</groupId>

    <artifactId>parquet-hadoop</artifactId>

    <version>1.7.0</version>

</dependency>
java 读写Parquet格式的数据 Parquet example的更多相关文章
- Android读写JSON格式的数据之JsonWriter和JsonReader
近期的好几个月都没有搞Android编程了,逐渐的都忘却了一些东西.近期打算找一份Android的工作,要继续拾起曾经的东西.公司月初搬家之后就一直没有网络,直到今日公司才有网络接入,各部门才開始办公 ...
- pandas(六)读写文本格式的数据
pandas提供的将表格型数据读取为DataFrame对象的函数. 函数 说明 read_csv 从文件.URL.文件型对象中加载带分隔符的数据.默认分隔符为逗号. read_table 从文件.UR ...
- JAVA 读取xml格式的数据
<?xml version="1.0" encoding="UTF-8"?> <column-enums> <type name= ...
- pandas 读写 Excel 格式的数据
import pandas as pd #读入数据: df = pd.read_excel('data_in.xlsx') #导出数据: writer = pd.ExcelWriter('data_o ...
- java 返回json格式的数据
1 阿里巴巴的fastjson import com.alibaba.fastjson.JSON; 使用的时候 JSON.toJSON(list); 2 Gson 解析json数据 import c ...
- learning java 读写其他进程的数据
import java.io.BufferedReader; import java.io.IOException; import java.io.InputStreamReader; public ...
- mapreduce 读写Parquet格式数据 Demo
import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs ...
- Hive 导入 parquet 格式数据
Hive 导入 parquet 数据步骤如下: 查看 parquet 文件的格式 构造建表语句 倒入数据 一.查看 parquet 内容和结构 下载地址 社区工具 GitHub 地址 命令 查看结构: ...
- 大数据学习day25------spark08-----1. 读取数据库的形式创建DataFrame 2. Parquet格式的数据源 3. Orc格式的数据源 4.spark_sql整合hive 5.在IDEA中编写spark程序(用来操作hive) 6. SQL风格和DSL风格以及RDD的形式计算连续登陆三天的用户
1. 读取数据库的形式创建DataFrame DataFrameFromJDBC object DataFrameFromJDBC { def main(args: Array[String]): U ...
随机推荐
- Python2.x升级python3.x【升级步骤和错误总结】
网上帖子一大堆,按照那些教程操作,确实可以成功安装.但是安装成功之后呢,pip还是用的python2的pip. 切换到python3的pip之后,发现无法下载模块,还会有很多报错信息.以及" ...
- 文件上传之靶场upload-labs (11-20)
第十一关 strrpos() 函数查找字符串在另一字符串中最后一次出现的位置 substr() 函数返回字符串的一部分 文件保存的方式是上传路径+随机时间+截取的文件后缀 其中上传路径可控,可以利用这 ...
- PHP接口并发测试的方法
PHP接口并发测试的方法 <pre> header('Content-type:text/html; Charset=utf-8'); $uri = "输入你的url" ...
- 【2】hexo+github搭建个人博客的简单使用
使用hexo+github搭建一个可以外网访问的个人博客,此文用于记录博客初级的使用方法. 新建-编写-生成-部署文章的全过程 1.使用cmd完成 打开命令提示符[win+r输入cmd] 切换到自己本 ...
- Blend 设置一个圆形的按钮
原文:Blend 设置一个圆形的按钮 1)画一个圆形 右击构成控件 3)选择button 当然如果想做成别的控件 都可以 4)我们有了一个button 5)做动画 6)定义触发器 7)定义事件 效果
- python 练习题:小明的成绩从去年的72分提升到了今年的85分,请计算小明成绩提升的百分点
# -*- coding: utf-8 -*- # 小明的成绩从去年的72分提升到了今年的85分,请计算小明成绩提升的百分点,并用字符串格式化显示出'xx.x%',只保留小数点后1位. s1 = 72 ...
- swagger 集成后发布到服务器报错[Could not find file 'D:\\home\\site\\wwwroot\\bin\\WebAPI.XML]
webapi集成swagger后,在本地运行没有问题,但是发布到服务器上就有问题. 报错信息:Could not find file 'D:\\home\\site\\wwwroot\\bin\\We ...
- PLSQL 登录时弹出(没有登录)空白提示框
如题,在登录的时候莫名出现了plsql登录时弹出(没有登录)的空白提示框,在网上找了很多方法之后都不行,然后发现plsql的 oracle主目录名莫名的成了空,然后直接重新把它的目录设置上 重启pls ...
- 两道JVM面试题,竟让我回忆起了中学时代!
作者:肥朝 原文链接:https://mp.weixin.qq.com/s/4wJ6ANal0blLOseasfIuVw 中学授课模式 考虑到可能有部分粉丝对JVM参数不清楚,所以我们参照中学的授课模 ...
- 线程状态---Day24
线程状态概述: 当线程被创建并启动以后,它既不是一启动就进入了执行状态,也不是一直处于执行状态.在线程的生命周期中, 有几种状态呢?在API中 java.lang.Thread.State 这个枚举中 ...