
Java爬虫爬取京东商品信息
以下内容转载于《https://www.cnblogs.com/zhuangbiing/p/9194994.html》,在此仅供学习借鉴只用。
Maven地址
<dependency>
<!-- jsoup HTML parser library @ https://jsoup.org/ -->
<groupId>org.jsoup</groupId>
<artifactId>jsoup</artifactId>
<version>1.11.2</version>
</dependency>
网页分析:
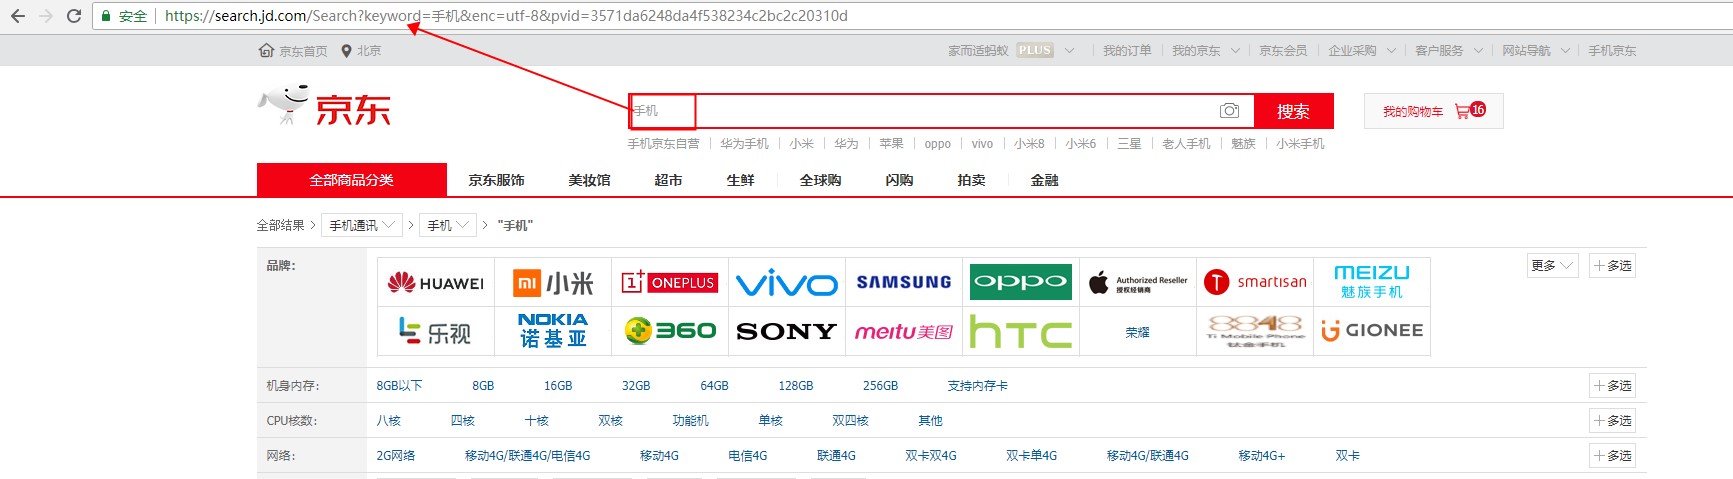
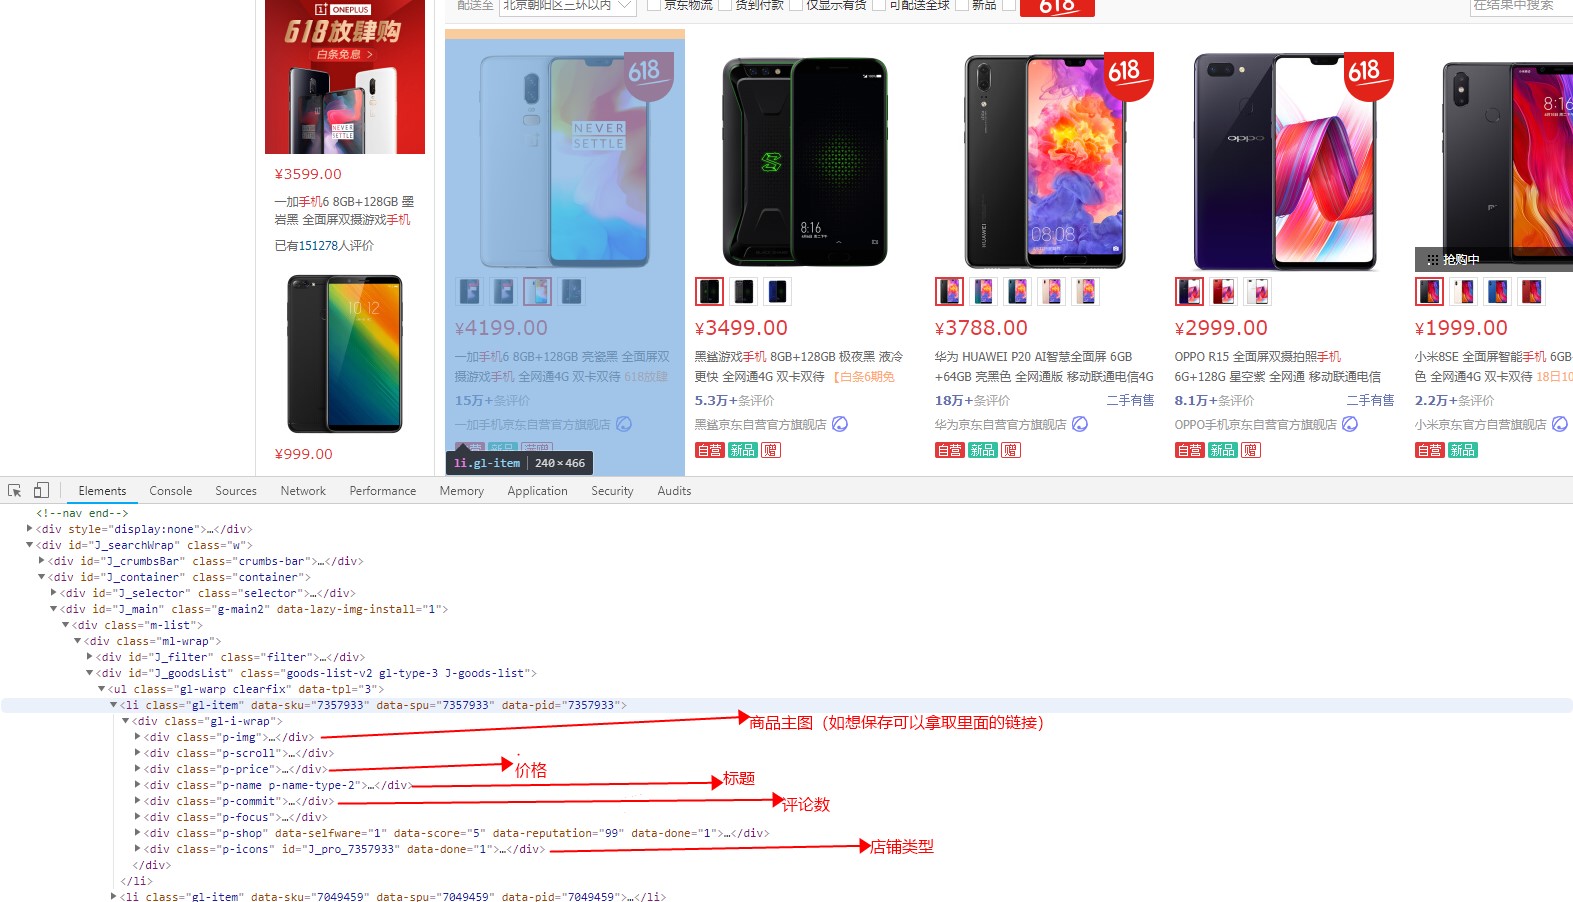
商品布局分析:
测试代码实例:
import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

/**

 * 作者:小鱼

 * 作者唯一QQ号:1132017151

 *

 * 简单测试类

 * 包含内容:京东商品页查询

 * 不包含京东商品排除个性化查询和后半部动态加载,如有想要了解,请联系作者

 * */

public class Test {

    public static void main(String[] args) throws Exception {

        String url = "https://search.jd.com/Search?keyword=%E6%89%8B%E6%9C%BA&enc=utf-8&psort=3&page=3";//第二页商品

        //网址分析

        /*keyword:关键词(京东搜索框输入的信息)

         * enc:编码方式(可改动:默认UTF-8)

         * psort=3 //搜索方式  默认按综合查询 不给psort值

         * page=分业(不考虑动态加载时按照基数分业,每一页30条,这里就不演示动态加载)

         * 注意:受京东商品个性化影响,准确率无法保障

         * */

        Document doc = Jsoup.connect(url).maxBodySize(0).get();

        //doc获取整个页面的所有数据

        Elements ulList = doc.select("ul[class='gl-warp clearfix']");

        Elements liList = ulList.select("li[class='gl-item']");

        //循环liList的数据

        for (Element item : liList) {

            //排除广告位置

            if (!item.select("span[class='p-promo-flag']").text().trim().equals("广告")) {

                //如果向存到数据库和文件里请自行更改

                System.out.println(item.select("div[class='p-name p-name-type-2']").select("em").text());//打印商品标题到控制台

            }

        }

    }

}
运行结果:

Java爬虫爬取京东商品信息的更多相关文章
- Python爬虫-爬取京东商品信息-按给定关键词
目的:按给定关键词爬取京东商品信息,并保存至mongodb. 字段:title.url.store.store_url.item_id.price.comments_count.comments 工具 ...
- selenium模块使用详解、打码平台使用、xpath使用、使用selenium爬取京东商品信息、scrapy框架介绍与安装
今日内容概要 selenium的使用 打码平台使用 xpath使用 爬取京东商品信息 scrapy 介绍和安装 内容详细 1.selenium模块的使用 # 之前咱们学requests,可以发送htt ...
- selenium+phantomjs爬取京东商品信息
selenium+phantomjs爬取京东商品信息 今天自己实战写了个爬取京东商品信息,和上一篇的思路一样,附上链接:https://www.cnblogs.com/cany/p/10897618. ...
- python制作爬虫爬取京东商品评论教程
作者:蓝鲸 类型:转载 本文是继前2篇Python爬虫系列文章的后续篇,给大家介绍的是如何使用Python爬取京东商品评论信息的方法,并根据数据绘制成各种统计图表,非常的细致,有需要的小伙伴可以参考下 ...
- 八个commit让你学会爬取京东商品信息
我发现现在不用标题党的套路还真不好吸引人,最近在做相关的事情,从而稍微总结出了一些文字.我一贯的想法吧,虽然才疏学浅,但是还是希望能帮助需要的人.博客园实在不适合这种章回体的文章.这里,我贴出正文的前 ...
- 利用selenium爬取京东商品信息存放到mongodb
利用selenium爬取京东商城的商品信息思路: 1.首先进入京东的搜索页面,分析搜索页面信息可以得到路由结构 2.根据页面信息可以看到京东在搜索页面使用了懒加载,所以为了解决这个问题,使用递归.等待 ...
- 正则爬取京东商品信息并打包成.exe可执行程序。
本文爬取内容,输入要搜索的关键字可自动爬取京东网站上相关商品的店铺名称,商品名称,价格,爬取100页(共100页) 代码如下: import requests import re # 请求头 head ...
- 正则爬取京东商品信息并打包成.exe可执行程序
本文爬取内容,输入要搜索的关键字可自动爬取京东网站上相关商品的店铺名称,商品名称,价格,爬取100页(共100页) 代码如下: ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 1 ...
- python爬虫——用selenium爬取京东商品信息
1.先附上效果图(我偷懒只爬了4页) 2.京东的网址https://www.jd.com/ 3.我这里是不加载图片,加快爬取速度,也可以用Headless无弹窗模式 options = webdri ...
随机推荐
- SQL语句复习【专题七】
SQL语句复习[专题七] 完整性约束分类1)域完整性约束(非空not null,检查check)2)实体完整性约束(唯一unique,主键primary key)3)参照完整性约束(外键foreign ...
- 2.java多线程_synchronized(Lock)同步
1.synchronized同步关键词 线程安全是并发编程中的重要关注点,应该注意到的是,造成线程安全问题的主要诱因有两点,一是存在共享数据(也称临界资源),二是存在多条线程共同 操作共享数据.因此为 ...
- NTP时间同步服务和DNS服务
NTP服务是搭建集群的第一步,是保持时间的同步性,保持一致 服务端 首先下载 yum install ntp –y 而后打开配置文件 /etc/ntp.conf 配置文件里有很多内容,但只要留三行就足 ...
- Nginx常见错误及处理方法(转)
404 bad request 一般原因:请求的Header过大 解决方法:配置nginx.conf相关设置 client_header_buffer_size 16k; large_client_h ...
- Some notes of The Peter Principle
管理学读书笔记之彼得原理 chapter0 绪论为什么有这么多不称职现象?姑息错误或纵容懒惰.偶然事故都不是问题根源,关键是我们的社会为不称职现象提供土壤,并对其有所鼓励. chapter1 彼得原理 ...
- qt libusb
https://github.com/Kakadu/Qt_libusb https://github.com/mcvsama/libusbcc/tree/master/src/libusbcc htt ...
- java学习笔记(二)分布式框架Dubbo+zookeeper搭建
参考文章http://www.cnblogs.com/sxjun/p/6963844.html 注意的几个问题: 1.配置dubbo.properties 将以下地址改为你Zookeeper注册的地址 ...
- 201871010126 王亚涛 《面向对象程序设计 (Java)》第十七周学习总结
内容 这个作业属于哪个课程 https://www.cnblogs.com/nwnu-daizh/ 这个作业的要求在哪里 https://www.cnblogs.com/nwnu-daizh/p/12 ...
- 1 request模块
官方文档真是好用的一匹 官方文档:https://2.python-requests.org//zh_CN/latest/index.html 参考blog:https://www.cnblogs.c ...
- 基于node.js的websocket 前后端交互小功能
一.node var ws = require("nodejs-websocket"); console.log("开始建立连接...") var server ...