
pickel加速caffe读图
64*64*3小图(12KB),batchSize=128,训练样本100万,
全部load进来内存受不了,load一次需要大半天
训练时读入一个batch,ali云服务器上每个batch读入时间1.9~3.2s不等,迭代一次2s多
由于有多个label不能用caffe自带的lmdb转了,输入是自己写的python层,试着用pickel
import os, sys

import cv2

import numpy as np

import numpy.random as npr

import cPickle as pickle

wk_dir = "/Users/xxx/wkspace/caffe_space/detection/caffe/data/1103reg64/"

InputSize = int(sys.argv[1])

BatchSize = int(sys.argv[2])

trainfile = "train.txt"

testfile = "test.txt"

print "gen imdb with for net input:", InputSize, "batchSize:", BatchSize

with open(wk_dir+trainfile, 'r') as f:

    trainlines = f.readlines()

with open(wk_dir+testfile, 'r') as f:

    testlines = f.readlines()

#######################################

# we seperate train data by batchsize #

#######################################

to_dir = wk_dir + "/trainIMDB/"

if not os.path.isdir(to_dir):

    os.makedirs(to_dir)

train_list = []

cur_ = 0

sum_ = len(trainlines)

for line in trainlines:

    cur_ += 1

    words = line.split()

    image_file_name = words[0]

    im = cv2.imread(wk_dir + image_file_name)

    h,w,ch = im.shape

    if h!=InputSize or w!=InputSize:

        im = cv2.resize(im,(InputSize,InputSize))

    roi = [float(words[2]),float(words[3]),float(words[4]),float(words[5])]

    train_list.append([im, roi])

    if (cur_ % BatchSize == 0):

        print "write batch:" , cur_/BatchSize

        fid = open(to_dir +'train'+ str(BatchSize) + '_'+str(cur_/BatchSize),'w')

        pickle.dump(train_list, fid)

        fid.close()

        train_list[:] = []

print len(train_list), "train data generated\n"

###########################

# tests #

###########################

to_dir = wk_dir + "/testIMDB/"

if not os.path.isdir(to_dir):

    os.makedirs(to_dir)

test_list = []

cur_ = 0

sum_ = len(testlines)

for line in testlines:

   cur_ += 1

   words = line.split()

   image_file_name = words[0]

   im = cv2.imread(wk_dir + image_file_name)

   h,w,ch = im.shape

   if h!=InputSize or w!=InputSize:

       im = cv2.resize(im,(InputSize,InputSize))

   roi = [float(words[2]),float(words[3]),float(words[4]),float(words[5])]

   test_list.append([im, roi])

   if (cur_ % BatchSize == 0):

       print "write batch:", cur_ / BatchSize

       fid = open(to_dir +'test'+ str(BatchSize) + '_'+str(cur_/BatchSize), 'w')

       pickle.dump(test_list, fid)

       fid.close()

       test_list[:] = []

print len(test_list), "test data generated\n"
每个batch生成4.8MB的块(约比128张原图占3倍磁盘空间):
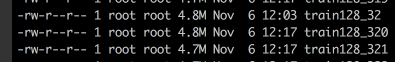
训练时读入,ali云训练每个batch时间变为0.2s,可加速10倍
mac上是ssd硬盘,本来读图就很快,一个batch 0.05s, 改成pickel后反而变慢了,load一个batch需要0.2s。
pickel加速caffe读图的更多相关文章
- matlab读图函数
最基本的读图函数:imread imread函数的语法并不难,I=imread('D:\fyc-00_1-005.png');其中括号内写图片所在的完整路径(注意路径要用单引号括起来).I代表这个图片 ...
- LM_ReadImgMode.js PC单页轮播读图模式组件,零依赖!
LM_ReadImgMode.js PC单页轮播读图模式组件,零依赖! github:http://dtdxrk.github.io/LM-ReadImgMode/ TXT 1.全新的2.0版本,脱离 ...
- Windows下利用MKL加速caffe,与openblas比较
一.介绍:先简单Mark一下网上的介绍资料,弄清楚MKL是个啥,已经与openblas等的关系. 矩阵运算库blas, cblas, openblas, atlas, lapack, mkl之间有什么 ...
- [Caffe] ubuntu14.04下使用OpenBLAS加速Caffe
一.apt安装 sudo apt-get install libopenblas-dev 二.手动从source安装 1. 下载OpenBLAS并编译 git clone https://github ...
- kibana限制用户只具备读图的权限
假设需求 因为业务需要将日志系统收集到的信息进行图表化展示并交付到用户进行业务交流. 解决方案 这个需求看着似乎蛮简单的,如何解决? 1.对需要的数据进行过滤制作图表 2.对用户的权限限制为只读级别, ...
- C++ opencv高速样例学习——读图显示
1.关键函数 1. 读入图片 imread(图片或位置,显示格式)默觉得:IMREAD_COLOR 显示格式: IMREAD_UNCHANGED =-1 // 8bit, color or no ...
- 用python Image读图
https://www.cnblogs.com/kongzhagen/p/6295925.html import os name = [] with open('/media/hdc/xing/Dee ...
- TensorRT加速 ——NVIDIA终端AI芯片加速用,可以直接利用caffe或TensorFlow生成的模型来predict(inference)
官网:https://developer.nvidia.com/tensorrt 作用:NVIDIA TensorRT™ is a high-performance deep learning inf ...
- Caffe学习系列(21):caffe图形化操作工具digits的安装与运行
经过前面一系列的学习,我们基本上学会了如何在linux下运行caffe程序,也学会了如何用python接口进行数据及参数的可视化. 如果还没有学会的,请自行细细阅读: caffe学习系列:http:/ ...
随机推荐
- MongDB 数据结构
Object ID :Documents 自生成的 _id String: 字符串,必须是utf-8 Boolean:布尔值,true 或者false (这里有坑哦~在我们大Python中 True ...
- Java Web 禁用Cookie对Session的影响
如果客户端禁用了Cookie,那么服务端就不能得到Session了.因为通过Session ID来确定当前会话对应的服务端Session,而Session ID通过Cookie来传递,所以禁用Cook ...
- HDU 2008 数值统计
题目链接:HDU 2008 Description 统计给定的n个数中,负数.零和正数的个数. Input 输入数据有多组,每组占一行,每行的第一个数是整数n(n<100),表示需要统计的数值的 ...
- 用cocoapods导入第三方库,找不到对应的文件
解决办法 1.找到TARGETS -> Build Settings -> SearchPaths -> User Header Search Paths 在后面的空白处双击 2. ...
- ant design select placeholder不生效原因
当select的value绑定一个state默认值时,如果默认值是''或null时,placeholder不生效 解决方案:默认值设为undefined
- mysql - Truncated incorrect DOUBLE value: 'undefined'
mysql - Truncated incorrect DOUBLE value: 'undefined' 我是怎么遇到这个问题的? 我要从多个表里,查询统计数据,保存到统计表里,需要执行下面这种结构 ...
- Python全栈-magedu-2018-笔记10
第三章 - Python 内置数据结构 集set 约定 set 翻译为集合 collection 翻译为集合类型,是一个大概念 set 可变的.无序的.不重复的元素的集合 set定义 初始化 set( ...
- JS操作字符串
JS操作字符串 1.函数:split() 把字符串按分隔符分割成数组. 语法:字符串.split(separator,limit); separator:分隔符. 功能:使用一个指定的分隔符把一个字符 ...
- Linux技术栈整理一:系统体系结构
Linux操作系统必备的硬件构造: CPU 主板 显卡 硬盘 网卡 外设(键鼠-输入设备 / 显示器-输出设备) 内核管理调度: 内核体系结构: 来源于:极客专栏
- Python的基本语法1
一.python的基本数据类型 (1)6种基本数据类型 1.数字类型 int 整数,2,0,-4等 float 浮点数,如1.2,-0.3等 bool 布尔类型,True,False complex ...