
ShardingJDBC(一)-转载
Sharding-JDBC:垂直拆分怎么做?
经过读写分离的优化后,小王可算是轻松了一段时间,读写分离具体的方案请查看这篇文章:Sharding-JDBC:查询量大如何优化?
可是好景不长,业务发展是在太快了。数据库中的数据量猛增,由于所有表都在一个数据库中,导致服务器本地存储快满了。
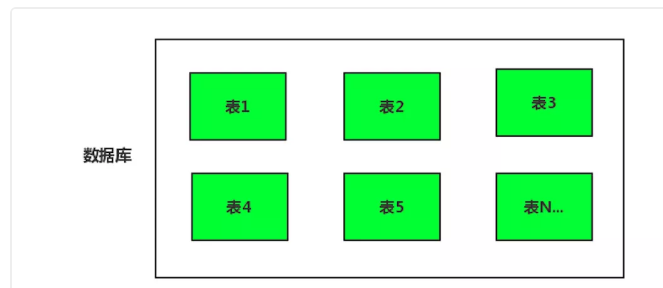
从上图我们可以看的出来,由于表的数量较多,每个表的数据量也较大,但是还没到水平拆分的地步。目前遇到的问题是服务器的存储不够了,短期内还不用水平拆分,那么方案呼之欲出了:垂直拆分。
解释下什么是垂直拆分?
我们都知道,一个数据库它是由N张表构成,每个表存储的数据都不一样,都对应着各自的业务。
所谓的垂直切分其实就是分类存储,大部分都是按业务类型进行分类。相同的类型存储在相同的库上,不同的类型存储在不同的库上,这样也就将数据或者说压力分担到不同的库上面 。
比如我们可以将用户相关的放一起,订单相关的放一起,行为日志相关的放一起,依次来推下去。
优点:
拆分之后业务规划清晰,数据维护简单,分担了数据集中存储的压力。
缺点:
缺点也很明显,多表join查询无法实现,只能通过接口方式解决,提高了系统复杂度等问题。
做垂直拆分其实跟读写分离是一样的,本质上还是多数据源的问题,本文中先考虑最简单的垂直拆分方式,垂直拆分+读写分离我们下篇文章进行讲解。
垂直拆分步骤
至于怎么整合Sharding-JDBC就不在讲解了,上篇文章有讲解过,直接开始和兴步骤。
假设我们拆分成了2个库,分别是ds0和ds1,每个库中的表不同,ds_0中放了user表,SQL脚本如下:
CREATE DATABASE `ds_0` CHARACTER SET 'utf8' COLLATE 'utf8_general_ci';CREATE TABLE `user`(id bigint(64) not null,city varchar(20) not null,name varchar(20) not null,PRIMARY KEY (`id`)) ENGINE=InnoDB DEFAULT CHARSET=utf8;
ds_1中放了loudong表,SQL脚本如下:
CREATE DATABASE `ds_1` CHARACTER SET 'utf8' COLLATE 'utf8_general_ci';CREATE TABLE `loudong` (`id` varchar(20) NOT NULL,`city` varchar(20) NOT NULL,`region` varchar(20) NOT NULL,`name` varchar(20) NOT NULL,`ld_num` varchar(10) NOT NULL,`unit_num` varchar(10) NOT NULL,PRIMARY KEY (`id`)) ENGINE=InnoDB DEFAULT CHARSET=utf8
最核心的还是数据源的配置以及绑定:
spring.shardingsphere.datasource.names=ds0,ds1# ds0数据源spring.shardingsphere.datasource.ds0.type=com.alibaba.druid.pool.DruidDataSourcespring.shardingsphere.datasource.ds0.driver-class-name=com.mysql.jdbc.Driverspring.shardingsphere.datasource.ds0.url=jdbc:mysql://localhost:3306/ds_0?characterEncoding=utf-8spring.shardingsphere.datasource.ds0.username=rootspring.shardingsphere.datasource.ds0.password=123456# ds1数据源spring.shardingsphere.datasource.ds1.type=com.alibaba.druid.pool.DruidDataSourcespring.shardingsphere.datasource.ds1.driver-class-name=com.mysql.jdbc.Driverspring.shardingsphere.datasource.ds1.url=jdbc:mysql://localhost:3306/ds_1?characterEncoding=utf-8spring.shardingsphere.datasource.ds1.username=rootspring.shardingsphere.datasource.ds1.password=123456# 绑定loudong表所在节点spring.shardingsphere.sharding.tables.loudong.actual-data-nodes=ds1.loudong# 绑定user表所在节点spring.shardingsphere.sharding.tables.user.actual-data-nodes=ds0.user# 设置自增IDspring.shardingsphere.sharding.tables.user.key-generator.column=id# 设置自增ID算法spring.shardingsphere.sharding.tables.user.key-generator.type=SNOWFLAKE
配置完之后该怎么用还是怎么用,完全不用改变一行代码。sharding-jdbc底层会对数据源进行接管。
如果我们不用sharding-jdbc的话,你同样需要配置2个数据源,这个其实差不多,最复杂的就是你在操作数据库的时候需要知道当前的操作是哪个数据源,因为每个数据源中的表都不一样,通过sharding-jdbc框架屏蔽了这些复杂的操作。
垂直拆分下的读写分离步骤
从最开始的单库多表,到读写分离,再到垂直拆分多个库。
循序渐进的为大家讲解高并发,大数据量下的数据库解决方案。并引入开源的Sharding-JDBC来实现具体的方案。
垂直拆分后进一步提升性能的方式就是垂直拆分多库的读写分离,如下图:
要实习这个功能,我们只需要在上面的基础上,为每个库增加一个从节点的配置就可以了,然后用master-slave-rules将主从数据源进行绑定,如下:
spring.shardingsphere.datasource.names=ds0,ds0slave,ds1,ds1slave# ds0主数据源spring.shardingsphere.datasource.ds0.type=com.alibaba.druid.pool.DruidDataSourcespring.shardingsphere.datasource.ds0.driver-class-name=com.mysql.jdbc.Driverspring.shardingsphere.datasource.ds0.url=jdbc:mysql://localhost:3306/ds_0?characterEncoding=utf-8spring.shardingsphere.datasource.ds0.username=rootspring.shardingsphere.datasource.ds0.password=123456# ds0从数据源spring.shardingsphere.datasource.ds0slave.type=com.alibaba.druid.pool.DruidDataSourcespring.shardingsphere.datasource.ds0slave.driver-class-name=com.mysql.jdbc.Driverspring.shardingsphere.datasource.ds0slave.url=jdbc:mysql://localhost:3306/ds0slave?characterEncoding=utf-8spring.shardingsphere.datasource.ds0slave.username=rootspring.shardingsphere.datasource.ds0slave.password=123456# ds1主数据源spring.shardingsphere.datasource.ds1.type=com.alibaba.druid.pool.DruidDataSourcespring.shardingsphere.datasource.ds1.driver-class-name=com.mysql.jdbc.Driverspring.shardingsphere.datasource.ds1.url=jdbc:mysql://localhost:3306/ds_1?characterEncoding=utf-8spring.shardingsphere.datasource.ds1.username=rootspring.shardingsphere.datasource.ds1.password=123456# ds1从数据源spring.shardingsphere.datasource.ds1slave.type=com.alibaba.druid.pool.DruidDataSourcespring.shardingsphere.datasource.ds1slave.driver-class-name=com.mysql.jdbc.Driverspring.shardingsphere.datasource.ds1slave.url=jdbc:mysql://localhost:3306/ds1slave?characterEncoding=utf-8spring.shardingsphere.datasource.ds1slave.username=rootspring.shardingsphere.datasource.ds1slave.password=123456# 绑定loudong表所在节点spring.shardingsphere.sharding.tables.loudong.actual-data-nodes=ds1.loudong# 绑定user表所在节点spring.shardingsphere.sharding.tables.user.actual-data-nodes=ds0.userspring.shardingsphere.sharding.tables.user.key-generator.column=idspring.shardingsphere.sharding.tables.user.key-generator.type=SNOWFLAKE# 读写分离spring.shardingsphere.sharding.master-slave-rules.ds0.master-data-source-name=ds0spring.shardingsphere.sharding.master-slave-rules.ds0.slave-data-source-names=ds0slavespring.shardingsphere.sharding.master-slave-rules.ds1.master-data-source-name=ds1spring.shardingsphere.sharding.master-slave-rules.ds1.slave-data-source-names=ds1slave
源码参考:https://github.com/yinjihuan/sharding-jdbc
觉得不错的记得关注下哦,给个Star吧!
ShardingJDBC(一)-转载的更多相关文章
- Sharding-JDBC实践(一)简介
转载自:ShardingSphere官网 目录 一.介绍 1. Sharding-JDBC 2. Sharding-Proxy 3. Sharding-Sidecar(TBD) 4. 混合架构 二.功 ...
- sharding-jdbc之——分库分表实例
转载请注明出处:http://blog.csdn.net/l1028386804/article/details/79368021 一.概述 之前,我们介绍了利用Mycat进行分库分表操作,Mycat ...
- 分布式数据库中间件、产品——sharding-jdbc、mycat、drds
一般对于业务记录类随时间会不断增加的数据,当数据量增加到一定量(一般认为整型值为主的表达到千万级,字符串为主的表达到五百万)的时候,性能将遇到瓶颈,同时调整表结构也会变得非常困难.为了避免生产遇到这样 ...
- sharding-JDBC学习笔记
sharding-JDBC学习笔记 ShardingSphere ShardingSphere是一套开源的分布式数据库中间件解决方案组成的生态圈,它由Sharding-JDBC.Sharding-Pr ...
- ShardingJDBC的基本配置和使用
一.ShardingSphere介绍 ShardingSphere是一套开源的分布式数据库中间件解决方案组成的生态圈,它由Sharding-JDBC.Sharding-Proxy和Sharding-S ...
- 基于ShardingJDBC的分库分表详细整理
转载 https://www.cnblogs.com/jackion5/p/13658615.html 前言 传统应用项目设计通常都是采用单一数据库作为存储方案,但是随着互联网的迅猛发展以及应用数据量 ...
- Crystal Clear Applied: The Seven Properties of Running an Agile Project (转载)
作者Alistair Cockburn, Crystal Clear的7个成功要素,写得挺好. 敏捷方法的关注点,大家可以参考,太激动所以转载了. 原文:http://www.informit.com ...
- RTP与RTCP协议介绍(转载)
RTSP发起/终结流媒体.RTP传输流媒体数据 .RTCP对RTP进行控制,同步.RTP中没有连接的概念,本身并不能为按序传输数据包提供可靠的保证,也不提供流量控制和拥塞控制,这些都由RTCP来负责完 ...
- 《Walking the callstack(转载)》
本文转载自:https://www.codeproject.com/articles/11132/walking-the-callstack Download demo project with so ...
随机推荐
- PHP之冒泡排序的优化
冒泡排序是一个常见的排序算法,它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序错误就把他们交换过来.走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成. 对于冒泡排序 ...
- linux命令学习笔记(0):man命令
Linux提供了丰富的帮助手册,当你需要查看某个命令的参数时不必到处上网查找,只要man一下即可. Linux的man手册共有以下几个章节: 代號 代表內容 使用者在shell中可以操作的指令或可执行 ...
- Struts2 - ModelDriven 拦截器、Preparable 拦截器
开篇:拦截器在Struts中的作用 在我们的web.xml中,我们配置了一个过滤器,实现将所有请求交付StrutsPrepareAndExecuteFilter类.一旦接受到任意action的请求,该 ...
- OpenCV-Python sift/surf特征匹配与显示
import cv2 import numpy as np def drawMatchesKnn_cv2(img1_gray,kp1,img2_gray,kp2,goodMatch): h1, w1 ...
- NYOJ-求逆序数 ----------------待解决,WA
描述 在一个排列中,如果一对数的前后位置与大小顺序相反,即前面的数大于后面的数,那么它们就称为一个逆序.一个排列中逆序的总数就称为这个排列的逆序数. 现在,给你一个N个元素的序列,请你判断出它的逆序数 ...
- 【Caffe】Ubuntu 安装 Caffe gpu版
安装环境:Ubuntu 16.04lts 64位, gcc5.4 gpu1050ti,cuda8.0,cudnn5.1.10 1. 安装依赖库 sudo apt-get install libprot ...
- Sublime Text2中Evernote 插件的使用
Sublime Text2是个强大的编辑器, 有好多插件供我们使用, 其中有个插件SublimeEvernote, 可以把代码发送到Evernote里. 但是没找见使用说明, 今天看了下Sublime ...
- python 3中使用getattr和*args时, 出现传入参数不一致的问题
今天在用python3的getattr时遇到一个问题, 就是老提示传入参数和函数前面不一致, 代码为: class Test: def __init__(self, name): ...
- live555源代码分析
live555源代码下载(VC6工程):http://download.csdn.net/detail/leixiaohua1020/6374387 liveMedia 项目(http://www.l ...
- java代码简单练习
总结: package com.ds; import java.awt.Color; import java.awt.FlowLayout; import javax.swing.JFrame; im ...