
排序—时间复杂度为O(n2)的三种排序算法
1 如何评价、分析一个排序算法?
很多语言、数据库都已经封装了关于排序算法的实现代码。所以我们学习排序算法目的更多的不是为了去实现这些代码,而是灵活的应用这些算法和解决更为复杂的问题,所以更重要的是学会如何评价、分析一个排序算法并在合适的场景下正确使用。
分析一个排序算法,主要从以下3个方面入手:
1.1 排序算法的执行效率
1)最好情况、最坏情况和平均情况时间复杂度
待排序数据的有序度对排序算法的执行效率有很大影响,所以分析时要区分这三种时间复杂度。除了时间复杂度分析,还要知道最好、最坏情况复杂度对应的要排序的原始数据是什么样的。
2)时间复杂度的系数、常数和低阶
时间复杂度反映的是算法执行时间随数据规模变大的一个增长趋势,平时分析时往往忽略系数、常数和低阶。但如果我们排序的数据规模很小,在对同一阶时间复杂度的排序算法比较时,就要把它们考虑进来。
3)比较次数和交换(移动)次数
内排序算法中,主要进行比较和交换(移动)两项操作,所以高效的内排序算法应该具有尽可能少的比较次数和交换次数。
1.2 排序算法的内存消耗
也就是分析算法的空间复杂度。这里还有一个概念—原地排序,指的是空间复杂度为O(1)的排序算法。
1.3 稳定性
如果待排序的序列中存在值相等的元素,经过排序之后,相等元素之间原有的先后顺序不变,那么这种排序算法叫做稳定的排序算法;如果前后顺序发生变化,那么对应的排序算法就是不稳定的排序算法。
在实际的排序应用中,往往不是对单一关键值进行排序,而是要求排序结果对所有的关键值都有序。所以,稳定的排序算法往往适用场景更广。
2 三种时间复杂度为O(n2)的排序算法
2.1 冒泡排序
2.1.1 原理
两两比较相邻元素是否有序,如果逆序则交换两个元素,直到没有逆序的数据元素为止。每次冒泡都会至少让一个元素移动到它应该在的位置。
2.1.2 实现
void BubbleSort(int *pData, int n)    //冒泡排序

{

    int temp = ;

    bool orderlyFlag = false;    //序列是否有序标志

    for (int i = ; i < n && !orderlyFlag; ++i)    //执行n次冒泡

    {

        orderlyFlag = true;

        for (int j = ; j < n -  - i; ++j)    //注意循环终止条件

        {

            if (pData[j] > pData[j + ])    //逆序

            {

                orderlyFlag = false;

                temp = pData[j];

                pData[j] = pData[j + ];

                pData[j + ] = temp;

            }

        }

    }

}
测试结果
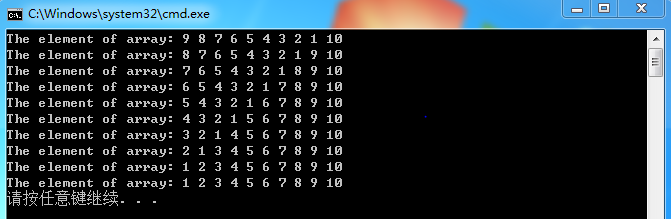
2.1.3 算法分析
1)时间复杂度
最好情况时间复杂度:当待排序列已有序时,只需一次冒泡即可。时间复杂度为O(n);
最坏情况时间复杂度:当待排序列完全逆序时,需要n次冒泡。时间复杂度为O(n2);
平均情况时间复杂度:当待排序列完全逆序时,逆序度为n * (n - 1) / 2。只有当交换逆序对时才会才会使得有序,取中间逆序度n * (n - 1) / 4,那么就要进行n * (n - 1) /4次交换,而比较的次数大于交换次数,所以平均情况时间复杂度为O(n2)。
2)空间复杂度
只借助了一个临时变量temp,所以空间复杂度为O(1)。
3)稳定性
该算法中只有交换操作会改变数据元素的顺序,只要我们在数据元素值相等时不交换数据元素,那么算法就是稳定的。
4)比较和交换的次数
交换操作的执行次数与逆序度相等,比较操作的执行次数大于等于逆序度小于等于n * (n - 1) / 2。
2.2 插入排序
2.2.1 原理
将待排序序列分为已排序区间和未排序区间,开始时已排序区间只有一个数据元素也就是序列的第一个元素,将未排序区间中的数据元素插入已排序区间中同时保持已排序区间的有序,直到未排序区间没有数据元素。
2.2.2 实现
void InsertSort(int *pData, int n)    //插入排序

{

    int temp = , i, j;

    for (i = ; i < n; ++i)    //未排序区间

    {

        if (pData[i] < pData[i - ])    //逆序

        {

            temp = pData[i];

            for (j = i - ; pData[j] > temp; --j)    //搬移数据元素

                pData[j + ] = pData[j];

            pData[j + ] = temp;    //插入数据

        }

    }

}
测试结果:

2.2.3 算法分析
1)时间复杂度
最好情况时间复杂度:当待排序列已有序时,只需遍历一次即可完成排序。时间复杂度为O(n);
最坏情况时间复杂度:当待排序列完全逆序时,需要进行n-1次数据搬移和插入操作。时间复杂度为O(n2);
平均情况时间复杂度:与冒泡法的分析过程一样,平均情况时间复杂度为O(n2)。
2)空间复杂度
排序过程中只需要一个临时变量存储待插入数据,空间复杂度为O(1)。
3)稳定性
插入排序过程中只有插入操作会改变数据元素的相对位置,只要元素大小比较时相等情况下不进行插入操作,插入排序算法就是稳定的。
4)比较操作和数据搬移操作执行次数
数据搬移操作执行次数和逆序度相同。比较操作次数大于等于逆序度,小于等于n * (n - 1) / 2。
2.3 选择排序
2.3.1 原理
选择排序的原理类似于插入排序都分为已排序区间和未排序区间,选择排序的已排序区间初始大小为零,每次从未排序区间取关键值最大(或最小)的数据元素放在已排序区间的后一个位置,直到未排序区间没有数据元素则完成排序。
2.3.2 实现
void SelectSort(int *pData, int n)    //选择排序

{

    int i, j, min, temp;

    for (i = ; i < n; ++i)    //未排序区间

    {

        min = i;    //最小值下标

        for (j = i + ; j < n; ++j)

        {

            if (pData[min] > pData[j])    //逆序

                min = j;    //保存当前较小值下标

        }

        if (i != min)    //如果不是最小值,交换元素

        {

            temp = pData[i];

            pData[i] = pData[min];

            pData[min] = temp;

        }

    }

}
测试结果:
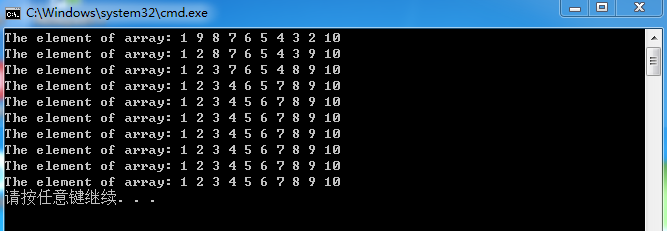
2.3.3 算法分析
1)时间复杂度
不管是已有序序列还是完全逆序序列,都要进行n次遍历无序区间操作,时间复杂度为O(n2)。
2)空间复杂度
排序过程中只需要保存每次遍历无序区间最小值的下标和第i个元素的数值,所以空间复杂度为O(1)。
3)稳定性
选择排序算法中改变数据元素相对位置的操作为交换操作,当第i次中第i个数据元素不为当前无序区间最小值时则和最小值交换数据元素。当有重复元素时,就有可能发生相对位置改变。例如5,3,4,5,1第一次选择操作后为1,3,4,5,5,此时两个5的相对位置已经改变。所以选择排序算法不是稳定的。
4)比较操作和交换操作的执行次数
比较操作执行次数为n * (n - 1) / 2,交换操作执行次数小于等于n-1。
2.4 三种算法之间的比较
1)一般待排序列长度n较小时,我们选择这三种排序算法;
2)当排序要求稳定时,一般选择插入排序,因为相同的情况下,移动数据比交换数据执行速度快;
3)当数据元素信息量较大时,可以考虑用选择排序,因为它交换操作执行次数最少。
该篇博客是自己的学习博客,水平有限,如果有哪里理解不对的地方,希望大家可以指正!
排序—时间复杂度为O(n2)的三种排序算法的更多相关文章
- JavaScript新手学习笔记3——三种排序方式(冒泡排序、插入排序、快速排序)
每种编程语言学到数组的时候,都会讲到排序算法,当时学C语言的时候,卡在排序算法.今天来总结一下javascript中如何实现三种排序算法. 1.冒泡排序(默认升序排列哦) 原理: 冒泡排序的原理,顾名 ...
- java数组中的三种排序方法中的冒泡排序方法
我记得我大学学java的时候,怎么就是搞不明白这三种排序方法,也一直不会,现在我有发过来学习下这三种方法并记录下来. 首先说说冒泡排序方法:冒泡排序方法就是把数组中的每一个元素进行比较,如果第i个元素 ...
- FIFO、LRU、OPT这三种置换算法的缺页次数
考虑下述页面走向: 1,2,3,4,2,1,5,6,2,1,2,3,7,6,3,2,1,2,3,6 当内存块数量分别为3时,试问FIFO.LRU.OPT这三种置换算法的缺页次数各是多少? 答:缺页定义 ...
- 基于C#程序设计语言的三种组合算法
目录 基于C#程序设计语言的三种组合算法 1. 总体思路 1.1 前言 1.2 算法思路 1.3 算法需要注意的点 2. 三种组合算法 2.1 普通组合算法 2.2 与自身进行组合的组合算法 2.3 ...
- 网络中,FIFO、LRU、OPT这三种置换算法的缺页次数
FIFO.LRU.OPT这三种置换算法的缺页次数 转载 由于要考计算机四级网络,这里遇到了问题,就搜了一些资料来解疑. 考虑下述页面走向: 1,2,3,4,2,1,5,6,2,1,2,3,7,6,3 ...
- 三种Hash算法对比以及秒传原理.
三种Hash算法对比以及秒传原理 CRC (32/64) MD5 Sha1 分5个点来说 1.校验值长度 2.校验值类别 3.安全级别 4.应用场景 1).校验值长度 CRC(32/64) 分别 ...
- 创建B树,动态添加节点,并使用三种遍历算法对树进行遍历
ks17:algorithm apple$ cat btree_test.c ///********************************************************** ...
- 手写面试编程题- 数组去重 深拷贝 获取文本节点 设置奇数偶数背景色 JS中检测变量为string类型的方法 第6题闭包 将两个数组合并为一个数组 怎样添加、移除、移动、复制、创建和查找节点? 继承 对一个数组实现随机排序 让元素水平 垂直居中的三种方式 通过jQuery的extend方法实现深拷贝
第1题==>实现数组去重 通过 new Set(数组名) // var arr = [12, 12, 3, 4, 5, 4, 5, 6, 6]; // var newarr1 = new Set ...
- JVM三种垃圾收集算法思想及发展过程
JVM垃圾收集算法的具体实现有很多种,本文只是介绍实现这些垃圾收集算法的三种思想和发展过程.所有的垃圾收集算法的具体实现都是遵循这三种算法思想而实现的. 1.标记-清除算法 标记-清除(Mark-Sw ...
随机推荐
- 《Unity3D/2D游戏开发从0到1》正式出版发行
<Unity3D/2D游戏开发从0到1>正式出版发行 去年个人编写的Unity书籍正式在2015年7月正式发行,现在补充介绍一下个人著作.书籍信息: 书籍的名称: <Uni ...
- Selenium的发展历史及原理
目录 1. selenium1.0的产生 2. webdriver的产生 3. selenium和webdriver的合并 4. selenium3.0的产生 1. selenium1.0的产生 为什 ...
- Docker最全教程之使用Tencent Hub来完成CI(九)
使用Tencent Hub来完成CI 关于Tencent Hub Tencent Hub是腾讯出品的DevOps服务.主要提供多存储格式的版本管理,支持Docker Image.Binary.Helm ...
- 【转载】解析 java 按值传递还是按引用传递
原文链接 说明: (1):“在Java里面参数传递都是按值传递”这句话的意思是:按值传递是传递的值的拷贝,按引用传递其实传递的是引用的地址值,所以统称按值传递. (2):在Java里面只有基本类型和 ...
- DSAPI QQ用户相关
获取指定QQ号头像 Label1.Image=DSAPI.QQ用户相关.下载QQ头像("20353841") 获取指定QQ群头像 Label1.Image = DSAPI.QQ用户 ...
- C#工具:WPF分页
1.使用ItemsControl控件 <UserControl x:Class="SunCreate.Vipf.Client.UI.CityDoor.PageControl" ...
- MyBatis缓存策略
MyBatis 提供了一级缓存和二级缓存策略,一级缓存是作用在SqlSession级别上的,而二级缓存则是作用在Mapper级别上的( 即作用在 namespace上),MyBatis 默认是开启的一 ...
- java自定义连接池
1.java自定义连接池 1.1连接池的概念: 实际开发中"获取连接"或“释放资源”是非常消耗系统资源的两个过程,为了姐姐此类性能问题,通常情况我们采用连接池技术来贡献连接Conn ...
- Spring注解AOP及单元测试junit(6)
2019-03-10/20:19:56 演示:将xml配置方式改为注解方式 静态以及动态代理推荐博客:https://blog.csdn.net/javazejian/article/details/ ...
- 基于Html5 Plus + Vue + Mui 移动App开发(三)-文件操作(读取、保存、更新数据)
随着手机的发展,现在越来越多的人选择在手机上看书.无论是专业书籍.文学.英语还是网络小说,在手机上看新闻成了人们处理零碎时间的办法.在智能手机里安装一个资讯APP,可以随时.随地查看自己想看的资讯 ...