
Scrapy实践----获取天气信息
scrapy是一个非常好用的爬虫框架,它是基于Twisted开发的,Twisted又是一个异步网络框架,既然它是异步的,那么执行起来肯定会很快,所以scrapy的执行速度也不会慢的!
如果你还没没有学过scrapy的话,那么我建议你先去学习一下,再来看这个小案例,毕竟这是基于scrapy来实现的!网上有很多有关scrapy的学习资料,你可以自行百度来学习!
接下来进入我们的正题:
如何利用scrapy来获取某个城市的天气信息呢?
我们爬取的网站是:天气网
城市我们可以自定义
1.创建项目名称
scrapy startproject weatherSpider
2.编写items.py文件
在这个文件中我们主要定义我们想要抓取的数据:
a.城市名(city)
b.日期(date)
c.天气状况(weather)
d.湿度(humidity)
e.空气质量(air_quality)
 import scrapy

 class WeatherspiderItem(scrapy.Item):
     """
     设置要爬取的信息
     """
     city = scrapy.Field()
     date = scrapy.Field()
     weather = scrapy.Field()
     humidity = scrapy.Field()
     air_quality = scrapy.Field()
3.打开网页
利用Chrome浏览器来提取上面5个信息
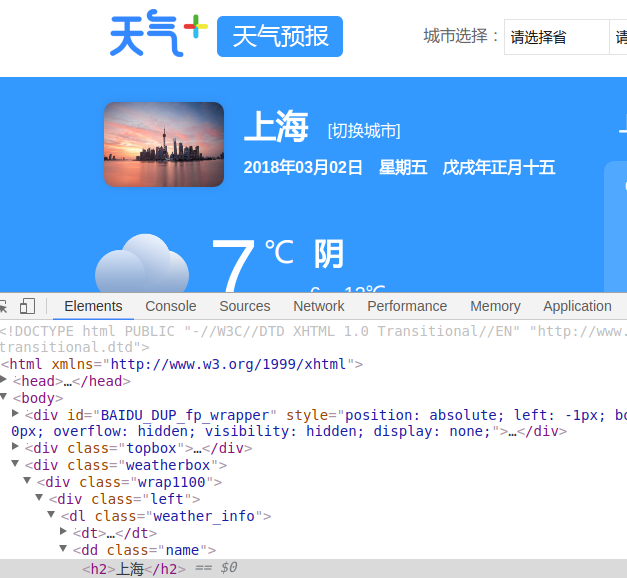
利用同样的方式我们可以找到其余4个信息个XPath表达式
4.编写爬虫文件
在第3步中我们已经找到我们想要的信息的XPath表达式了,我们就可以开始写代码了
 import scrapy
 from scrapy import loader

 from ..items import WeatherspiderItem

 class WeatherSpider(scrapy.Spider):
     name = 'weather'
     allowed_domains = ['tianqi.com']
     # 这是事先定义好的城市,我们还可以在里面添加其他城市名称
     cities = ['shanghai', 'hangzhou', 'beijing']
     base_url = 'https://www.tianqi.com/'
     start_urls = []
     for city in cities:
         start_urls.append(base_url + '{}'.format(city))

     def parse(self, response):
         """
         提取上海今天的天气信息
         :param response:
         :return:
         """
         # 创建一个ItemLoader,方便处理数据
         iloader = loader.ItemLoader(WeatherspiderItem(),response=response)
         iloader.add_xpath("city", '//dl[@class="weather_info"]//h2/text()')
         iloader.add_xpath('date', '//dl[@class="weather_info"]/dd[@class="week"]/text()')
         iloader.add_xpath('weather', '//dl[@class="weather_info"]/dd[@class="weather"]'
                                      '/p[@class="now"]/b/text()')
         iloader.add_xpath('weather', '//dl[@class="weather_info"]/dd[@class="weather"]'
                                      '/span/b/text()')
         iloader.add_xpath('weather', '//dl[@class="weather_info"]/dd[@class="weather"]'
                                      '/span/text()')
         iloader.add_xpath('humidity', '//dl[@class="weather_info"]/dd[@class="shidu"]'
                                       '/b/text()')
         iloader.add_xpath('air_quality', '//dl[@class="weather_info"]/dd[@class="kongqi"]'
                                          '/h5/text()')
         iloader.add_xpath('air_quality', '//dl[@class="weather_info"]/dd[@class="kongqi"]'
                                          '/h6/text()')
         return iloader.load_item()
如果觉得困惑为何要使用ItemLoader的话,建议去读一下关于ItemLoader的官方文档:传送门
5.结果保存为JSON格式
要想把我们提取的结果保存到某种文件中,我们需要编写pipelines
 import os
 import json

 class StoreAsJson(object):
     def process_item(self, item, spider):
         # 获取工作目录
         pwd = os.getcwd()
         # 在当前目录下创建文件
         filename = pwd + '/data/weather.json'

         with open(filename, 'a') as fp:
             line = json.dumps(dict(item), ensure_ascii=False) + '\n'
             fp.write(line)
6.添加设置信息
我们写的pipelines文件要起作用,需要在settings.py中设置
 ITEM_PIPELINES = {
     'WeatherSpider.pipelines.StoreAsJson': 300,
 }
7.启动爬虫
scrapy crawl wether
8.参考资料
从零开始写Python爬虫 --- 2.3 爬虫实践:天气预报&数据存储
如果大家喜欢的话,请点个赞!!O(∩_∩)O
Scrapy实践----获取天气信息的更多相关文章
- 半吊子学习Swift--天气预报程序-获取天气信息
昨天申请的彩云天气Api开发者今天上午已审核通过  饭后运动过后就马不停蹄的来测试接口,接口是采用经纬度的方式来获取天气信息,接口地址如下 https://api.caiyunapp.com/v2/ ...
- 内网公告牌获取天气信息解决方案(C# WebForm)
需求:内网公告牌能够正确显示未来三天的天气信息 本文关键字:C#/WebForm/Web定时任务/Ajax跨域 规划: 1.天定时读取百度接口获取天气信息并存储至Txt文档: 2.示牌开启时请求Web ...
- C#调用WebService获取天气信息
概述 本文使用C#开发Winform应用程序,通过调用<WebXml/>(URL:http://www.webxml.com.cn)的WebService服务WeatherWS来获取天气预 ...
- java获取天气信息
通过天气信息接口获取天气信息,首先要给项目导入程序所需要的包,具体需要如下几个包: json-lib-2.4.jar ezmorph-1.0.6.jar commons-beanutils-1.8.3 ...
- Kettle通过Webservice获取天气信息
Kettle通过Webservice获取天气信息 需求: 通过kettle工具,通过webservice获取天气信息,写成xml格式文件. 思路: Kettle可通过两种选择获取webservic ...
- Java通过webservice接口获取天气信息
通过SOAP请求的方式获取天气信息并解析返回的XML文件. 参考: http://www.webxml.com.cn/WebServices/WeatherWS.asmx import java.io ...
- ajax无刷新获取天气信息
浏览器由于安全方面的问题,禁止ajax跨域请求其他网站的数据,但是可以再本地的服务器上获取其他服务器的信息,在通过ajax请求本地服务来实现: <?php header("conten ...
- Android实现自动定位城市并获取天气信息
定位实现代码: <span style="font-size:14px;">import java.io.IOException; import java.util.L ...
- java解析xml实例——获取天气信息
获取xml并解析其中的数据: package getweather.xml; import java.io.IOException; import java.util.HashMap; import ...
随机推荐
- 在 CentOS7 上安装 RabbitMQ 消息队列中间件
RabbitMQ 是流行的开源消息队列系统,是 AMQP(Advanced Message Queuing Protocol 高级消息队列协议)的标准实现,用 erlang 语言开发.RabbitMQ ...
- vue 教程
1.安装 nodejs,检测 nodejs 环境(node -v). 2.安装vue-cli脚手架npm install vue-cli -g 3.在电脑的某个盘中创建项目,之后进入该项目. 4.初始 ...
- python中强大优雅的列表推导表达式
推导表达式其实就是简化一些循环判断操作等 生成一个数字1-10的列表,可以有多少种方法? >>> l = [ 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 ] > ...
- python学习之老男孩python全栈第九期_day004知识点总结
1. 列表list: 列表转换成字符串: s = 'kidd' s1 = '_'.join(s) # 用_连接 字符串转换成列表: split() range(头,尾,步长): [0,1,2,3,4, ...
- jQuery中hover方法和toggle方法使用指南
jQuery提供一些方法(如:toggle)将两种事件效果合并到一起,比如:mouseover.mouseout:keyup.keydown等 1.hover函数 hover(over,out)一个模 ...
- HTML中的元素分类
HTML中有很多的标签(元素),可以按照这些元素在网页中所占的空间情况进行分类.具体可以这样简单的分类: 1.块级元素:指的是在网页中该元素独自占据网页的一行显示区域,即当使用了该元素后,该元素会使下 ...
- CentOS6.5搭建ldap及pdc的过程
linux centos6.5,,配置的是本地yum,采用光盘自带的rpm包进行安装 安装openldap server 以及client yum install openldap-server ...
- JavaSE——序列化和反序列化
序列化: 序列化对应写的操作.(读与写都是站在应用的角度上) 序列化就是一种用来处理对象流的机制,所谓对象流也就是将对象的内容进行流化.可以对流化后的对象进行读写操作,也可将流化后的对象传输于网络之间 ...
- Linux CentOS下Python+robot framework环境搭建
Linux CentOS下Python+robot framework环境搭建 by:授客 QQ:1033553122 操作系统环境:CentOS 6.5-x86_64 下载地址:http://w ...
- Linux 释放Linux 系统预留的硬盘空间
释放 Linux 系统预留的硬盘空间 by:授客 QQ:1033553122 大多数文件系统都会保留一部分空间作为紧急情况时用(比如硬盘空间满了),这样能保证有些关键应用(比如数据库)在硬盘满的时 ...