
python:序列化与数据持久化
数据持久化的方式有:
1.普通文件无格式写入:将数据直接写入到文件中
2.普通序列化写入:json,pickle
3.DBM方式:shelve,dbm
相关内容:
- json
- pickle
- shelve
- dbm
首发时间:2018-02-23 20:52
json:
介绍:
按照指定格式【比如格式是字典,那么文件中就是字典】将数据明文写入到文件中,类型是bytes的,比如”中文“就会变成Unicode编码

用法:
- 首先要导入模块import json
- 序列化:
- json.dump(序列化对象,文件对象)
- json.dumps(序列化对象),返回值是一个字符串,需要手动将这个字符串写入到文件中
print("------json序列化--------")

import json

import time

info={

    'date':time.localtime(),

    'name':'中文'

}

f=open("test.txt","w")

print("---------dump---------")

# json.dump(info,f)

# f.close()

print("---------dumps,---------")

f.write(json.dumps(info))

f.close()
- 反序列化:
- json.load(文件对象)
- json.loads(字符串)
print("------反序列化--------")

import json

f=open("test.txt","r")

print("-------load----------")

# data=json.load(f)#1

# print(data)

print("-------loads----------")

d2=json.loads(f.read())

print(d2)

f.close()
对于多次dump\dumps,如何load\loads取出来:
- 需要在dump的时候,手动对数据进行划分
print("------json序列化--------")

import json

import time

info={

    'date':time.localtime(),

    'name':'中文'

   # 'func':hello #注:json不可序列化函数

}

info2=['1',2,3,4]

f=open("test.txt","w")

print("---------dumps,---------")#用'\n'来区分两份数据

f.write(json.dumps(info)+"\n")

f.write(json.dumps(info2)+"\n")

f.close()
import json

with open("test.txt") as f:

    a=json.loads(f.readline())

    b=json.loads(f.readline())

    print(a,b)
pickle:
介绍:
- 用于实现Python数据类型与Python特定二进制格式之间的转换
- 参数protocol规定了序列化的协议版本,默认情况下使用pikkle序列化数据是bytes的,打开文件的方式必须为二进制格式
用法:
- 首先导入模块import pickle
- 序列化:
- pickle.dump(序列化对象,文件对象)
- pickle.dumps(序列化对象),返回值是一个字符串,需要手动将这个字符串写入到文件中
import pickle

info={

    'name':'1',

    'age':2,

}

f=open("test2.txt","wb")

pickle.dump(info,f)#序列化方法1

# f.write(pickle.dumps(info))#序列化方法2

f.close()
- 反序列化:
- pickle.load(文件对象)
- pickle.loads(字符串)
print("------反序列化--------")

import pickle

f=open("test2.txt","rb")

data=pickle.loads(f.read())#反序列方法1

print(data)

# data=pickle.load(f)#反序列方法2

# print(data)

f.close()
shelve:
介绍:
- 专门用于将Python数据类型的数据持久化到磁盘,操作类似于dict
用法:
- 首先导入模块import
- shelve打开一个文件: shelve文件对象 = shelve.open(文件名)
- 写入:shelve文件对象[key]=value
- 读出:shelve文件对象.get(key)
import shelve,time

d = shelve.open('shelve_test')  # 打开一个文件

print("----------写----------")

info ={"name":'lilei',"sex":"man"}

name = ["autuman", "zhangsan", "lisi"]

d["teacher"] = name

d["student"] = info

d["date"] = time.ctime()

print("--------读------------")

print(d.get("teacher"))

print(d.get("student"))

print(d.get("date"))

d.close()
shelve可以很方便的序列化自定义的数据类型、函数:
import shelve,time

class A:

    def hello(self):

        print("123")

d = shelve.open('shelve_test')  # 打开一个文件

print("----------写----------")

d['class'] =A

print("--------读------------")

a=d.get('class')()

a.hello()

d.close()
dbm:
介绍:
- dbm与shelve非常类似,但dbm的键和值必须是字符串类型
- dbm默认写入的数据是bytes的,将所有字符串都序列化成bytes的
用法:
- 首先导入模块imort dbm【注意的是由很多个不同的dbm,可以选择来使用,这里使用默认】
- 打开文件:dbm对象=dbm.open(文件名,打开模式)
- 写入:dbm对象[key]=value
- 读取: dbm对象[key]
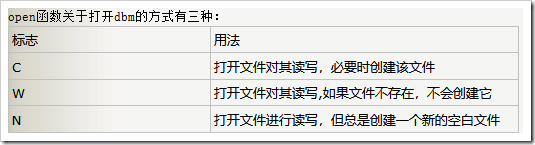
import dbm

db=dbm.open("test.txt","c")

print("写".center(50,'-'))

db["name"]="1111111111112"

db["name2"]="2222222222222"

print("读".center(50,'-'))

print(db["name"])

print(db["name2"])

db.close()
python:序列化与数据持久化的更多相关文章
- python序列化(数据本地存放持久性存储)和反序列化
http://blog.csdn.net/uestcyao/article/details/7874817 #读取图片并存储为矩阵 from scipy.misc import imread im = ...
- python学习总结----内置函数及数据持久化
抽象基类(了解) - 说明: - 抽象基类就是为了统一接口而存在的 - 它不能进行实例化 - 继承自抽象类的子类必须实现抽象基类的抽象方法 - 示例: from abc import ABC, abs ...
- iphone开发中数据持久化之——属性列表序列化(一)
数据持久化是应用程序开发过程中的一个基本问题,对应用程序中的数据进行持久化存储,有多重不同的形式.本系列文章将介绍在iphone开发过程中数据持久化的三种主要形式,分别是属性列表序列号.对象归档化以及 ...
- NSFileManager(沙盒文件管理)数据持久化 <序列化与反序列化>
iOS应用程序只能在为该改程序创建的文件中读取文件,不可以去其它地方访问,此区域被成为沙盒,所以所有的非代码文件都要保存在此,例如图像,图标,声音,映像,属性列表,文本文件等. 默认情况下 ...
- python中后端数据序列化不显示中文的解决方法
我们在前后端交互的时候,让序列化的数据更友好的显示,我们会用到 import json js = json.loads('{"name": "多多"}') pr ...
- python 序列化之JSON和pickle详解
JSON模块 JSON(JavaScript Object Notation) 是一种轻量级的数据交换格式.它基于ECMAScript的一个子集. JSON采用完全独立于语言的文本格式,但是也使用了类 ...
- Python序列化和反序列化
Python序列化和反序列化 通过将对象序列化可以将其存储在变量或者文件中,可以保存当时对象的状态,实现其生命周期的延长.并且需要时可以再次将这个对象读取出来.Python中有几个常用模块可实现这一功 ...
- python序列化pickle/cPickle
一.pickle/Cpickle简介 Python序列化的概念很简单.内存里面有一个数据结构,你希望将它保存下来,重用,或者发送给其他人.你会怎么做?这取决于你想要怎么保存,怎么重用,发送给谁.很多游 ...
- python序列化与反序列
python序列化与反序列 在python中提供了两个模块可进行序列化.分别是pickle和json.他们两者的功能都差不多,dumps和dump都是进行序列化,而loads和load则是反序列化. ...
随机推荐
- 源码调试debug_info 的作用和使用方法
在他通过gcc来编译程序时,在map文件中,经常会遇到如下的情况: .debug_info 0x002191b6 0x1aa9 XXX .debug_info 0x0021ac5f 0xce4 XXX ...
- 机器学习技法笔记:10 Random Forest
Roadmap Random Forest Algorithm Out-Of-Bag Estimate Feature Selection Random Forest in Action Summar ...
- Maven Optional & Exclusions 使用区别
Optional和Exclusions都是用来排除jar包依赖使用的,两者在使用上却是相反. Optional定义后,该依赖只能在本项目中传递,不会传递到引用该项目的父项目中,父项目需要主动引用该依赖 ...
- java几种垃圾收集方法和垃圾收集器
标记清除法: 分为两个阶段,标记----清除 标记阶段将所有需要回收的对象做标记,然后在清除阶段将所有的标记对象回收 但是这种回收方法有很大的缺点,那就是这两个过程的的效率并不高,两个过程都是效率很低 ...
- oc中的oop基础及类的基本介绍
面向对象的(OOP)的基础知识 类(class):表示一组对象数据的结构体,对象通类来得到自身.类名首字母大写. 对象(objcet):是一种包含值和指向其类的隐藏指针的结构体.运行中的程序中通常会有 ...
- Android_自适应布局
1.屏幕相关概念1.1分辨率是指屏幕上有横竖各有多少个像素1.2屏幕尺寸指的是手机实际的物理尺寸,比如常用的2.8英寸,3.2英寸,3.5英寸,3.7英寸android将屏幕大小分为四个级别(smal ...
- 从零开始学 Web 之 Vue.js(三)Vue实例的生命周期
大家好,这里是「 从零开始学 Web 系列教程 」,并在下列地址同步更新...... github:https://github.com/Daotin/Web 微信公众号:Web前端之巅 博客园:ht ...
- DataGridView样式生成器使用说明
啥都不说先看图 一. 功能介绍 1. winform DataGridView样式代码可视化即时生成,所见即所得 2. 预置DataGridView样式代码方案 预置三 ...
- ajax读取txt文本时乱码的解决方案
前言:第一次学习使用 ajax 就是用来读取文本 先给出现乱码的代码<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional/ ...
- vue.js 使用时间组件 日期少一天的问题
<el-form :inline="true" class="demo-form-inline padding-top-20"> <el-fo ...