
flink solt,并行度
转自:https://www.jianshu.com/p/3598f23031e6
简介
Flink运行时主要角色有两个:JobManager和TaskManager,无论是standalone集群,flink on yarn都是要启动这两个角色。JobManager主要是负责接受客户端的job,调度job,协调checkpoint等。TaskManager执行具体的Task。TaskManager为了对资源进行隔离和增加允许的task数,引入了slot的概念,这个slot对资源的隔离仅仅是对内存进行隔离,策略是均分,比如taskmanager的管理内存是3GB,假如有两个个slot,那么每个slot就仅仅有1.5GB内存可用。Client这个角色主要是为job提交做些准备工作,比如构建jobgraph提交到jobmanager,提交完了可以立即退出,当然也可以用client来监控进度。
Jobmanager和TaskManager之间通信类似于Spark 的早期版本,采用的是actor系统。如下图

什么是task?
在spark中:
RDD中的一个分区对应一个task,task是单个分区上最小的处理流程单元。被送到某个Executor上的工作单元,和hadoopMR中的MapTask和ReduceTask概念一样,是运行Application的基本单位,多个Task组成一个Stage
上述引入spark的task主要是想带着大家搞明白,以下几个概念:
Flink的并行度由什么决定的?
Flink的task是什么?
Flink的并行度由什么决定的?
这个很简单,Flink每个算子都可以设置并行度,然后就是也可以设置全局并行度。
Api的设置
.map(new RollingAdditionMapper()).setParallelism(10)
全局配置在flink-conf.yaml文件中,parallelism.default,默认是1:可以设置默认值大一点

Flink的task是什么?
按理说应该是每个算子的一个并行度实例就是一个subtask-在这里为了区分暂时叫做substask。那么,带来很多问题,由于flink的taskmanager运行task的时候是每个task采用一个单独的线程,这就会带来很多线程切换开销,进而影响吞吐量。为了减轻这种情况,flink进行了优化,也即对subtask进行链式操作,链式操作结束之后得到的task,再作为一个调度执行单元,放到一个线程里执行。如下图的,source/map 两个算子进行了链式;keyby/window/apply有进行了链式,sink单独的一个。

说明:图中假设是source/map的并行度都是2,keyby/window/apply的并行度也都是2,sink的是1,总共task有五个,最终需要五个线程。
默认情况下,flink允许如果任务是不同的task的时候,允许任务共享slot,当然,前提是必须在同一个job内部。
结果就是,每个slot可以执行job的一整个pipeline,如上图。这样做的好处主要有以下几点:
1.Flink 集群所需的taskslots数与job中最高的并行度一致。也就是说我们不需要再去计算一个程序总共会起多少个task了。
2.更容易获得更充分的资源利用。如果没有slot共享,那么非密集型操作source/flatmap就会占用同密集型操作 keyAggregation/sink 一样多的资源。如果有slot共享,将基线的2个并行度增加到6个,能充分利用slot资源,同时保证每个TaskManager能平均分配到重的subtasks,比如keyby/window/apply操作就会均分到申请的所有slot里,这样slot的负载就均衡了。
链式的原则,也即是什么情况下才会对task进行链式操作呢?简单梗概一下:
上下游的并行度一致
下游节点的入度为1 (也就是说下游节点没有来自其他节点的输入)
上下游节点都在同一个 slot group 中(下面会解释 slot group)
下游节点的 chain 策略为 ALWAYS(可以与上下游链接,map、flatmap、filter等默认是ALWAYS)
上游节点的 chain 策略为 ALWAYS 或 HEAD(只能与下游链接,不能与上游链接,Source默认是HEAD)
两个节点间数据分区方式是 forward(参考理解数据流的分区)
用户没有禁用 chain
slot和parallelism
1.slot是指taskmanager的并发执行能力
在hadoop 1.x 版本中也有slot的概念,有兴趣的读者可以了解一下

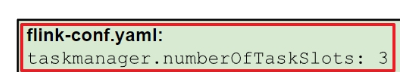
taskmanager.numberOfTaskSlots:3
每一个taskmanager中的分配3个TaskSlot,3个taskmanager一共有9个TaskSlot
2.parallelism是指taskmanager实际使用的并发能力

parallelism.default:1
运行程序默认的并行度为1,9个TaskSlot只用了1个,有8个空闲。设置合适的并行度才能提高效率。
3.parallelism是可配置、可指定的

1.可以通过修改$FLINK_HOME/conf/flink-conf.yaml文件的方式更改并行度
2.可以通过设置$FLINK_HOME/bin/flink 的-p参数修改并行度
3.可以通过设置executionEnvironmentk的方法修改并行度
4.可以通过设置flink的编程API修改过并行度
5.这些并行度设置优先级从低到高排序,排序为api>env>p>file.
6.设置合适的并行度,能提高运算效率
7.parallelism不能多与slot个数。
slot和parallelism总结
1.slot是静态的概念,是指taskmanager具有的并发执行能力
2.parallelism是动态的概念,是指程序运行时实际使用的并发能力
3.设置合适的parallelism能提高运算效率,太多了和太少了都不行
4.设置parallelism有多中方式,优先级为api>env>p>file
----------------------------------------------------------------------------------------
当solt不够怎么办,修改配置文件flink-conf.yaml: solt数 = 3* taskmanager数
flink solt,并行度的更多相关文章
- Flink Task 并行度
并行的数据流 Flink程序由多个任务(转换/运算符,数据源和接收器)组成,Flink中的程序本质上是并行和分布式的. 在执行期间,流具有一个或多个流分区,并且每个operator具有一个或多个ope ...
- Flink并行度
并行执行 本节介绍如何在Flink中配置程序的并行执行.FLink程序由多个任务(转换/操作符.数据源和sinks)组成.任务被分成多个并行实例来执行,每个并行实例处理任务的输入数据的子集.任务的并行 ...
- Flink-Kafka-Connector Flink结合Kafka实战
戳更多文章: 1-Flink入门 2-本地环境搭建&构建第一个Flink应用 3-DataSet API 4-DataSteam API 5-集群部署 6-分布式缓存 7-重启策略 8-Fli ...
- Apache Beam实战指南 | 手把手教你玩转KafkaIO与Flink
https://mp.weixin.qq.com/s?__biz=MzU1NDA4NjU2MA==&mid=2247492538&idx=2&sn=9a2bd9fe2d7fd6 ...
- Flink on YARN时,如何确定TaskManager数
转自: https://www.jianshu.com/p/5b670d524fa5 答案写在最前面:Job的最大并行度除以每个TaskManager分配的任务槽数. 问题 在Flink 1.5 Re ...
- flink基础篇
Flink面试--核心概念和基础考察 1.简单介绍一下 Flink 2.Flink 相比传统的 Spark Streaming 有什么区别? 3.Flink 的组件栈有哪些? 面试知识 ...
- 带你认识FusionInsight Flink:既能批处理,又能流处理
摘要:本文主要介绍了FusionInsight Flink组件的基本原理.Flink任务提交的常见问题.以及最佳实践FAQ. 本文分享自华为云社区<FusionInsight HD Flink组 ...
- Alink漫谈(五) : 迭代计算和Superstep
Alink漫谈(五) : 迭代计算和Superstep 目录 Alink漫谈(五) : 迭代计算和Superstep 0x00 摘要 0x01 缘由 0x02 背景概念 2.1 四层执行图 2.2 T ...
- Flink架构分析之资源分配
Task Slot Flink中每个真正执行任务的TaskManager都是一个JVM进程,其在多线程环境中执行一个或者多个子任务.为了控制一个JVM同时能运行的任务数量,flink引入了ta ...
随机推荐
- IT兄弟连 Java语法教程 位运算符
Java定义了几个位运算符,它们都可以用于整数类型(long.int.short.byte以及char).这些运算符对操作数的单个位进行操作.表1 对位运算符进行了总结. 表1 位运算符 由于位运算 ...
- 【计算机网络】UDP基础知识总结
1. UDP概念相关 [!NOTE] UDP(User Datagram Protocol),又叫用户数据报协议. UDP是一个无连接的.不可靠.基于数据报的传输协议.UDP只是报文(报文可以理解为一 ...
- git 创建分支 提交到远程分支
git 创建分支 并 提交到远程分支 git branch 0.可以通过git branch -r 命令查看远端库的分支情况 1,从已有的分支创建新的分支(如从master分支),创建一个dev分支 ...
- mosquitto配置文件
#配置文件为mosquitto #参见mosquitto.conf(5)了解更多信息. #显示默认值,取消注释以更改. #使用#字符来表示注释,但只有当它是 #第一个字符就行了. #========= ...
- 用Python制作只属于你和ta的聊天渠道吧
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: Python应用宝典 PS:如有需要Python学习资料的小伙伴可 ...
- Element-ui中ElScrollBar组件滚动条的使用
在翻看 element-ui官网的文档时,发现其左侧导航和右边的内容超出屏幕时,滚动条的样式比较小巧,通过浏览器审查工具查看,发现它是使用了el-scrollbar的样式,跟element-ui的组件 ...
- Cesium-空间分析之通视分析(附源码下载)
Cesium Cesium 是一款面向三维地球和地图的,世界级的JavaScript开源产品.它提供了基于JavaScript语言的开发包,方便用户快速搭建一款零插件的虚拟地球Web应用,并在性能,精 ...
- python_正则表达式学习
re.match()函数: 函数语法: re.mathch ( pattern , string , flags = 0) 参数说明: pattem 匹配的正则表达式 string 要匹配的字符串 f ...
- pyecharts和echarts的混合使用
ECharts是一个由百度开发的纯 Javascript 的图表库,pyecharts是某三位大佬将ECharts移植到Python项目中的产物,在Python网站中可以更轻松的接入图表,但是个人感觉 ...
- hive的metatable学习
一.存储Hive版本的元数据表(VERSION)   二.Hive数据库相关的元数据表(DBS.DATABASE_PARAMS) DBS --存储Hive中所有数据库的基本信息   DATAB ...