
MapReduce – 基本思路之推荐引擎
理解MapReduce关键两个步骤;
首先是构想出结构的数据结构,这种数据结构可以支撑你的业务分析使用;是要理解这种模式的处理元素。
第二步,分析原始数据的结构是怎样的;
第三步,基于原始数据结构以及目标数据结构,在分析map的实现逻辑,返回值什么,sort-shuffle之后的值什么,这个值也是reduce的入口参数,然后是reduce的逻辑是什么,以符合目标结构;
map和reduce在处理数据上面的很大差别在于map之后会有一个汇总过程,按照key进行汇聚(发生在sort-shuffle阶段);reduce产生的数据不会再有这个过程,产生的是什么数据,加入到集合中之后,这个数据集合再无其他操作;如果再次把这个数据集合作为下一个阶段的Map-Reduce。
对于"购买过该商品的用户还购买了哪些商品",这个需求,分析过程如下:
0. 目标数据结构是:key:商品(主体);value:关联商品+权值(数量)列表;
1. 实现要明白map的入口参数是什么样子,用户对应一个商品;
2. 分析一下map之后数据,是一个商品对应多个商品;
3. shuffle没有什么特别处理;
3. reduce没有什么特别处理;
下面是第二轮mapreduce:
1. 入口参数是一个用户对多个商品;
2. map返回值某个用户的某个商品对应多个相关联的商品;
3. map之后shuffle合并是个集合,集合中的元素是:key是某个商品,value是相关联的商品List,此时这个list里面可能会有很多重复项;
4. reduce的入口参数是上步中介绍的内容;reduce处理之后,变成了key:某个商品;value:关联商品以及该商品的累加个数;
下面的是应用:基于reduce处理的数据,我们可以获得某个商品关联度最高的前N个商品(累加个数最高的N的)
处理的全流程如下图所示:
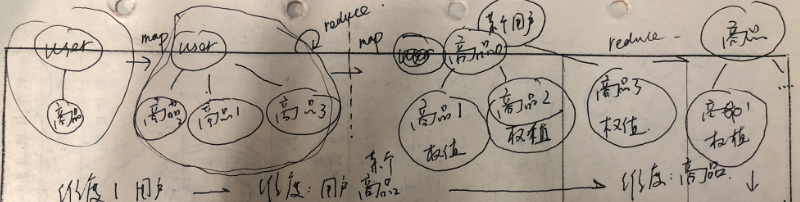
注意其实处理的维度的变化,阶段1map的处理维度还是在user;到了阶段儿的map处理维度是用户+商品,到了阶段2的reduce就抛弃了用户了,而是完全在商品的维度了;reduce的一个功能就是"降维",这个是我的一个说法,其实"降维"是指原本的key不管了,而是从value中在建立一套key-value数据结构;因为reduce功能是group,group意味着可以抛弃一个数据维度,或者说忽略某些个数据维度。
继续,对于"经常一起购买的商品":
0. 构想目标数据结构:key:商品;value:关联商品+权值列表;
1. 你要原始的数据集合中,一条记录的结构是交易-产品列表;
2. 在map阶段,直接"降维",抛弃key(交易ID),对于产品列表做两两配对;shuffle之后的数据集合的元素结构是[<p1,p2>, 1];
3. 到了reduce阶段,就是按照<p1, p2>进行汇聚,输出的是数据集合的元素结构是[<p1, p2>, n];
应用:
找到p1=XX,n最高的3个产品作为推荐。
第三波,难度比较大了,推荐好友,A和B是好友,B是C的好友,那么AC要双向推荐一下。
我最初的想法是做差集;A-B的人向B做推荐,B-A的人想A做推荐;但是这样算法无法获取共同好友,我们登录QQ看到推荐的时候,一般都会看到你和以下人是好友;
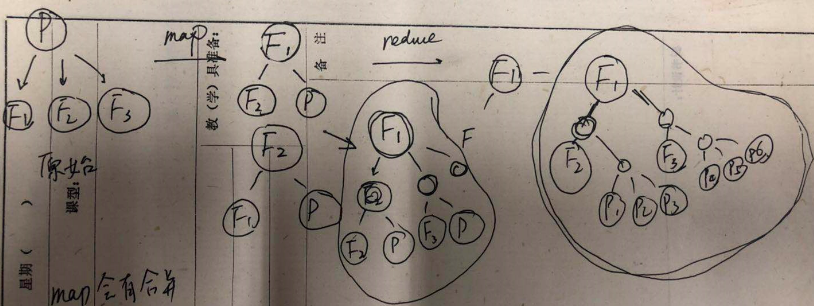
0. 构想目标数据结构,key:主体人,value:[推 荐者,List<共同好友>]
1. 原始数据结构:key:主体人,value:List<Friends>
2. map输出的是key:被推荐人;value:[推荐好友, 共同好友(入参的主体人)];shuffle之后是key是推荐人;value推荐好友列表;
3. reduce逻辑则是将被推荐人的推荐好友叠加到List中,同时叠加该推荐好友的共同朋友;
MapReduce – 基本思路之推荐引擎的更多相关文章
- PredictionIO+Universal Recommender快速开发部署推荐引擎的问题总结(3)
PredictionIO+Universal Recommender虽然可以帮助中小企业快速的搭建部署基于用户行为协同过滤的个性化推荐引擎,单纯从引擎层面来看,开发成本近乎于零,但仍然需要一些前提条件 ...
- 简易推荐引擎的python实现
代码地址如下:http://www.demodashi.com/demo/12913.html 主要思路 使用协同过滤的思路,从当前指定的用户过去的行为和其他用户的过去行为的相似度进行相似度评分,然后 ...
- 机器学习 101 Mahout 简介 建立一个推荐引擎 使用 Mahout 实现集群 使用 Mahout 实现内容分类 结束语 下载资源
机器学习 101 Mahout 简介 建立一个推荐引擎 使用 Mahout 实现集群 使用 Mahout 实现内容分类 结束语 下载资源 相关主题 在信息时代,公司和个人的成功越来越依赖于迅速 ...
- 数据算法 --hadoop/spark数据处理技巧 --(7.共同好友 8. 使用MR实现推荐引擎)
七,共同好友. 在所有用户对中找出“共同好友”. eg: a b,c,d,g b a,c,d,e map()-> <a,b>,<b,c,d,g> ;< ...
- 从源代码剖析Mahout推荐引擎
转载自:http://blog.fens.me/mahout-recommend-engine/ Hadoop家族系列文章,主要介绍Hadoop家族产品,常用的项目包括Hadoop, Hive, Pi ...
- 基于Azure构建PredictionIO和Spark的推荐引擎服务
基于Azure构建PredictionIO和Spark的推荐引擎服务 1. 在Azure构建Ubuntu 16.04虚拟机 假设前提条件您已有 Azure 帐号,登陆 Azure https://po ...
- [转] 基于 Apache Mahout 构建社会化推荐引擎
来源:http://www.ibm.com/developerworks/cn/java/j-lo-mahout/index.html 推荐引擎简介 推荐引擎利用特殊的信息过滤(IF,Informat ...
- 基于Spark ALS构建商品推荐引擎
基于Spark ALS构建商品推荐引擎 一般来讲,推荐引擎试图对用户与某类物品之间的联系建模,其想法是预测人们可能喜好的物品并通过探索物品之间的联系来辅助这个过程,让用户能更快速.更准确的获得所需 ...
- JVM调优(这里主要是针对优化基于分布式Mahout的推荐引擎)
优化推荐系统的JVM关键参数 -Xmx 设定Java允许使用的最大堆空间.例如-Xmx512m表示堆空间上限为512MB -server 现代JVM有两个重要标志:-client和-server,分别 ...
随机推荐
- es-hadoop saveToEsWithMeta
@Test def testEsRDDWriteWithDynamicMapping() { val doc1 = Map("one" -> null, "two& ...
- 使用python,将excel数据批量导入数据库
这是上一篇文章的优化版本,相较于一条一条的执行sql语句,本文中,将excel中所有的数据先写到list列表中 在通过函数 cursor.executemany(sql, list) 一次性写入到数据 ...
- 修改cmd窗口mysql的提示符:
mysql提示符: \D 完整的日期 \d 当前数据库 \h 服务器地址 \u 当前用户 登录数据库的时候设置提示符: mysql -uroot -proot --promp ...
- 使用word2013写博客
额额 要使用的话首先要配置一下: 选择word2013的创建,然后点击模版,搜索博客. 然后就是创建账户了,账户主要填写的下面这些信息: 注意,cnblogs后面的子域名应该使用你自己的子域名 下面 ...
- 玩转X-CTR100 l STM32F4 l DRV8825 A4988 步进电机控制
我造轮子,你造车,创客一起造起来!塔克创新资讯[塔克社区 www.xtark.cn ][塔克博客 www.cnblogs.com/xtark/ ] 本文介绍X-CTR100控制器控制步进电机 ...
- 集成学习之Boosting —— XGBoost
集成学习之Boosting -- AdaBoost 集成学习之Boosting -- Gradient Boosting 集成学习之Boosting -- XGBoost Gradient Boost ...
- windows : Jmeter自动化测试-eclipse+maven+jmeter
前提 在window上已经安装maven并且在eclipse中配置好了maven,如果没有配置,参考文章 windows上安装maven及eclipse中配置maven 一.创建一个包含jmete ...
- oracle 统计sql
最近在研究项目时发现如下sql, select 3 agentOfGCount, 0 workingCount, 0 restingCount, 0 busyingCount, 0 connectin ...
- CMS垃圾回收
最近在学习JVM和GC调优,今天总结下CMS的一些特点和要点,让我们先简单的看下整个堆年轻代和年老代的垃圾收集器组合(以下配合java8完美支持,其他版本可能稍有不同),其中标红线的则是我们今天要着重 ...
- 【Android 】查看被测应用程序package和launchable-activity
[appt] appt 工具所在位置..\sdk\build-tools\23.0.1\aapt.exe #查看Package>aapt dump badging C:\QQemail.apk ...